Еще несколько лет назад системы искусственного интеллекта, как правило, работали с одним типом данных — текстом, изображением или звуком. Сегодня мультимодальные ИИ объединяют эти потоки в единой архитектуре и формируют связанное понимание ситуации. Такие модели анализируют документы с графиками, интерпретируют фотографии с учетом текстового контекста и обрабатывают аудио совместно с визуальными сигналами. Технологической основой остаются масштабируемые нейронные сети, однако меняется принцип их применения: вместо изолированной обработки формируется целостная картина на основе нескольких источников данных.
Этот сдвиг меняет саму логику построения ИИ: от узкоспециализированных моделей к системам, способным работать с реальной, разнородной информацией. Мультимодальность становится доминирующим направлением развития следующего поколения интеллектуальных решений.
Что такое мультимодальные ИИ
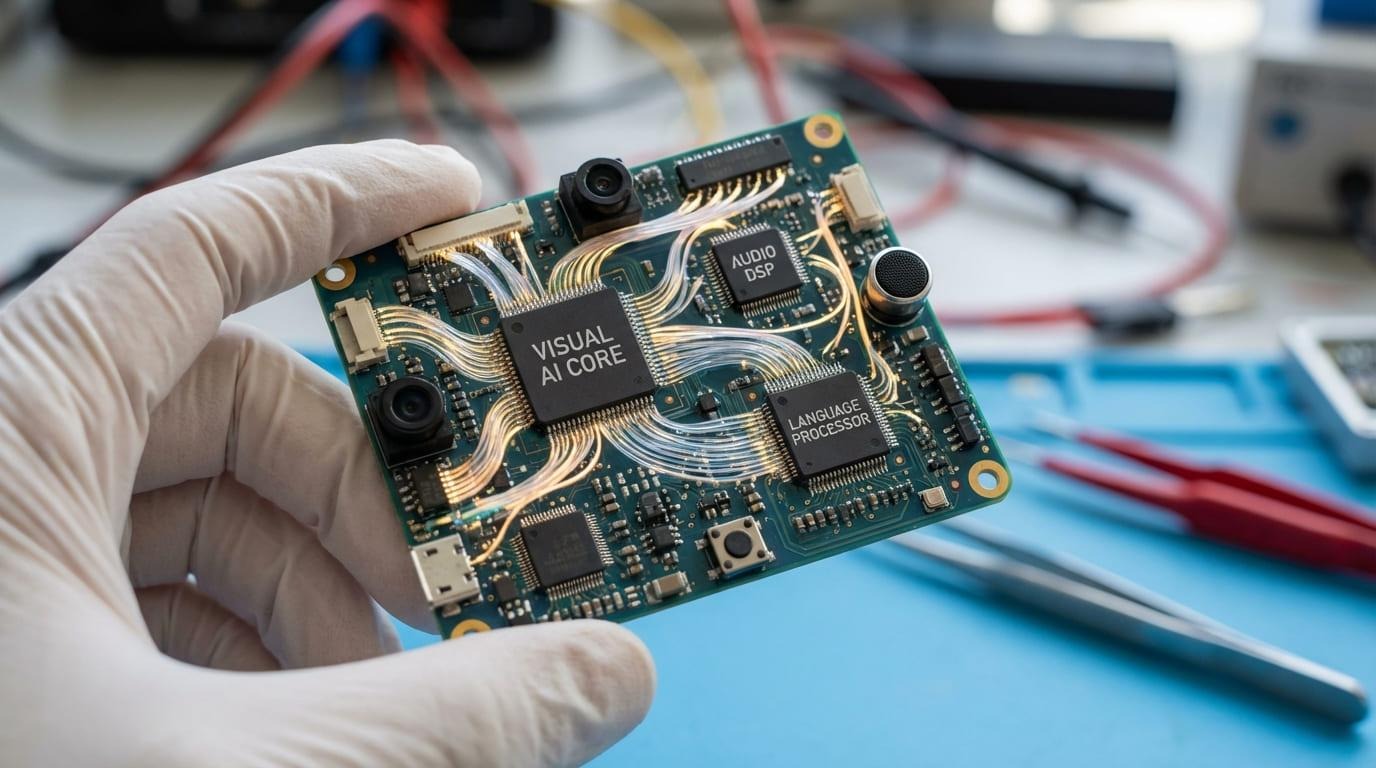
Большая мультимодальная модель (LMM — Large Multimodal Model) — это архитектура на базе глубоких нейронных сетей, способная обрабатывать и объединять данные разных типов. Она включает отдельные энкодеры для изображений и аудио, языковое ядро и общее латентное пространство. Принцип работы строится так: данные кодируются, их представления выравниваются и интегрируются, после чего искусственный интеллект выполняет декодирование — формирует ответ или действие.
В отличие от одномодальных систем, которые работают только с текстом или только с картинкой, мультимодальная модель связывает сигналы между собой. Текстовая LMM анализирует символы, модель компьютерного зрения — пиксели. LMM объединяет данные различных модальностей в едином семантическом представлении и учитывает контекст из разных источников.
На практике такие системы применяются в задачах визуального вопросно-ответного анализа (visual QA), интеллектуальной обработки документов с таблицами и графиками, а также при расшифровке аудио с последующим смысловым разбором.
Как устроены мультимодальные ИИ
Система состоит из последовательности специализированных блоков. Каждый отвечает за свой этап обработки. Ключевая задача — согласовать разнородные сигналы и привести их к единому представлению, на основе которого принимается решение.
Архитектурная схема
Мультимодальная модель условно состоит из трех уровней, которые последовательно обеспечивают обработку, согласование и использование разнородной информации.
-
Модальные блоки. Каждый тип входных данных обрабатывается отдельным специализированным модулем — визуальным, аудио- или текстовым энкодером. Эти блоки извлекают значимые признаки из исходного сигнала и переводят его в векторное представление. Раздельная обработка необходима, поскольку текст, изображения и звук имеют различную структуру и требуют разных методов анализа.
-
Уровень объединения. На этом этапе признаки из всех модальных блоков интегрируются в общее представление. Искусственный интеллект сопоставляет сигналы разных типов, выявляет их взаимосвязи и формирует целостное описание ситуации. Именно здесь происходит согласование разнородной информации.
-
Выходной (декодирующий) слой. Полученное объединенное представление передается в декодер. В зависимости от задачи он генерирует текст, выполняет классификацию, формирует описание изображения или выдает иной результат. Этот уровень отвечает за преобразование внутреннего представления в прикладной вывод.
Такая структура обеспечивает последовательный переход от частной обработки сигналов к их интеграции и формированию итогового решения.
Виды модальностей
Модальность — это тип данных, которые различаются по структуре и способу представления. В мультимодальных системах используются:
Текст представляет собой последовательность токенов, изображение — двумерную матрицу пикселей, аудио — временной сигнал или спектральное представление. Поскольку природа сигналов разная, методы извлечения признаков для каждой модальности тоже отличаются, что требует раздельной предварительной обработки.
Способы объединения данных
Работа с различными модальностями строится по общей логике: каждый поток преобразуется в числовые признаки. Искусственный интеллект обучается сопоставлять их и выявлять взаимосвязи. Итоговое решение формируется уже на основе объединенного представления.
Существуют три стратегии интеграции:
-
Раннее объединение — слияние признаков на начальном этапе обработки.
-
Позднее объединение — объединение результатов отдельных модулей.
-
Совместное обучение — согласование параметров всех блоков в рамках единой архитектуры.
Эти подходы лежат в основе современных LMM и обеспечивают устойчивую работу с разнородной информацией.
Примеры мультимодальных ИИ
Современные мультимодальные модели искусственного интеллекта развиваются вокруг крупных универсальных платформ и специализированных решений. Их архитектура опирается на масштабируемые нейронные сети и интеграцию визуальных и языковых представлений.
Универсальные LMM
-
GPT-4 / GPT-4o и семейство 5.x. Универсальные модели OpenAI конца 2025 – начала 2026 года работают с текстом, визуалом и аудио в едином режиме. Архитектура построена как нативно мультимодальная: входные сигналы сразу обрабатываются в общей системе представлений без отдельной «склейки» моделей. GPT-4o ориентирована на реальное время и диалоговые сценарии, а 5.x — на более сложные рассуждения и расширенные агентные сценарии. Подходят для аналитики документов, визуального QA, голосовых ассистентов и генерации кода.
-
Gemini. Модели Google проектируются как мультимодальные с этапа обучения и поддерживают текст, изображения, аудио и видео. В линейке выделяются версии с разной вычислительной глубиной: от оптимизированных для мобильных задач до полноразмерных корпоративных решений. Сценарии применения включают анализ сложных документов, интерпретацию графиков и видеофрагментов, а также интеграцию в поисковые и аналитические сервисы.
Сравнительная таблица возможностей GPT и Gemini:
|
Параметр
|
GPT-4o / 5.x
|
Gemini
|
|
Поддерживаемые модальности
|
Текст, изображение, аудио
|
Текст, изображение, аудио, видео
|
|
Режим работы
|
Диалоговый, агентный
|
Аналитический, интеграционный
|
|
Обработка в реальном времени
|
Да
|
Частично (в зависимости от версии)
|
|
Контекстное окно
|
Расширенное (в отдельных версиях — сотни тысяч токенов)
|
Расширенное, оптимизировано под длинные документы
|
|
Основные сценарии
|
Ассистенты, автоматизация, код
|
Аналитика, поиск, мультимедийная обработка
|
Кросс-модельные сопоставляющие системы
Предназначены для сопоставления разных типов данных. Например, CLIP — модель, построенная на принципе контрастивного обучения. Она не генерирует ответы, а обучается находить соответствие между визуальным и текстовым описанием. Изображение и текст проецируются в общее пространство, где измеряется их семантическая близость. Такая архитектура используется для поиска картинок по текстовому запросу, автоматической разметки контента и фильтрации медиафайлов.
Генеративные визуальные модели
Создают новый контент на основе текстового или мультимодального запроса. В отличие от сопоставляющих систем, они не ищут соответствие, а синтезируют картинку с заданными характеристиками.
Например, современные системы генерации изображений по текстовому описанию - такие как OpenAI GPT Image / ChatGPT Images, Google Imagen 4 и Adobe Firefly Image Model 4 - позволяют создавать детализированную графику, точнее работать с надписями и редактировать изображения по выделенным областям или уточняющим инструкциям. Такие модели применяются для маркетинговой графики, прототипирования дизайна, визуализации идей и подготовки контента для цифровых платформ.
Российские разработки
На российском рынке рождаются собственные решения в области мультимодального искусственного интеллекта. Они ориентированы на работу с русскоязычными данными и локальные требования к безопасности и хранению информации.
К числу известных проектов относятся:
-
OmniFusion. Универсальная мультимодальная модель, способная анализировать текст и визуал. Делает акцент на обучении на русскоязычных корпусах и интеграции в отечественные сервисы.
-
GigaChat Vision. Расширение языковой модели с поддержкой анализа изображений и документов. Применяется в корпоративных и государственных сервисах.
-
YandexGPT Vision (экспериментальные версии). ИИ с поддержкой интерпретации визуала и мультимедийного поиска в рамках экосистемы поисковых сервисов.
Эти решения демонстрируют, что направление мультимодальных ИИ активно развивается и в России, с акцентом на локализацию, поддержку русского языка и интеграцию в национальные цифровые платформы.
Преимущества и ограничения
Мультимодальные модели ИИ расширяют возможности анализа благодаря объединению разных типов данных. Однако рост функциональности сопровождается усложнением архитектуры и повышенными требованиями к ресурсам и качеству обучения.
Когда мультимодальность дает выигрыш:
-
Контекст из нескольких источников. При совместной обработке картинки и текста или видео и звука искусственный интеллект учитывает взаимосвязи между сигналами, что снижает риск искаженной интерпретации.
-
Компенсация неполных данных. Если одна модальность содержит шум или недостаточно информации, другая частично восполняет пробелы.
-
Повышенная устойчивость. Использование нескольких каналов делает итоговый вывод более стабильным по сравнению с анализом одного типа данных.
Ограничения мультимодального искусственного интеллекта:
-
Высокая стоимость вычислений. Крупные модели и большие датасеты увеличивают требования к инфраструктуре и времени обучения.
-
Сложность интеграции. Согласование разных типов сигналов требует точной настройки и качественной синхронизации.
-
Риски качества. Ошибки в одной модальности могут повлиять на итоговое решение всей системы, а подготовка согласованных обучающих выборок требует дополнительных ресурсов.
Практические сценарии применения
Мультимодальные языковые модели переходят от экспериментальных прототипов к прикладным решениям. Они востребованы там, где требуется совместный анализ текста, изображений и других сигналов с формированием единого вывода.
Диагностика
LMM используются в исследовательских и вспомогательных сценариях для совместного анализа медицинских изображений и текстовой информации о пациенте. Например, ИИ получает снимок КТ и выписку из истории болезни. Визуальный модуль выявляет структурные изменения, текстовый — учитывает симптомы и клинический контекст. Объединение данных позволяет сформировать предварительное заключение и выделить зоны риска для дальнейшего анализа профильными специалистами.
Аналитика
В корпоративной среде искусственный интеллект обрабатывает отчеты с таблицами, графиками и комментариями. При работе с финансовыми PDF визуальный модуль распознает структуру диаграмм и числовые значения, языковой — интерпретирует пояснения и выводы. На основе объединенного анализа формируется сводка ключевых показателей с учетом числовых данных и контекста.
Генерация контента
В маркетинге LMM применяются для создания текстов по изображению продукта. Фото передает визуальные характеристики — форму, цвет, детали, а текстовый бриф задает аудиторию и стиль коммуникации. Модель объединяет сигналы и генерирует описание, соответствующее визуальному образу и задачам рекламной кампании.
Операционные процессы
В промышленности мультимодальные модели ИИ используют для контроля качества. Камера фиксирует деталь, система получает технические требования в текстовой форме. Искусственный интеллект сопоставляет визуальные параметры со спецификациями и автоматически выявляет отклонения, снижая нагрузку на персонал и ускоряя проверку.
Будущее мультимодальных технологий
Будущее мультимодальных ИИ связано с расширением спектра задач и повышением устойчивости систем к реальным условиям эксплуатации. LMM постепенно переходят от экспериментальных решений к инфраструктурному уровню цифровых сервисов.
-
Расширение поддерживаемых модальностей. Модели все чаще работают с видео в реальном времени, непрерывными аудиопотоками и сенсорными данными. Важным направлением становится обработка длинных последовательностей без потери контекста.
-
Снижение вычислительной стоимости. Развитие оптимизированных архитектур и компактных версий позволяет запускать мультимодальные модели ИИ локально. Повышается энергоэффективность, снижается барьер внедрения.
-
Агентные и интерактивные системы. Мультимодальные решения становятся основой автономных помощников, которые одновременно анализируют текст, изображение и окружающую среду и принимают решения в режиме диалога.
-
Качество и согласование данных. Совершенствуются методы обучения мультимодальных моделей, направленные на более точное объединение модальностей и устойчивость к шуму или неполным данным.
-
Регулирование и безопасность. Рост внедрения требует стандартов контроля, защиты персональной информации и прозрачных правил промышленного использования таких систем.
Какая инфраструктура нужна мультимодальным ИИ
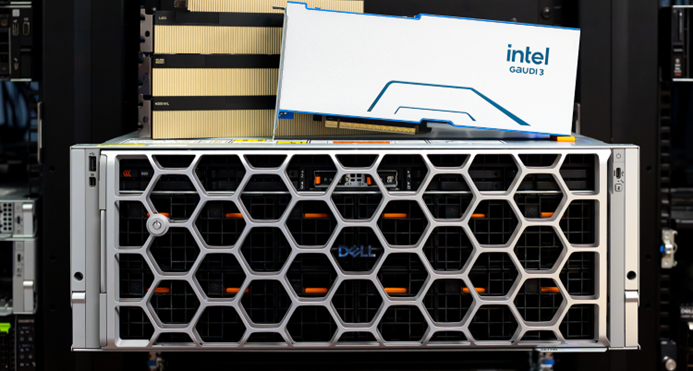
Развитие мультимодальных моделей постепенно переводит тему ИИ из области программных экспериментов в область инфраструктурного проектирования. Если система должна не только работать с текстом, но и одновременно анализировать изображения, документы, аудио и видео, требования к вычислительной платформе заметно растут. В таких проектах уже приходится учитывать не только выбор модели и качество данных, но и класс серверов для ИИ, на которых будет выполняться обучение, донастройка или вывод.
Особенно это заметно в сценариях, где важны скорость отклика, локальная обработка данных и предсказуемая производительность под нагрузкой. Здесь критичны объем видеопамяти, пропускная способность памяти, интерконнект ускорителей и совместимость программного стека. Поэтому при переходе от пилота к промышленному внедрению компании все чаще отдельно оценивают не только серверную платформу, но и подходящие GPU-ускорители под конкретные мультимодальные нагрузки, напремер под модели ChatGPT или Llama.
Заключение: итоги и перспективы
Мультимодальные языковые модели открывают новый этап развития искусственного интеллекта - переход от обработки отдельных типов данных к целостному анализу информации из разных источников. Их архитектура, методы объединения модальностей и прикладные сценарии показывают, что мультимодальность становится базовым принципом построения интеллектуальных систем, а не экспериментальным направлением.
С рыночной точки зрения будущее мультимодальных ИИ связано с промышленным масштабированием таких решений: снижением стоимости внедрения, ростом требований к качеству информации и усилением регулирования. Для бизнеса это означает переход от пилотных проектов к системной интеграции LMM в аналитику, автоматизацию и клиентские сервисы.
Коммерческая ценность мультимодальности особенно заметна в тех организациях, где уже накоплены разнородные источники данных - документы, сканы, фотографии, таблицы, аудиозаписи, видеофрагменты и логи процессов. В такой среде мультимодальные модели помогают не только интерпретировать каждый тип информации отдельно, но и выявлять связи между ними, формируя более целостное представление о событиях, операциях и поведении систем.
Часто задаваемые вопросы
Что такое мультимодальный искусственный интеллект?
Это класс систем, которые одновременно обрабатывают несколько типов данных (текст, изображения, аудио, видео) и формируют единое семантическое представление для принятия решения.
Как работают мультимодальные ИИ?
Модель кодирует каждый тип входных данных в числовые признаки, согласует их в общем пространстве представлений и на основе объединенной информации формирует ответ или выполняет целевое действие.
Чем мультимодальные ИИ отличаются от одномодальных?
В отличие от одномодальных систем, анализирующих только один тип сигнала, мультимодальные сопоставляют данные разных форматов и учитывают их взаимосвязи.
Какие типы данных могут обрабатывать мультимодальные ИИ?
Современные LMM-системы работают с текстом, изображениями, аудио, видео, таблицами и другими структурированными или временными данными.
В чем реальная польза от мультимодальных ИИ?
Практическая ценность заключается в более точной аналитике, устойчивости к неполным данным и автоматизации задач, где требуется учитывать несколько источников информации одновременно.






Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!