Что такое сервер баз данных и какую бизнес-задачу он решает
Сервер баз данных — это выделенный вычислительный узел (или кластер), который хранит, обрабатывает и предоставляет доступ к корпоративным данным приложений: ERP/CRM, сайты и порталы, аналитика, IoT-телеметрия и др.
С точки зрения бизнеса это:
- Непрерывность операций (заказы, платежи, склад, поддержка);
- Скорость принятия решений (оперативные и аналитические отчеты);
- Снижение рисков (целостность и доступность данных, комплаенс);
- Предсказуемая экономика (лицензирование ПО БД часто дороже «железа», поэтому верный выбор CPU позволяет уменьшить совокупную стоимость владения).
Базы данных и в 2025 году остаются критичным слоем производительности. По мнению 88% ИТ-директоров в отраслевом исследовании Gleanster СУБД — наиболее частая причина проблем с производительностью приложений и негативно влияет практически на все бизнес процессы, начиная от “традиционной” боли со скоростью генерации отчетов 1С или формирования управленческой аналитики в режиме реального времени или заканчивая задержками или сбоями в работе ИИ-агентов, где обработка событий от LLM-сервисов, векторный поиск, хранение признаков для рекомендаций — всё это требует быстро масштабируемых СУБД и низких задержек.
Превращение данных в ценность для бизнеса в текущих условиях только подчеркивает растущую роль СУБД. Сегодня организациям приходится одновременно решать задачи миграции в облако, работы с дорожающими инструментами администрирования, поддержки устаревших операционных нагрузок, защиты планов аварийного восстановления, управления расширяющимся массивом данных и преодоления сложности разнородных архитектур.
Какие бывают СУБД и что им важно от процессора
Выбор процессора для БД начинается не с «максимум ядер», а с понимания паттерна работы самой СУБД: где-то критична однопоточная производительность и размер L3-кэш/ядро (OLTP, кэши), где-то важнее масштабируемость по потокам и пропускная способность памяти (OLAP), а для новых сценариев — поддержка современных инструкций SIMD/AVX (быстрые «векторные» инструкции, которые разгоняют аналитику, шифрование, сжатие и векторный поиск), низкая латентность и достаточный объём оперативной памяти под индексы (векторные БД). На итоговую производительность и экономику влияет не только микроархитектура процессора, но и модель лицензирования (по ядрам/по сокетам), NUMA-топология, профиль ввода/вывода и политика huge pages (правил, по которым операционная система и приложения используют крупные страницы памяти - обычно 2 МБ или 1 ГБ вместо стандартных 4 КБ). Ниже — краткая «карта» основных типов СУБД с указанием того, что именно им важно от процессора, чтобы связать бизнес-метрики (SLA по задержкам, Throughput, стоимость лицензий и владения) с конкретными параметрами процессора и упростить первичную навигацию при выборе.
1. Реляционные OLTP (PostgreSQL, MySQL, SQL Server, Oracle)
Типовые бизнес-задачи:
- Онлайн-продажи и биллинг (заказы, платежи, лояльность, антифрод в онлайне).
- Операционный контур ERP/CRM/WMS (1С, склад, отгрузка, сервис, тикеты).
- Финансовые транзакции и микроплатежи (финтех, телеком-дебет).
Профиль нагрузки: короткие транзакции, высокий уровень параллелизма, чувствительность к задержкам.
CPU-требования: высокая частота на ядро и достаточное число ядер для конкурирующих операций; крупный L3-кэш/ядро и эффективная работа с памятью (huge pages) уменьшают промахи кэша и системные накладные. Для PostgreSQL прямо отмечается ценность однопоточной производительности процессора и большего L3.
2. Аналитические базы данных OLAP (ClickHouse и аналоги)
Типовые бизнес-задачи:
- BI/дашборды «день-в-день» (маркетинг, продажи, продуктовые метрики).
- Поведенческая аналитика событий/логов (web/app, кликстрим, телеметрия).
- Отчётность и regulatory-выборки по большим массивам (retail, банки).
Профиль нагрузки: сканирование больших объемов, SIMD-операции, агрегации.
CPU-требования: много ядер и стабильная пропускная способность памяти (memory bandwidth); планирование RAM к ядрам и агрессивный параллелизм. Рекомендации ClickHouse учитывают соотношение «память : ядра» и подчеркивают значимость достаточного объёма оперативной памяти на каждое ядро процессора.
3. In-memory/кеши (Redis)
Типовые бизнес-задачи:
- Кеширование горячих данных и сессий (авторизация, профили, корзина).
- Квоты/рейткейты, очереди задач и счётчики в реальном времени.
- Быстрые фичесторы для моделей (фичи рекомендаций/персонализации).
Профиль нагрузки: микро-задержки, высокая QPS, ограниченная многопоточность обработки команд.
CPU-требования: высокая однопоточная производительность (приоритет максимальной тактовой частоты) и большой кэш важнее, чем «много ядер»: Redis при обработке команд традиционно ориентирован на однопоточность и очень чувствителен к латентности и промахам кэша.
4. Документо-ориентированные/операционные NoSQL (MongoDB)
Типовые бизнес-задачи:
- Профили пользователей и каталоги с гибкими схемами (e-commerce, контент).
- IoT/телеметрия с вариативной структурой событий.
- Операционные API-сервисы с быстрым развитием схемы данных.
Профиль нагрузки: смешанные чтение/запись, требования к объёму оперативной памяти под “горячие” данные.
CPU-требования: многопоточность, достаточная оперативная память, настройка heap/page cache; акцент на баланс CPU↔память.
5. Графовые БД (Neo4j)
Типовые бизнес-задачи:
- Поиск связей и антифрод (финансы, маркетплейсы, телеком).
- Рекомендательные сценарии на графе (соцсети, контент-платформы).
- MDM/каталоги зависимостей и влияний (IT-активы, supply chain).
Профиль нагрузки: обходы графа, алгоритмы на множестве вершин/ребер.
CPU-требования: многопоточность, достаточная RAM, настройка heap/page cache; акцент на баланс CPU↔память.
6. Векторные БД и поиск похожести (Milvus и др.)
Типовые бизнес-задачи:
- Семантический поиск и RAG для LLM (документы, база знаний, support).
- Поиск похожих товаров/изображений/треков (e-commerce, медиа).
- Антифрод/скоринг признаков на векторных эмбеддингах.
Профиль нагрузки: векторные индексы, ANN-поиск, часто CPU-SIMD/AVX и/или GPU.
CPU-требования: много ядер, современные инструкции AVX/AVX2/AVX-512, высокая роль RAM для индексов и датасетов.
Типовые проблемы при эксплуатации СУБД и как выбор CPU помогает
Когда базы данных начинают «тормозить» или дорожать быстрее, чем растет выручка, причины почти всегда лежат на поверхности. В одних случаях бюджет «съедает» лицензирование за ядро: чем больше ядер активировано, тем дороже обходится каждая инсталляция (особенно в моделях Per Core/с core-факторами). В других случаях страдает пользовательский опыт из-за задержек: короткие транзакции упираются в промахи кэша и конкуренцию за ресурсы, и хвосты p95/p99 растут. Отдельная история — аналитика: колоночные движки отлично масштабируются, но требуют много параллелизма и устойчивой скорости работы с памятью; без этого сканирование столбцов быстро упирается в «потолок». Наконец, непредсказуемость кэш-слоя (Redis) и несовместимость со «старыми» инструкциями процессора (SIMD/AVX) добавляют операционной нервозности: дополнительные ядра почти не помогают кэшу, а современные движки и библиотеки просто не дают преимуществ на устаревших микроархитектурах.
Хорошая новость в том, что грамотный выбор CPU напрямую лечит большую часть из этих проблем. Если лицензирование идёт «за ядро», логика простая: меньше активных ядер — выше частота — больше L3 на ядро. Такой подход повышает производительность на одно ядро и одновременно держит под контролем расходы на лицензии. Если задача — снизить задержки в OLTP, выбирайте высокочастотные модели процессоров с крупным L3 и предсказуемой работой памяти; дополнительно помогает политика huge pages — меньше накладных на адресацию, стабильнее латентность. Для аналитики, наоборот, нужен упор в число ядер, в современные векторные инструкции (SIMD/AVX) и в достаточную оперативную память на ядро: так параллельные агрегации и сканирование колонок перестают упираться в память. В кэш-слое ключ — высокая частота и крупный кэш (а не просто «больше ядер») плюс закрепление процесса за конкретным ядром — это даёт ровную, предсказуемую производительность. И наконец, чтобы не потерять ускорения в векторном поиске и сжатии, нужен процессор с актуальным набором инструкций (AVX2/AVX-512): без них часть оптимизаций движков просто не включается.
Итог для бизнеса тривиален: под профиль нагрузки — свой профиль процессора. Перенастроив приоритеты с «максимум ядер на сокет» на «нужные ядра, нужная частота, нужный кеш и правильные инструкции», можно одновременно улучшить пользовательский опыт и снизить общую стоимость владения — без дорогостоящего «раздувания» инфраструктуры.
Рост производительности СУБД за счет смены поколения процессора - на примере Intel и MS SQL 2022
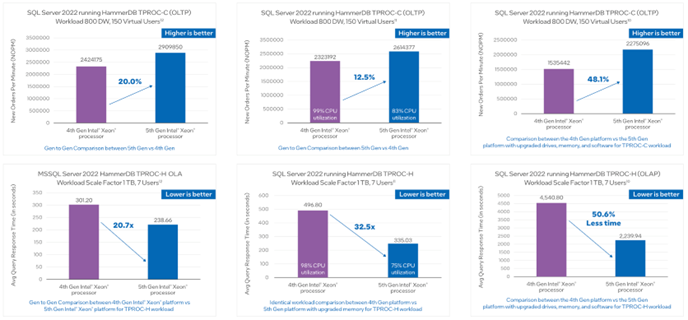
Переход с Intel Xeon 4-го на 5-е поколение даёт заметный прирост скорости как в транзакционных, так и в аналитических сценариях SQL Server 2022. По результатам стендов HammerDB для OLTP-профиля (TPROC-C) прирост измеряется двузначными величинами: при «чистом» сравнении поколений фиксируется около +12,5%операций в минуту, а при комплексном обновлении узла (накопители, память, программная среда) разница доходит примерно до +48,1%; есть и промежуточные кейсы с ~+20%. В аналитических нагрузках (TPROC-H) эффект проявляется через падение времени ответа: средние запросы обрабатываются быстрее на ~20–51% в зависимости от конфигурации — от ≈−20,7% при близких настройках до ≈−32,5% на платформе с обновлённой памятью и ≈−50,6% при полном рефреше.
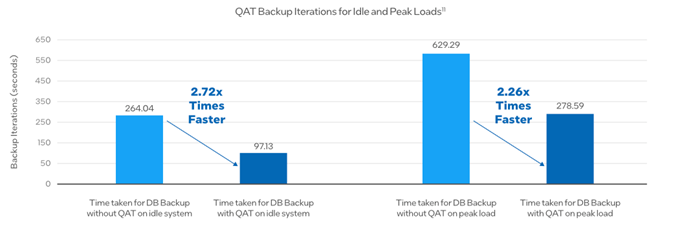
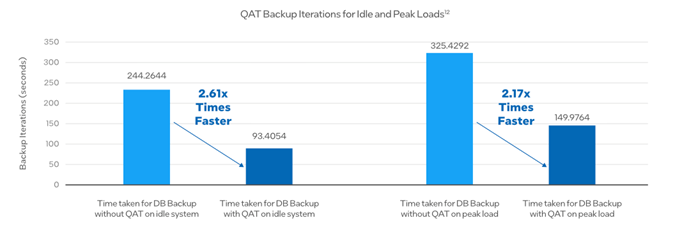
Отдельно стоит отметить влияние аппаратного ускорения Intel QAT на окна резервного копирования. При шифровании/сжатии бэкапов QAT сокращает время выполнения примерно в 2,2–2,7 раза как на незагруженной системе, так и под пиковыми нагрузками. Для эксплуатационных процессов это означает более короткие и предсказуемые окна, меньшую конкуренцию с прод-транзакциями и, как следствие, более низкие риски по RPO/RTO.
Подробно с результатами тестирования можно ознакомится на слайдах ниже:
Серверные CPU как инструмент снижения стоимости лицензий СУБД - на примере линейки процессоров AMD
Коротко о влиянии процессоров на бюджет БД и что с этим делать. На примере Postgres Pro и Microsoft SQL Server (лицензирование “за ядро”): 192-ядерный AMD EPYC 9965 при расчёте «за одно ядро» способен резко разогнать расходы на лицензии. Поэтому и у у AMD, и у Intel есть линейки, специально ориентированные на такие сценарии — с акцентом на высокую частоту на ядро при умеренном количестве ядер.
При этом важны и совокупная стоимость системы, и производительность приложения на узел. Так, 64-ядерный AMD EPYC 9575F с частотами до ~5 ГГц помогает выжать высокую производительность-на-сокет — но это по-прежнему 64 ядра, каждое из которых придется лицензировать. Отсюда интерес к моделям вроде AMD EPYC 9175F: 16 ядер, 512 МБ L3 (по 32 МБ на ядро), частоты 4,2–5,0 ГГц (все-ядра — 4,55 ГГц). Такой процессор нередко обходится дешевле, чем «докупить» еще 1–2 лицензируемых ядра ПО БД.
Большой L3-кэш критичен: чем больше кэш на ядро, тем вероятнее нужные данные оказываются “на кристалле”, а ожидаются из ОЗУ — вычислительные блоки ядра заняты полезной работой чаще. Для небольших, но “быстрых” БД могут быть уместны Genoa-X (EPYC 9004X) — это предыдущее поколение Zen 4 с меньшим IPC и частотами, но с очень большим кэшем. Например, EPYC 9184X (16 ядер, до 768 МБ L3) для части задач остается «супер оружием». Большинство СУБД не тарифицируют объём L3.
Идея этих процессоров — добиться максимальной однопоточной производительности: меньше ядер → больше частота в заданных теплопакетах, плюс усиленная подсистема памяти/кэша, чтобы «кормить» эти быстрые ядра без простоев.
Если же лицензирование за узел/за сокет, то приоритеты меняются. Тут выигрывают 128-ядерные процессоры вроде AMD EPYC 9755: когда лицензия “за сокет”, 128 ядер вместо 16 обычно окупают потерю 10–30 % производительности на ядро. В 2025 году EPYC 9755 (128 ядер, 512 МБ L3, т. е. 4 МБ/ядро) ценится как компромисс «много ядер + достойная per-core-производительность», что полезно, например, векторным БД и другим вычислительно насыщенным приложениям.
Если использовать типовую для 2019–нач. 2021 конфигурацию Supermicro на базе Intel Cascade Lake и планировать обновление, то переход на AMD EPYC 9755 позволит консолидировать до семи сокетов/узлов в один сервер.
Даже при ориентации на частоту, выбор AMD EPYC 9575F (64 ядра) даёт 128 ядер на сервер и по производительности на узел сопоставим с более чем четырьмя узлами на двухпроцессорных Intel Xeon 6252 (в сумме 192+ ядра). Экономия на поядерном лицензировании часто окупает весь проект обновления.
Завершая «круг», AMD EPYC 9965 с 192 ядрами — отличный вариант для части БД-нагрузок. В облачно-нативных БД доля аппаратной стоимости в TCO заметна (при отсутствии «дорогих» лицензий ПО), и у такого CPU есть два типовых сценария:
— добавить пиковую производительность одной БД, или
— уплотнить размещение множества контейнеров/VM на одном железе. Больше клиентов/приложений на том же сервере = лучше утилизация и выше отдача от «железа» и операционных расходов.
Чит-код для небольших реляционных БД: Есть множество сайтов на Drupal, WordPress и других CMS, которым требуется сервер баз данных. Еженедельно встречаются странные и зачастую дорогие/прожорливые по энергопотреблению конфигурации для таких задач. Почти любой сайт вне топ-10 000 по трафику способен «летать» на AMD EPYC 4005 “Grado”, с 64–128 ГБ памяти и быстрыми NVMe SSD — производительность будет выдающейся.
Обратная связь от тех, кто перешёл на такую схему (раньше это был EPYC 4004), стабильно позитивная. Высокие частоты и архитектура Zen 5 дают быстрые узлы БД, если подкрепить их современными SCM-накопителями. Для более «тяжёлых» приложений, например Microsoft SQL Server, чаще подходит AMD EPYC 9175F — из-за большего кэша, объёма/полосы памяти и улучшенных RAS-возможностей. Но если нужно низкое энергопотребление и низкая стоимость для облачно-нативных баз с высокой скоростью, EPYC 4005 — очень удачный выбор.
Отдельно про выбор CPU для 1С
Что такое «сервер 1С»
В типовой архитектуре 1С есть три роли: сервер приложений (исполняет бизнес-логику и обслуживает пользовательские запросы), сервер базы данных (центральный узел с самой информационной базой) и терминальный сервер для удалённого доступа (RDP/VDI). Такое разделение повышает производительность и отказоустойчивость по мере роста нагрузки.
Роль сервера БД в 1С и требования к процессору
Сервер БД определяет скорость транзакций, построения отчётов и общий отклик системы; это самый ресурсоёмкий компонент кластера. Для него критичны высокая производительность на ядро, достаточный объём RAM и быстрые NVMe-накопители. В типовых рекомендациях под БД выбирают конфигурации, делающие упор на максимальную per-core-производительность процессора.
Подходящие процессоры для сервера БД 1С (примеры)
- AMD EPYC 9175F (16C) — высокочастотный процессор с большим L3, хорошо подходит для интенсивных транзакций и пиковых нагрузок.
- Intel Xeon Gold 6544Y (16C) — другой вариант с высокой частотой на ядро; уместен там, где важен быстрый отклик.
- AMD EPYC 72F3 (8C) — эффективный выбор для умеренных по размеру баз и проектов, где важна предсказуемая задержка.
Если планируете виртуализацию ролей сервера 1С, ориентируйтесь на высокую частоту CPU для ВМ БД, а также на многоканальную память и NVMe-хранилище.
Более подробно про роли сервера для 1С/ERP можно прочитать отдельно в двух наших тематических статьях. В материале «Сервер для 1С:ERP: как выбрать, характеристики, конфигурации» собраны ключевые критерии и роли узлов (приложений, БД, терминалов) с практическими ориентирами по железу и масштабируемости — это хорошая база, если вы только проектируете или пересобираете инфраструктуру 1С. Дополняет её статья «Как выбрать процессор для 1С сервера», где сфокусировано рассматривается выбор CPU под реальные сценарии работы: от требований к частоте и кешу до примеров подходящих моделей и типовых ошибок при подборе.
Рекомендованные процессоры под типовые сценарии БД
Подбор процессора для сервера баз данных начинается с профиля нагрузки, а не с «гонки ядер». В одном случае критична высокая частота и крупный L3 на ядро для минимизации задержек транзакций, в другом — параллелизм и стабильная скорость работы с памятью для ускорения сканирования и агрегаций, в третьем — поддержка векторных инструкций и достаточный объем ОЗУ под индексы и рабочий набор данных. Ниже собраны ориентиры по моделям AMD и Intel, распределенные по распространённым сценариям — от SMB до enterprise. Таблица помогает быстро сопоставить вашу задачу с подходящим классом CPU: это не «единственно верные» рецепты, а проверенные отправные точки для пилота и дальнейшей валидации на реальных запросах и данных.
|
Сегмент
|
Сценарий
|
Ориентир по пользователям/ трафику/данным
|
Виды нагрузок на БД
|
Профиль CPU
|
Рекомендуемые CPU
|
Также можно рассмотреть
|
|
SMB
|
Сайт/портал на CMS (WordPress/Drupal) + PostgreSQL/MySQL
|
50–500 одновременных посетителей; пики при акциях/контенте 10–200 ГБ БД; «горячий» набор 2–20 ГБ
|
Чтение преобладает, короткие OLTP-запросы, всплески записи (комментарии/заказы), отчёты «день-в-день»
|
Частотный 8–16C, крупный L3/ядро
|
AMD EPYC 72F3, AMD EPYC 7313; Intel Xeon E-2488, Xeon Gold 5415+, Xeon Gold 6434
|
AMD EPYC 9015
|
|
SMB
|
CRM/склад: быстрое проведение заказов и остатков (OLTP)
|
30–200 внутренних пользователей; 1–5 тыс. транзакций/ч 100 ГБ–1 ТБ; 10^6–10^7 записей в ключевых таблицах
|
Малые транзакции, строгая латентность (p95 < 50–100 мс), периодические отчёты
|
12–24C, акцент на частоту, huge pages
|
AMD EPYC 9175F, 9174F, 9015; Intel Xeon Gold 6434, 6334
|
Intel Xeon Gold 6544Y
|
|
SMB
|
Redis-кеш перед БД (сессии/каталоги/квоты)
|
5–50 тыс. запросов/с к кешу; 1–3 кеш-нод 1–32 ГБ в RAM; ключи TTL
|
In-memory GET/SET, микролатентность, редкие блоковые операции
|
1–2 быстрых ядра, большой L3
|
AMD EPYC 72F3, 9174F; Intel Xeon Gold 5415+, 6434
|
Intel Xeon 6517P
|
|
Mid-range
|
Операционный контур + лёгкая аналитика (OLTP + ClickHouse)
|
200–1 000 пользователей; 10–50 параллельных запросов 0,5–3 ТБ суммарно (OLTP + стейджинг); «горячий» 50–200 ГБ
|
Смешанные: много коротких транзакций + дневные агрегации/дашборды
|
24–48C, достаточная RAM/ядро, быстрые NVMe
|
AMD EPYC 9015, 7313; Intel Xeon Gold 6534, 6544Y
|
AMD EPYC 9175F
|
|
Mid-range
|
Витрина документов и API (MongoDB)
|
1 000–50 000 активных пользователей/день; 1–5 тыс. RPS 0,5–5 ТБ; рабочий набор 50–500 ГБ
|
Смешанные чтение/запись, гибкие схемы, интенсивное индексирование, шардирование
|
16–32C, приоритет RAM под working set и SSD
|
AMD EPYC 7313, 9015; Intel Xeon 6517P, Xeon Gold 6334
|
Intel Xeon Gold 6544Y
|
|
Mid-range
|
Граф-аналитика (Neo4j GDS: рекомендации/связности)
|
20–100 задач/джобов в час; 10–50 аналитиков 10–100 млн вершин; 100 млн–1 млрд рёбер
|
Обходы графа, вычислительные алгоритмы (PageRank/Community), чувствительность к RAM
|
16–32C, баланс CPU↔RAM
|
AMD EPYC 9015, 7313; Intel Xeon Gold 6534, 6517P
|
Intel Xeon Gold 6434
|
|
Enterprise
|
Критичный OLTP (SQL Server/Oracle) для core-систем
|
1 000–10 000 одновременных пользователей; 10–100 тыс. транзакций/мин 5–50 ТБ БД; «горячий» 0,5–5 ТБ
|
Высокий TPS, строгие SLA по p95/p99, интенсивные индексы/журналы, репликация/HA
|
Частотные SKU, крупный L3/ядро
|
AMD EPYC 9175F, 9174F; Intel Xeon Gold 6434, 6334
|
AMD EPYC 9015
|
|
Enterprise
|
Крупный DWH/аналитика (ClickHouse)
|
100–500 аналитиков; 10–50 тяжёлых запросов одновременно 10–200 ТБ «сырых» данных; ежедневная приростная загрузка
|
Сканирование столбцов, массивные агрегации/джоины, активный SIMD и параллелизм
|
48–96+C, параллелизм, RAM/ядро
|
Intel Xeon Gold 6544Y, 6534; AMD EPYC 9015
|
AMD EPYC 7313
|
|
Enterprise
|
Векторный поиск/семантический слой (Milvus/ANN)
|
1–20 тыс. QPS на поиск; онлайн-сервисы 100 млн–1 млрд векторов; онлайн-индекс 0,5–5 ТБ RAM/узел
|
ANN-поиск, чувствительность к задержке (10–100 мс), интенсивные векторные операции
|
32–64+C, AVX/AVX2/AVX-512, много RAM
|
Intel Xeon Gold 6544Y, 6534; AMD EPYC 9015
|
AMD EPYC 9175F
|
Выбор платформы: топ-серверы на Intel Xeon Gen5/Gen6 и AMD EPYC Zen4/Zen5
Переход на последние поколения CPU даёт ощутимый прирост производительности «на сокет» и «на ядро» (выше частоты, шире полоса пропускания памяти DDR5, PCIe 5.0/EDSFF, новые ускорители и инструкции). Для транзакционных СУБД это проявляется в снижении p95/p99-задержек и росте TPS без изменения кода; для аналитики — в ускорении сканирования/агрегаций за счёт большего параллелизма и эффективных SIMD. Параллельно улучшается эффективность резервного копирования и шифрования (за счёт встроенных оффлоад-блоков у Intel; у AMD — более высокая плотность ядер и варианты с большим L3). В итоге обновление платформы на перечисленные «флагманы» — это не только про скорость, но и про возможность консолидировать узлы БД, сократить окна обслуживания, улучшить энергоэффективность и стабильность под текущие и будущие нагрузки.
Ниже — актуальные «флагманские» (массовые 1U/2U/4U) серверы HPE, Dell и Lenovo под Intel 5-е и 6-е поколения и AMD 4-е и 5-е поколения. Это модели, которые вендоры сами позиционируют как основные платформы для ЦОД/БД, с широкими конфигурациями и долгим жизненным циклом.
Заключение
Правильный процессор для сервера БД — это совпадение профиля нагрузки с сильными сторонами платформы, а не «побольше ядер». Для транзакций важнее производительность на ядро и кеш, для аналитики — параллелизм и скорость памяти, для кеш-слоя — предсказуемая низкая латентность, для векторных задач — современные векторные инструкции и достаточная RAM. Обновление поколения CPU дает быстрый прирост по SLA и энергоэффективности и открывает пространство для консолидации — при условии, что сопутствующие настройки и инфраструктура не отстают.
Итоговый вывод: в 2025 году выбор процессора для сервера баз данных остается сложной, но решаемой задачей. Три вещи делают этот выбор предсказуемым и выгодным. Первое — диагностика профиля нагрузки и «узких мест» именно вашей СУБД, вместо усредненных рецептов. Второе — привязка CPU-профиля к экономике лицензий и плану консолидации, чтобы «производительность на ядро» и «ядра на сокет» работали на бюджет, а не против него. Третье — планомерный рефреш поколений там, где это дает наибольший мультипликатор: транзакции, аналитика и резервное копирование выигрывают сразу, а энергоэффективность и устойчивость — в горизонте нескольких лет. Такой подход позволяет превратить платформу БД из «узкого места» в источник конкурентного преимущества и сделать рост данных и AI-нагрузок управляемым — и по скорости, и по деньгам.






Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!