По мере того как приложения в области искусственного интеллекта (ИИ) и высокопроизводительных вычислений (HPC) повышают требования к вычислительным ресурсам, выбор форм-фактора графического ускорителя - PCIe или SXM - может заметно повлиять на результат внедрения разных типов ИИ-нагрузок на сервере. Это решение не сводится только к технике - оно становится стратегическим, потому что напрямую влияет на общую производительность системы, возможности масштабирования и экономическую целесообразность.

Серия сравнительных тестов по ключевым метрикам дает целостное сопоставление одного ускорителя в форм-факторе PCIe и одного - в форм-факторе SXM, с фокусом на пропускную способность и задержки, чтобы понять базовые различия этих форм-факторов и показать их влияние на практических примерах бизнес-сценариев.
Форм-факторы ускорителей - PCIe и SXM
Прежде чем переходить к цифрам, важно обозначить общие различия и сильные стороны двух форм-факторов.
PCIe и SXM - это два способа установить и подключить графический ускоритель в сервере. PCIe - более универсальный вариант: такие ускорители ставятся в большинство стандартных серверов, проще по внедрению и обычно требуют меньше питания и охлаждения.
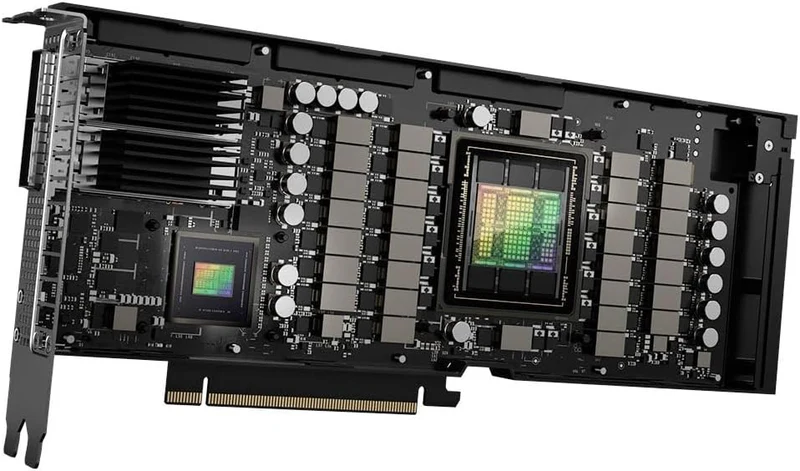
SXM - специализированный вариант для максимальной производительности: ускоритель теснее интегрирован с платформой, получает более высокую скорость обмена данными с памятью и другими ускорителями, но взамен требует более мощного питания и продвинутого охлаждения, а сам сервер обычно относится к более "плотному" и дорогому классу.
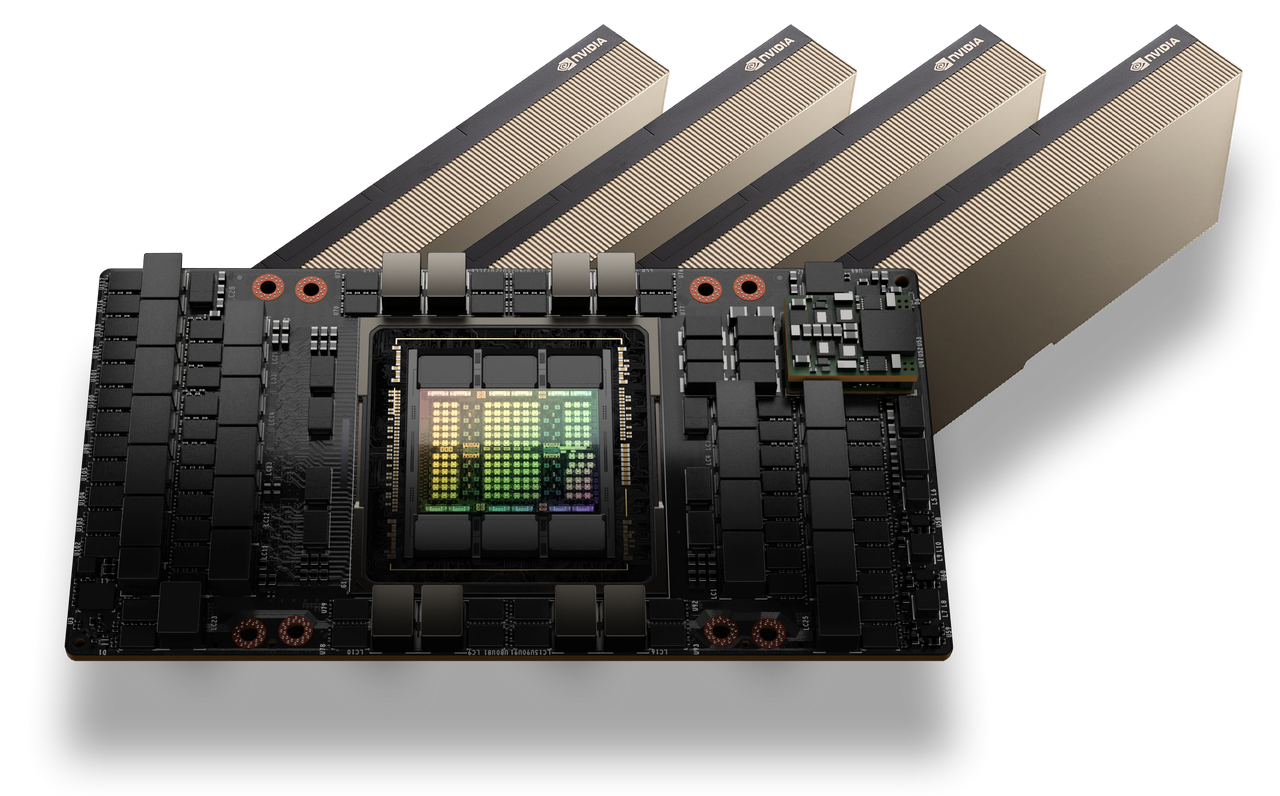
Как видно в таблице ниже, вариант SXM обеспечивает заметно более высокую пропускную способность памяти ускорителя и более высокую производительность тензорных ядер в BFLOAT16, поэтому он лучше подходит для тяжелых ИИ- и HPC-нагрузок. Дополнительно ускорители SXM выигрывают по пропускной способности межсоединений, но за это приходится платить более высоким энергопотреблением и более жесткими требованиями к охлаждению. В свою очередь, ускорители PCIe обычно проще интегрируются в типовые серверы под ИИ, потребляют меньше энергии и дают больше гибкости при развертывании.
Аппаратное сравнение - PCIe и SXM
|
Параметр
|
PCIe
|
SXM
|
|
Пропускная способность памяти ускорителя
|
2 ТБ/с
|
3,35 ТБ/с
|
|
Объем памяти ускорителя
|
80 ГБ
|
80 ГБ
|
|
Производительность тензорных ядер BFLOAT16
|
1513 терафлопс
|
1979 терафлопс
|
|
Совместимость
|
Подходит для типовых серверов под ИИ - средний уровень применимости
|
Для HPC и тяжелых ИИ-нагрузок - основной сценарий
|
|
Энергопотребление (макс. TDP)
|
300-400 Вт
|
До 700 Вт
|
|
Количество транзисторов
|
80 млрд
|
80 млрд
|
|
Подключение к системной плате
|
Слоты PCIe
|
Прямое посадочное место на системной плате
|
|
Интерконнект
|
NVLink - 600 ГБ/сPCIe Gen5 - 128 ГБ/с
|
NVLink - 900 ГБ/сPCIe Gen5 - 128 ГБ/с
|
|
Охлаждение
|
Воздушное охлаждение или простое жидкостное охлаждение
|
Продвинутое воздушное охлаждение или жидкостные системы охлаждения повышенного класса
|
|
NVIDIA Enterprise
|
Входит в комплект
|
Дополнительная опция
|
Также из таблицы видно, что ускорители в форм-факторе SXM дают более высокую производительность и больший запас по масштабированию на будущее, тогда как PCIe обеспечивает больше гибкости, более низкое энергопотребление и лучшую экономическую эффективность.
NVIDIA H100 80GB GPU - графический ускоритель для ИИ и HPC-нагрузок на уровне центра обработки данных
NVIDIA H100 с 80 ГБ памяти - один из флагманских ускорителей для задач искусственного интеллекта и высокопроизводительных вычислений. Платформа построена на архитектуре Hopper и ориентирована на сценарии, где важны высокая плотность вычислений, пропускная способность памяти и масштабирование на несколько ускорителей в рамках сервера или группы серверов.
Ключевое назначение H100 - ускорение полного цикла работы с моделями: обучение становится быстрее за счет тензорных ядер четвертого поколения и механизма Transformer Engine с поддержкой FP8, а вывод модели (инференс) получает кратный прирост на больших языковых моделях. Для HPC-сценариев сделан упор на рост производительности в вычислениях двойной точности (FP64) и на поддержку DPX-инструкций, которые заметно ускоряют алгоритмы динамического программирования - там, где классические CPU-подходы становятся узким местом.
Отдельное преимущество SXM-платформы - масштабирование. Ускорители ориентированы на работу в многопроцессорных конфигурациях и используют NVLink и систему коммутации NVLink Switch для высокоскоростного обмена данными между ускорителями, в том числе в многосерверных развертываниях. Это важно для задач, где производительность упирается не только в вычисления, но и в передачу данных между ускорителями при распределенном обучении и параллельной обработке.
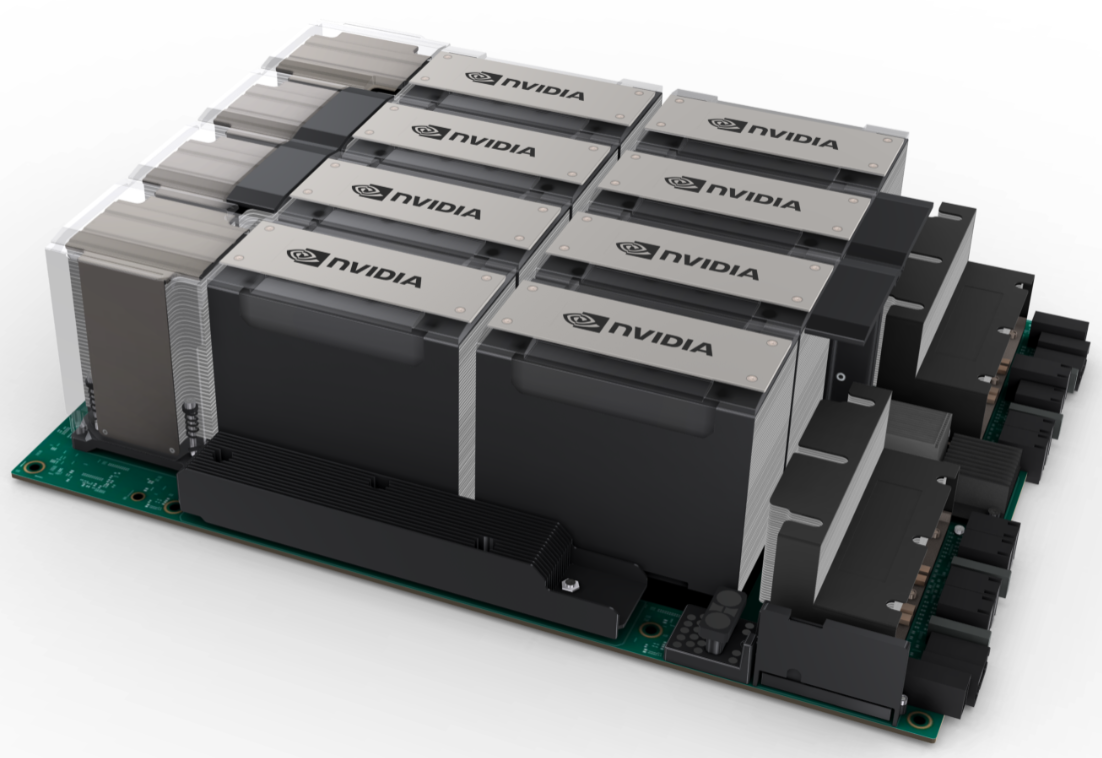
С точки зрения эксплуатации в корпоративной среде H100 дополняется механизмами разделения ресурсов и безопасности. Второе поколение MIG позволяет логически делить один ускоритель на изолированные экземпляры под разные команды или сервисы, удерживая качество обслуживания на предсказуемом уровне. Встроенные возможности конфиденциальных вычислений повышают защищенность данных и приложений в процессе выполнения, что особенно актуально для отраслей с повышенными требованиями к безопасности и контролю доступа.
NVIDIA H100 80GB целесообразно выбирать, когда требуется максимальная производительность и масштабирование в сервере и кластере: обучение и вывод больших языковых моделей, корпоративные ИИ-сервисы уровня центра обработки данных (диалоговые ассистенты, интеллектуальный поиск, рекомендации, компьютерное зрение), а также HPC-задачи, где критичны вычисления FP64 и ускорение динамического программирования - например, оптимизация маршрутов и логистики, графовая аналитика, расчеты в научных и инженерных моделях.
Сравнение серверов Dell PowerEdge для ИИ
Выбор ИИ-сервера сегодня - это не про "какой ускоритель быстрее", а про то, какая аппаратная платформа лучше держит нагрузку в реальных тестах. Поэтому дальше - прямое сравнение двух подходов в Dell PowerEdge: R760xa с NVIDIA H100 PCIe и XE9680 с NVIDIA H100 SXM. Сначала - короткие обзоры самих серверов, затем - результаты тестирования, где становится видно, как компоновка, питание и связность ускорителей превращаются в пропускную способность, задержки и фактическую загрузку GPU.
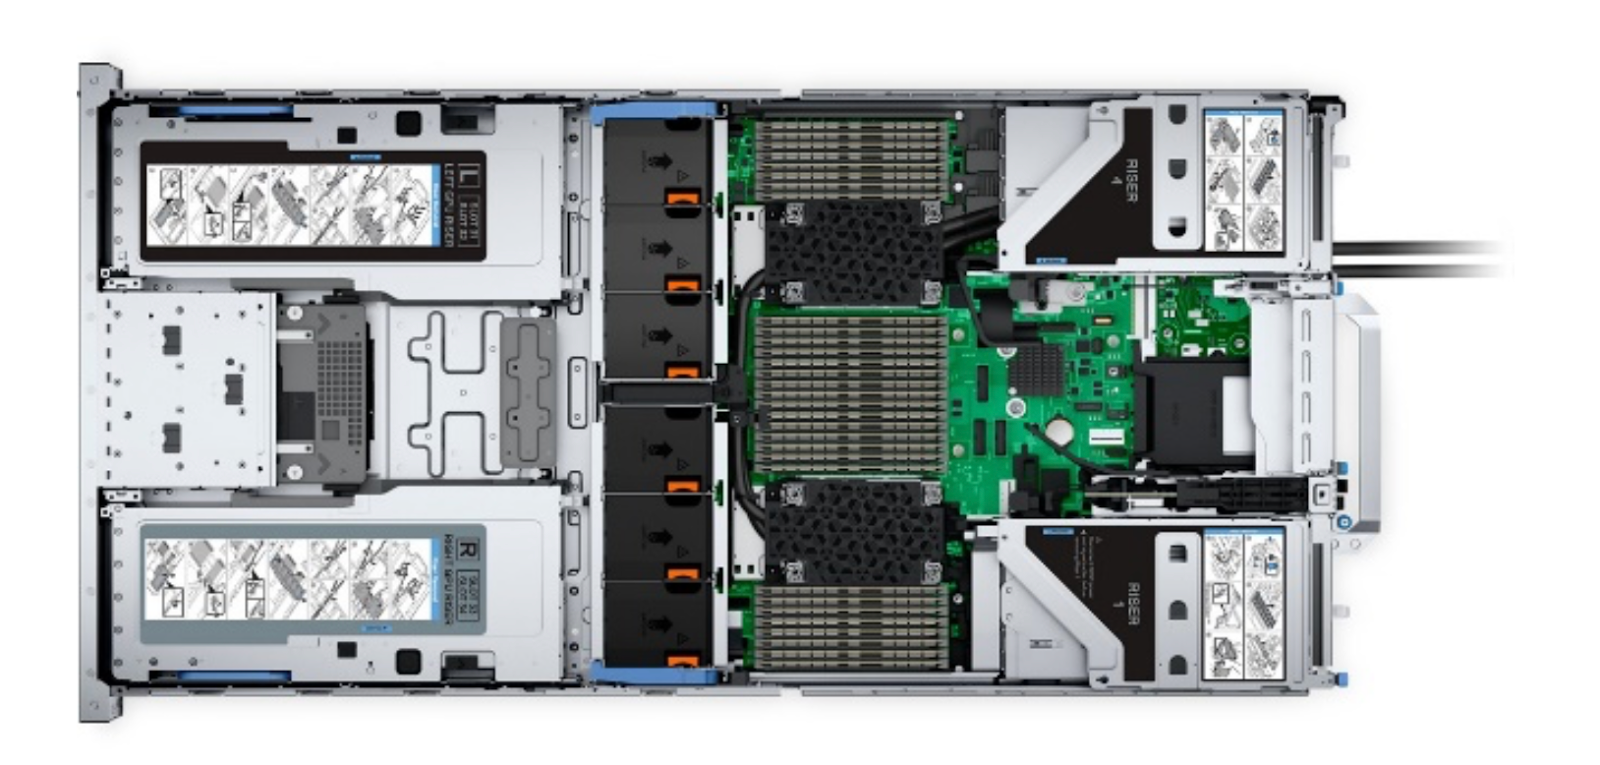
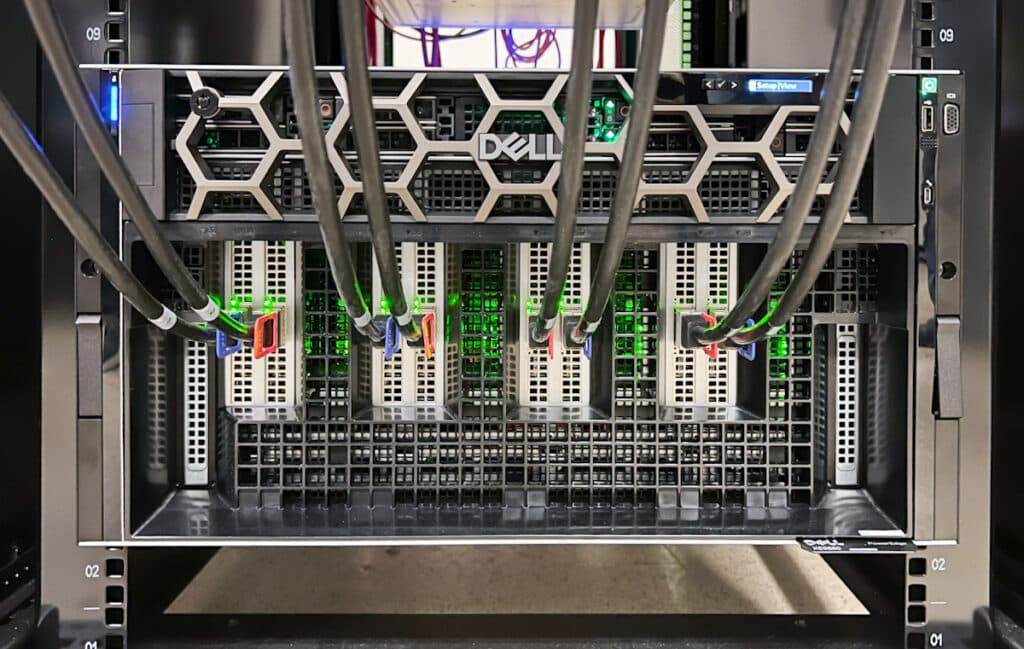
Сервер Dell PowerEdge R760xa - двухпроцессорный стоечный сервер форм-фактора 2U, рассчитанный на задачи с интенсивным использованием ускорителей: обучение и применение моделей машинного обучения, аналитика, а также VDI. В официальной спецификации указаны 32 слота DDR5 RDIMM (до 8 ТБ) и поддержка двух процессоров Intel Xeon Scalable 5-го поколения (до 64 ядер на процессор). Для локального хранилища доступны варианты до 6 дисков 2.5" NVMe (до 92.16 ТБ) или до 8 дисков 2.5" SAS-SATA-NVMe (до 122.88 ТБ).
H100 PCIe on R760xa
R760xa поддерживает до 4 ускорителей NVIDIA H100 в одном сервере (с возможностью парного соединения через NVLink Bridge).
Сервер Dell PowerEdge XE9680 - стоечный сервер форм-фактора 6U, ориентированный на тяжелые ИИ-нагрузки и крупные модели, где важны плотность вычислений и связность ускорителей внутри узла. В официальной спецификации ключевой акцент сделан на модульных ускорителях уровня HGX: поддерживаются конфигурации с 8 NVIDIA HGX H100 80GB 700W SXM5 (полная связность через NVLink), а также варианты с H200 и другими ускорителями.
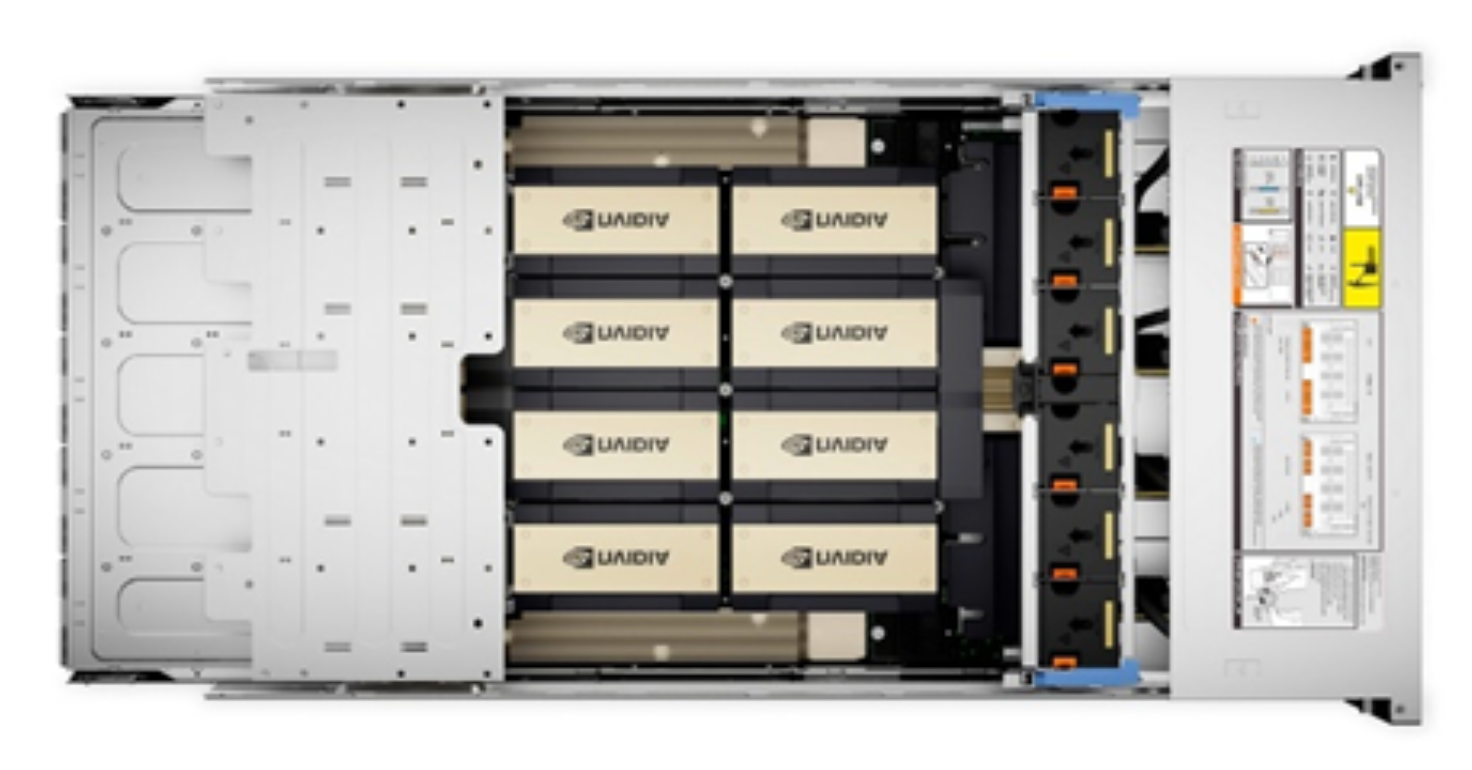
По CPU и памяти: два процессора Intel Xeon Scalable (4-го или 5-го поколения), 32 слота DDR5 RDIMM, но максимальный объем ниже, чем у R760xa - до 4 ТБ. По дискам - до 8 дисков 2.5" (NVMe-SAS-SATA) либо до 16 E3.S NVMe direct.
Сравнение R760xa и XE9680 по параметрам, которые непосредственно влияют на ИИ-проекты:
|
Параметр
|
PowerEdge R760xa
|
PowerEdge XE9680
|
|
Назначение
|
ИИ, машинное обучение, обучение и применение моделей глубокого обучения, высокопроизводительные вычисления, рендер-фермы и виртуализация
|
ИИ и машинное обучение, обучение моделей глубокого обучения на больших наборах данных, высокопроизводительные вычисления, CRISP и здравоохранение
|
|
Форм-фактор
|
2U
|
6U
|
|
Процессоры
|
До 2 x Intel Xeon Scalable 5-го поколения, до 64 ядер на CPU
|
2 x Intel Xeon Scalable 5-го поколения (до 64 ядер) или 4-го (до 56 ядер)
|
|
Память
|
32 слота DDR5 RDIMM, до 8 ТБ
|
32 слота DDR5 RDIMM, до 4 ТБ
|
|
Локальные диски (варианты)
|
До 6 x 2.5" NVMe (до 92.16 ТБ) или до 8 x 2.5" SAS-SATA-NVMe (до 122.88 ТБ)
|
До 8 x 2.5" NVMe-SAS-SATA (до 122.88 ТБ) или до 16 x E3.S NVMe direct (до 122.88 ТБ)
|
|
Ускорители - тип и идея
|
PCIe-ускорители, гибкая компоновка под задачи
|
HGX-ускорители SXM внутри узла, упор на связность и плотность
|
|
Ускорители H100
|
До 4 x NVIDIA H100
|
8 x NVIDIA HGX H100 80GB 700W SXM5 с NVLink
|
|
PCIe-расширение
|
До 12 PCIe-слотов
|
До 10 слотов PCIe Gen5 x16
|
|
Питание и охлаждение - смысл для проекта
|
Проще вписывается в стандартные стойки и контуры охлаждения, ниже порог входа
|
Требует более строгого планирования питания и охлаждения, рассчитан на высокий теплопакет узла
|
R760xa целесообразен в сценариях, где важен баланс производительности и гибкости - для пилотов и ввода ИИ в эксплуатацию, прикладных задач (включая VDI и аналитику) и наращивания мощности за счет увеличения числа серверов в кластере без резкого усложнения требований к площадке. XE9680 логичен там, где один узел должен обеспечивать максимальную плотность ускорителей и высокую скорость обмена данными между ними - для обучения и применения крупных моделей и других требовательных нагрузок, в которых внутренняя связность и масштабирование внутри сервера важнее универсальности.
Тестирование GPU H100 PCIe и SXM по пропускной способности, задержкам и производительности на ватт
Чтобы сравнение двух моделей ускорителей по пропускной способности, задержкам и загрузке GPU было честным, все тесты выполнялись в одинаковых условиях - использовалась одна и та же версия vLLM, одинаковые параметры и типы точности. Конфигурация теста включала BFloat16 и модель Llama2 7b, а сервис vLLM обслуживал один одновременный запрос. Такой подход позволяет трактовать различия в результатах как следствие именно особенностей форм-факторов и их аппаратной реализации.
Пропускная способность
Большие языковые модели работают с единицей данных, которую обычно называют токенами. Пропускная способность показывает, сколько токенов в секунду модель способна обработать в конкретном сценарии, и это один из базовых показателей при оценке ИИ-платформы - он количественно отражает, насколько эффективно система обрабатывает входные данные и генерирует ответ. Чтобы глубже понять, как поведение токенов влияет на пропускную способность и общую производительность, полезно отдельно разобрать механику токенов и то, почему она влияет на выбор ускорителя.
Как видно на графике ниже, одиночный NVIDIA H100 в форм-факторе SXM обеспечивает примерно на 30% более высокую пропускную способность, чем одиночный NVIDIA H100 в форм-факторе PCIe. На практике это означает, что SXM-исполнение может обработать больше токенов за то же время, а значит - дать более высокий темп работы в типовых ИИ-нагрузках.
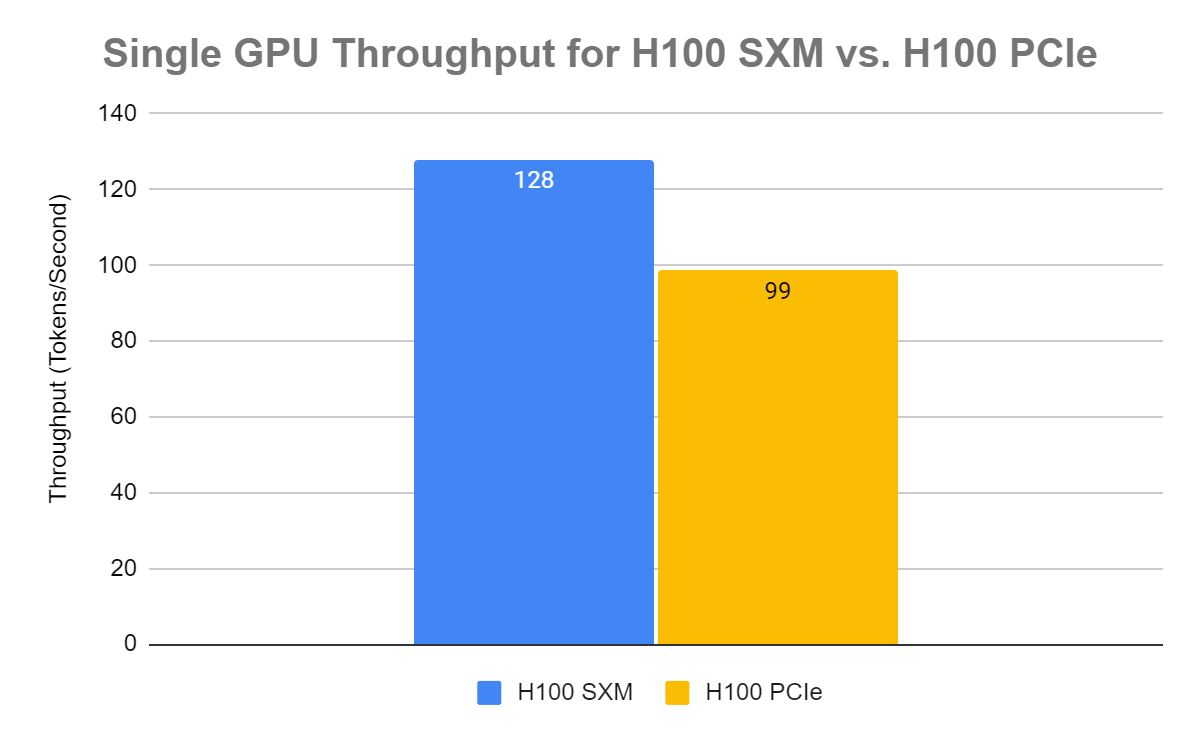
Сравнение пропускной способности H100 PCIe и H100 SXM на модели Llama2 7B в точности BFloat16 при одном одновременном запросе
NVIDIA H100 SXM показывает пропускную способность 128 токенов в секунду, тогда как NVIDIA H100 PCIe - 98,8 токена в секунду. Это означает не только более высокий "сырой" темп работы у SXM, но и более эффективную обработку токенов при одинаковых условиях тестирования, что подтверждает его преимущество в ресурсоемких ИИ-нагрузках.
Теперь перейдем к задержкам и посмотрим, чем отличаются два форм-фактора.
Задержки
Наверняка знакомо ощущение, когда чат-бот отвечает с паузой и кажется, что он "думает" слишком долго. В этот момент модель обрабатывает запрос, запускает генерацию токенов и формирует ответ - все это происходит за доли секунды, но задержка заметна пользователю.
В сравнении задержек между двумя форм-факторами на модели Llama2 7B в точности BFloat16 разница практически отсутствует. В обоих случаях задержка составляет около 12 миллисекунд, при этом в тестировании NVIDIA H100 SXM показал немного более низкое значение.
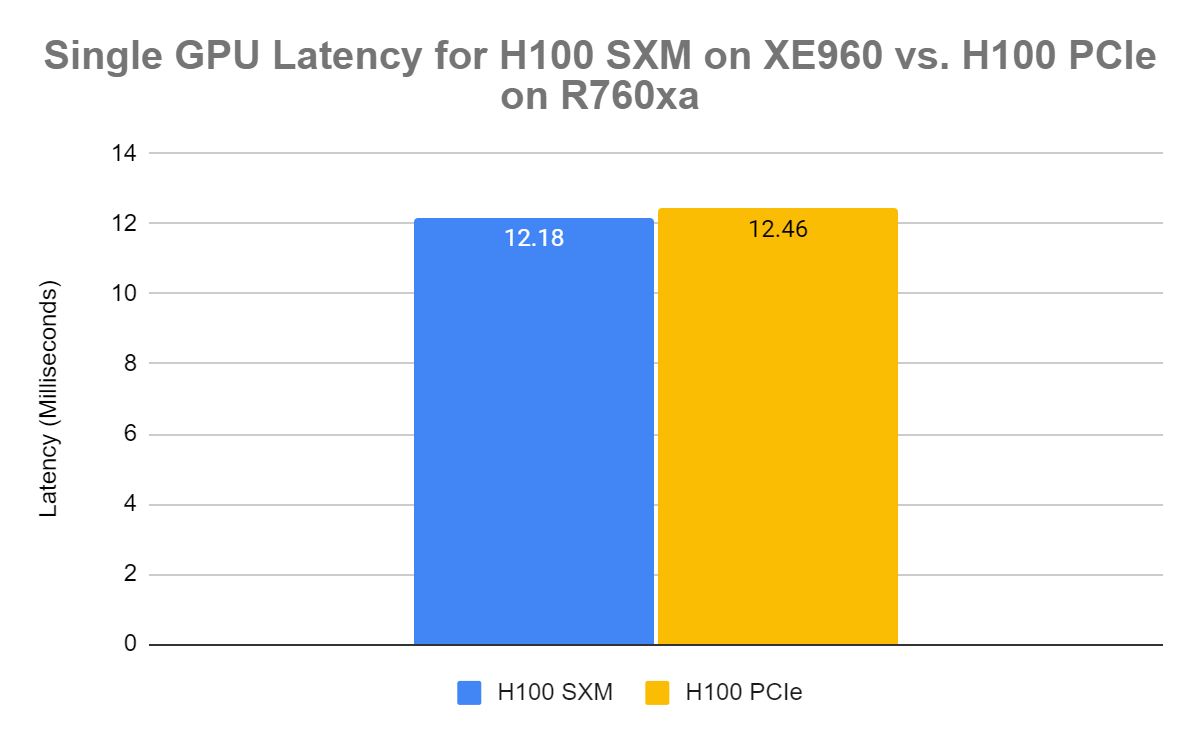
Сравнение задержек H100 PCIe и H100 SXM на модели Llama2 7B в точности BFloat16 при одном одновременном запросе
Важно: метрика задержки в этом тесте отражает среднее время, за которое модель начинает генерировать первый токен по всем измеренным запросам.
В сравнении задержек обе конфигурации - NVIDIA H100 SXM и NVIDIA H100 PCIe - показывают высокую отзывчивость на уровне 0,012 секунды. При этом по мере роста нагрузки и усложнения сценария у SXM-платформы потенциально появляется преимущество по задержкам.
После сравнения пропускной способности и задержек неизбежно возникает главный вопрос: PCIe или SXM?
PCIe или SXM?
Ключевые выводы по результатам тестов: NVIDIA H100 SXM дает примерно на 30% более высокую пропускную способность, чем NVIDIA H100 PCIe, а задержка при одном одновременном запросе остается примерно одинаковой - около 12 миллисекунд.
Итоговый выбор между NVIDIA H100 PCIe и NVIDIA H100 SXM определяется конкретным сценарием внедрения и приоритетами. PCIe-формат, который используется в PowerEdge R760xa, дает максимально совместимое решение "на один ускоритель" для широкого спектра задач и проще опирается на стандартную серверную инфраструктуру. Однако при росте потребности в ускорителях уплотнение SXM в одном сервере может оказаться более рациональным по энергопотреблению, чем увеличение числа серверов с PCIe. Поэтому PCIe особенно уместен там, где критична доступность типовой инфраструктуры, например в малых и средних центрах обработки данных или в корпоративных площадках, где место в стойках и лимиты по электропитанию являются жесткими ограничениями.
SXM-формат, представленный в PowerEdge XE9680, дает заметное преимущество в тяжелых ИИ- и HPC-нагрузках в первую очередь за счет более высокой пропускной способности. Это делает его более подходящим для сценариев, где нужен высокий темп обработки - например для задач, близких к реальному времени, или для крупномасштабных вычислений. При этом масштабирование SXM усиливает вертикальное наращивание внутри дата-центра: выше плотность и мощность на единицу площади без непропорционального роста эксплуатационных затрат.
В практическом смысле выбор PCIe или SXM зависит от цели развертывания ИИ-нагрузок и баланса между мгновенной производительностью и долгосрочной операционной эффективностью. Для корректного решения стоит оценивать как минимум интенсивность нагрузки, требуемый масштаб, энергопотребление и бюджетные ограничения.






Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!