Сегодня компании и научные центры работают с колоссальными объемами данных, развивают нейросети и внедряют искусственный интеллект в бизнес-процессы. Для таких задач требуются не просто мощные серверы, а специализированные GPU-системы, способные выполнять миллионы операций одновременно.
Что такое GPU-сервер и зачем он нужен
GPU-сервер — это вычислительная платформа, в которой ключевую роль играют графические процессоры (GPU). В отличие от традиционных серверов, где основная нагрузка ложится на CPU, здесь именно GPU отвечают за массово-параллельные вычисления, обработку массивов данных и ускорение алгоритмов ИИ. За счет тысяч CUDA-ядер (у NVIDIA) или потоковых процессоров (у AMD) они позволяют выполнять миллионы операций одновременно, что критически важно для обучения нейросетей, рендеринга 3D-графики и высокопроизводительных научных расчетов.
В 2025 году GPU-серверы стали обязательным элементом инфраструктуры во многих сферах: от дата-центров и облачных платформ до корпоративных систем аналитики. Их используют компании, которым нужны быстрые результаты и высокая скорость работы с данными. Применение охватывает финансовый сектор, здравоохранение, телекоммуникации, научные центры и даже развлекательную индустрию.
Основные виды GPU-серверов
Серверы с дискретными видеокартами (NVIDIA, AMD, Intel)
Такие решения оснащаются профессиональными серверными видеокартами и предназначены для задач, где критична работа с графикой и визуализацией. В них устанавливаются карты с большим объемом видеопамяти (16–48 ГБ и выше), которые поддерживают аппаратное ускорение рендеринга, работу с виртуальными рабочими местами и видеоаналитику.
Пример: сервер OpenYard RS201I может быть доукомплектован видеокартами NVIDIA RTX, что делает его подходящим для обработки видео, VDI и аналитических нагрузок. Такие системы актуальны в среде медиакомпаний, архитектурных бюро и организаций, которые используют CAD/CAM-системы.
Серверы с ускорителями вычислений (NVIDIA Tesla, Hopper, Blackwell, AMD Instinct)
Задача такого оборудования не визуализация, а чистая математика. Например, NVIDIA H100 оснащается 80 ГБ HBM3, а более новое решение H200 — уже 141 ГБ HBM3e с пропускной способностью до 4,8 ТБ/с. Ускоритель AMD Instinct MI300X имеет 192 ГБ HBM3 и свыше 5 ТБ/с полосы памяти. Эти объемы позволяют эффективно обучать большие языковые модели, проводить прогнозные расчеты, биоинформатический анализ и сложные симуляции. Подобные ускорители незаменимы в суперкомпьютерах и HPC-кластерах, где даже несколько процентов прироста производительности означают экономию тысяч часов вычислений.
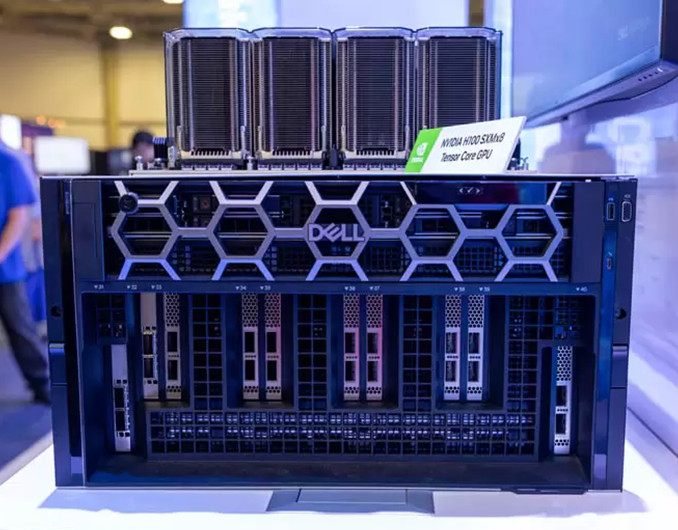
Пример: сервер Dell PowerEdge XE9680 в конфигурации с восемью ускорителями класса NVIDIA H100/H200 или AMD Instinct MI300X и высокоскоростным NVMe-массивом ориентирован на «чистую математику» — обучение и дообучение LLM, крупномасштабный инференс, моделирование для HPC и биоинформатику. Платформа обеспечивает связанность GPU по высокоскоростной шине, требуемую полосу ввода-вывода и предсказуемый термопрофиль (воздушное или жидкостное охлаждение), поэтому востребована в корпоративных и исследовательских центрах, суперкомпьютерных узлах и производственных R&D-подразделениях, где даже небольшой прирост производительности конвертируется в тысячи сэкономленных часов вычислений.
Гибридные решения (CPU+GPU)
В гибридных серверах CPU обрабатывает последовательные задачи, например подготовку данных или работу с транзакциями, а GPU берет на себя массово-параллельные вычисления. Такой симбиоз идеально подходит для систем искусственного интеллекта, аналитических платформ и крупных баз данных.
В гибридных архитектурах активно применяется CXL Type-3 память, которая позволяет расширять объем RAM до нескольких терабайт и устранять узкие места при работе с большими наборами данных. При этом стоит учитывать, что Intel Optane PMem (серии 100/200) объявлен EOL, финальные поставки завершатся к концу 2025 года, поэтому его рассматривают только для поддержки существующих инсталляций. Новые проекты ориентируются на использование MRDIMM/MCR-DIMM DDR5-8800 и CXL Type-3 DRAM-expander, которые обеспечивают кратный прирост пропускной способности и масштабируемости в современных системах.
Пример: сервер Lenovo ThinkSystem SR650 V4 — типичный «гибрид» под CPU+GPU-нагрузки: два процессора Intel Xeon 6 и до 2× DW или до 10× SW ускорителей позволяют разворачивать смешанные пайплайны ИИ, аналитики и СУБД, где CPU ведёт подготовку/транзакции, а GPU выполняет массово-параллельные расчеты. Ключевое преимущество — масштабирование памяти новыми средствами: официально заявлена поддержка MRDIMM DDR5 с высокой пропускной способностью (в спецификации указаны конфигурации до 16 MRDIMM со скоростями до 8000 МГц), а также CXL Type-3 (CXL memory modules, форм-фактор E3.S 2T) для наращивания объёма и разгрузки узких мест при работе с большими наборами данных. Такие конфигурации востребованы в корпоративных DWH/BI-платформах, системах оперативной аналитики и сервисах ИИ, где важны и транзакционные потоки, и ускоренный инференс/ML-преобразования в одном узле.
Ключевые области применения GPU-серверов
Искусственный интеллект и машинное обучение
Сегодня обучение больших языковых моделей (LLM), рекомендательных систем или систем компьютерного зрения без GPU практически невозможно. Графические процессоры ускоряют обучение нейросетей в десятки раз по сравнению с CPU. Они поддерживают фреймворки PyTorch, TensorFlow, MXNet, обеспечивают распределенное обучение на десятках узлов и позволяют обрабатывать массивы данных в сотни терабайт. Компании, работающие с LLM, используют серверы с поддержкой до 8–16 GPU в одном корпусе для максимальной эффективности.
Высокопроизводительные вычисления (HPC)
GPU стали стандартом для суперкомпьютеров. Их используют для задач молекулярной динамики, симуляции климатических условий, аэродинамики и моделирования свойств материалов. Благодаря способности одновременно обрабатывать множество операций графические процессоры всего за несколько дней справляются с расчетами, которые раньше занимали месяцы. В 2025 году большинство научных центров проектируют свои кластеры с учетом использования GPU-серверов.
Рендеринг и 3D-моделирование
Визуализация в архитектуре, кино и гейм-дизайне требует колоссальных вычислительных ресурсов. GPU-серверы позволяют обрабатывать сцены в реальном времени, использовать трассировку лучей (ray tracing) и рендерить проекты, которые раньше занимали сутки, всего за несколько часов. Использование серверов с RTX-картами позволяет работать с графикой уровня VR и AR-проектов.
Криптовалютный майнинг
Хотя хайп вокруг криптовалютного майнинга снизился, в некоторых сферах GPU-серверы по-прежнему применяются для добычи монет, основанных на алгоритмах с интенсивными графическими вычислениями.
Серверы для облачного гейминга
Cloud gaming — новый тренд, где пользователи запускают игры на удаленных GPU-серверах, а картинка транслируется на их устройства. Для этого нужны мощные видеокарты с поддержкой виртуализации.
Топовые модели GPU-серверов на рынке
Серверные ускорители NVIDIA DGX серии (A100, H100)
- Модели линейки DGX стали эталоном для AI-нагрузок и HPC-вычислений. Первая модель — DGX A100 — была представлена в 2020 году и оснащалась 8 ускорителями NVIDIA A100 с поддержкой NVLink, ставшей стандартом для систем обучения крупных моделей.
-
Следующее поколение — DGX H100 — получило 8 ускорителей NVIDIA Hopper с интерконнектом NVLink 4, обеспечивающим до 900 ГБ/с пропускной способности на GPU. Такая конфигурация оптимальна для обучения языковых моделей с триллионами параметров и масштабных научных расчетов.
-
В 2025 году NVIDIA представила архитектуру Blackwell. Базовым ускорителем стала модель B200 Tensor Core GPU. На их основе создаются серверные платформы HGX B200, объединяющие до 8 GPU через NVLink с суммарной пропускной способностью в десятки терабайт в секунду, а также готовые решения DGX B200. Эти системы обеспечивают кратный прирост производительности при работе с LLM и генеративным ИИ и формируют основу AI-инфраструктуры гипермасштабируемых дата-центров.
Ускорители базе AMD Instinct MI300
AMD сделала серьезный шаг вперед с серией Instinct MI300, представив два ключевых варианта архитектуры.
- MI300A — это гибридный ускоритель (APU), который совмещает CPU и GPU в одном модуле, что снижает задержки обмена данными и повышает эффективность при работе с большими массивами информации.
- MI300X — дискретный GPU с 192 ГБ HBM3 и пропускной способностью свыше 5 ТБ/с, ориентированный на обучение больших языковых моделей и задачи генеративного ИИ. Серия MI300 активно применяется в HPC-кластерах, аналитике научных данных, а также в энергетике и фармацевтике.
Решения от Dell, HPE и Supermicro
- Dell PowerEdge R760xa поддерживает до 4 ускорителей двойной ширины (DW) или до 12 ускорителей однослотового формата (SW) и оптимизирован для задач искусственного интеллекта, аналитики и работы с большими базами данных.
- HPE ProLiant DL380a Gen12 — 4U-платформа на Intel Xeon 6 с поддержкой до 8 DW-GPU (до 600 Вт каждая), включая конфигурации с NVIDIA H200 NVL и NVLink-бриджами и ориентирована на высокоплотный инференс LLM, VDI и смешанные AI-нагрузки.
- Supermicro GPU SuperServer 420GP-TNR вмещает до 10 GPU, что делает его одной из самых плотных конфигураций на рынке для LLM и генеративного ИИ.
Гибридные серверы с Intel Max Series GPU
Intel предлагает линейку Max Series (Ponte Vecchio), ориентированную на суперкомпьютеры и научные центры. Их ключевым преимуществом остается глубокая интеграция с процессорами Xeon и поддержка CXL-памяти.
В 2025 году основное внимание Intel сосредоточено на ускорителях Gaudi 3, разработанных специально для AI-кластеров и обучения больших языковых моделей. Они показывают более высокую эффективность при работе с генеративным ИИ и масштабируемыми инфраструктурами, чем Max Series, и становятся прямыми конкурентами NVIDIA H100/B100 в сегменте AI-нагрузок.
В сентябре 2025 года Dell Technologies представила сервер PowerEdge XE7740, ставший первым на рынке интегрированным решением с новым ускорителем искусственного интеллекта Intel Gaudi 3 PCIe. Этот мощный 4U-сервер объединяет простоту интеграции линейки R-Series с высокой масштабируемостью платформы XE, специально разработанной для ускорения внедрения ИИ в корпоративном секторе.
Как выбрать GPU-сервер под конкретные задачи
Производительность, энергопотребление, масштабируемость
Для задач ИИ нужны ускорители с большим количеством CUDA-ядер и памятью HBM3. Для рендеринга — RTX-карты с аппаратной поддержкой трассировки лучей. Для HPC — энергоэффективные решения с возможностью масштабирования. Также необходимо учитывать совокупное энергопотребление.
Особенности подключения и охлаждения GPU
В 2025 году активно используются жидкостные контуры и вертикальная компоновка карт. Форм-фактор также играет роль: в стандартные 2U сервера помещается до 4 GPU, тогда как 4U модели вмещают до 8–10 ускорителей. Multi-node и OCP-системы позволяют достигать еще большей плотности при снижении затрат на инфраструктуру.
Программная поддержка и драйверы
GPU-сервер должен быть совместим с драйверами и библиотеками CUDA, ROCm, а также поддерживать популярные фреймворки машинного обучения. Для облачного гейминга и VDI критична поддержка технологий виртуализации NVIDIA vGPU (ранее известных как GRID), включая такие решения, как RTX Virtual Workstation (RTX vWS), vPC, vApps и vCS. Эти пакеты обеспечивают разделение графических ресурсов между множеством пользователей и стабильную работу приложений. Также важно учитывать совместимость с гипервизорами VMware, KVM, Proxmox и OpenStack.
Будущее GPU-серверов и перспективные технологии
В ближайшие годы GPU-серверы станут еще более гибкими и масштабируемыми. Среди ключевых трендов 2025 года:
- использование SmartNIC и DPU для разгрузки CPU и ускорения сетевых операций;
-
широкое внедрение NVMe-over-TCP и CXL Type-3 памяти для повышения пропускной способности и масштабируемости;
-
массовое распространение архитектур Ada Lovelace, Hopper и Blackwell (B100/B200) для AI и HPC;
-
рост популярности модели аренды GPU-серверов как услуги (IaaS);
-
развитие вертикальных GPU-серверов с высокой плотностью размещения и простотой обслуживания;
-
усиление тренда на Scale-out HCI с GPU, где можно масштабировать инфраструктуру по отдельным ресурсам — только вычислительные узлы или только хранилище, что делает такие кластеры особенно удобными для AI/ML и больших данных.
Примеры GPU-серверов от российских производителей
Российские вендоры тоже активно развивают направление GPU-серверов.
- Гравитон C2122A используется для машинного обучения и корпоративной аналитики. Он поддерживает несколько GPU и оптимизирован под отечественные ОС.
- OpenYard RS201I — флагманская модель, которая может быть укомплектована NVIDIA RTX. Подходит для аналитики, работы с графикой и систем больших данных.
- Yadro Vegman — универсальная платформа, где есть поддержка серверных видеокарт. Применяется для работы с виртуальными машинами и решения ИИ-задач.
Заключение
GPU-серверы в 2025 году стали ключевым элементом цифровой инфраструктуры. Они используются для нейросетей, рендеринга, анализа данных и облачных сервисов. Если раньше такие решения применялись только в крупных корпорациях, сегодня они доступны и среднему бизнесу по модели аренды. При выборе важно учитывать задачи компании, необходимую производительность и программную совместимость.






Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!