Бурный рост нагрузок генеративного ИИ и спроса на высокопроизводительную инфраструктуру ставит организации перед выбором: инвестировать в собственные мощности или опираться на облако. В статье рассматривается совокупная стоимость владения с фокусом на сценариях ИИ/машинного обучения, прежде всего на крупных языковых моделях, где доля инфраструктурных затрат максимальна.
Анализ намеренно ограничен базовыми статьями расходов — аппаратным обеспечением и фактическим использованием ресурсов. Вне рамок остаются сеть, инженерная инфраструктура площадки и типовые ИТ-операции — для того, чтобы сравнение было наглядным и применимым.
Введение
Генеративный ИИ — от крупных языковых до визуальных моделей — стал технологией, которая меняет отрасли. Но внедрение таких моделей для обучения, дообучения и инференса упирается в значительные вычислительные требования.
Масштабы данных впечатляют. К примеру, Llama 3.1 обучалась на более чем 15 трлн токенов на специализированном кластере, суммарно занявшем 39,3 млн GPU-часов. Подобные проекты при использовании облака обходятся чрезвычайно дорого: гипотетический запуск на экземплярах класса AWS P5 с NVIDIA H100 может превысить 483 млн долларов США, не считая хранения обучающего датасета. Поэтому стратегия развертывания должна оцениваться через призму экономики: сопоставлять собственную инфраструктуру и облачные сервисы.
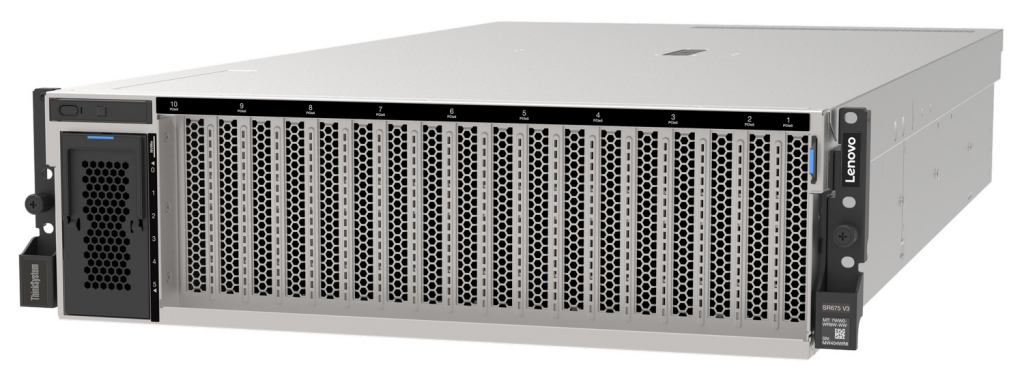
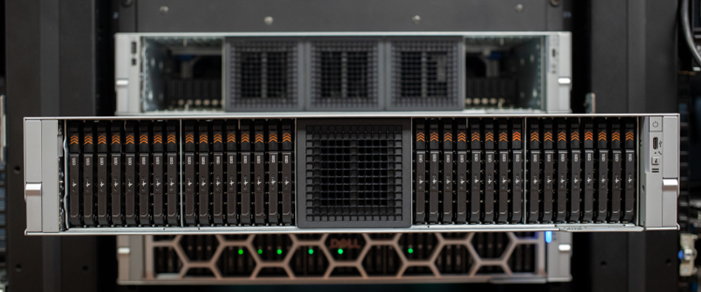
Сервер Lenovo ThinkSystem SR675 V3 с поддержкой восьми двухслотовых GPU — характерный пример локальной платформы для генеративного ИИ
Жизненный цикл моделей GenAI включает две ключевые фазы: обучение на новых данных и инференс - применение уже обученной модели ИИ для выдачи результата. Обучение потребляет гигантские массивы данных и длительное время вычислений. Инференс менее требователен к ресурсам на один запрос, но требует устойчивых низких задержек и масштабирования по мере роста аудитории. Для продолжительных обучающих задач и постоянного высокопроизводительного инференса собственные мощности дают заметные преимущества: фиксированные капитальные затраты и высокая утилизация выделенных GPU формируют более выгодную экономику. Облако же масштабируется линейно с потреблением, что делает его удобным для пилотов и «пиков», но менее эффективно при постоянной нагрузке.
Анализ компонентов стоимости: локальная инфраструктура и облако
При выборе между развертыванием генеративных моделей ИИ в собственной инфраструктуре и в облаке ключевым становится понимание структуры затрат. Каждый вариант формирует свой профиль расходов и по-разному влияет на бюджет и операционную эффективность.
Локальная инфраструктура опирается на капитальные вложения и предсказуемую утилизацию ресурсов. Облако предлагает гибкость и быстрый старт, но переносит основную часть расходов в операционные и делает итоговую стоимость чувствительной к длительности и интенсивности использования.
|
Статья затрат
|
Локальная инфраструктура
|
Облако
|
|
Капитальные вложения (CapEx)
|
Высокие начальные инвестиции (серверы, графические ускорители и т. п.)
|
Отсутствуют, расходы переводятся в операционные по модели «плати по мере использования»
|
|
Операционные расходы (OpEx)
|
Электроэнергия, охлаждение, персонал, эксплуатационные расходы площадки
|
Регулярные платежи за сервисы, хранилище, сетевой трафик
|
|
Программное обеспечение и лицензии
|
Покупка бессрочных лицензий или ежегодная подписка
|
Входит в тариф провайдера или рассчитывается по фактическому потреблению
|
|
Масштабирование
|
Ограничено физической ёмкостью, расширение через закупку/аренду/лизинг
|
Практически неограниченное, эластичное масштабирование
|
|
Конфиденциальность и безопасность данных
|
Полный контроль, настраиваемые политики - данные остаются внутри собственной инфраструктуры
|
Обработка вне площадки - соблюдение политик провайдера
|
|
Обновление парка и амортизация
|
Жизненный цикл 3–5 лет, требуется плановое обновление оборудования
|
Скрыто от клиента - непрерывные обновления выполняет провайдер
|
И локальное развертывание, и облако формируют разные профили затрат и рисков. Локальная модель требует значительных авансовых вложений и постоянных эксплуатационных расходов. Облако дает гибкость, но несет риски непредвиденных списаний, зависимости от поставщика и обязательств по длительным контрактам.
Локальная инфраструктура обеспечивает больший контроль над чувствительными данными: хранение и обработка находятся в пределах корпоративного периметра. В облачной среде выше регуляторная сложность из-за участия третьих лиц и разделяемой инфраструктуры, что усложняет вопросы конфиденциальности, соответствия требованиям и «цифрового суверенитета» данных. Понимание этих факторов необходимо, чтобы сопоставить решение с финансовыми возможностями и стратегическими целями организации.
Затраты на локальное развертывание
Локальная инфраструктура предполагает существенные капитальные вложения в серверы, графические ускорители, системы хранения, а также в инженерную инфраструктуру — охлаждение и площади. Эти системы требуют регулярного обслуживания, а текущие расходы (электроэнергия, лицензии ПО) добавляют к совокупной стоимости владения. При этом такой подход обеспечивает предсказуемость и лучшую экономику на длительном горизонте, особенно для стабильных нагрузок ИИ с высокой утилизацией ресурсов. В состав затрат входят:
-
Стоимость GPU-узлов. Цена самих ускорительных серверов/модулей, зависящая от типа и количества GPU.
-
Оперативная память и хранение данных. Объем и скорость памяти/СХД, необходимые для работы ускорителей и датасетов.
-
Электропитание и охлаждение. Потребляемая мощность и тепловыделение оборудования напрямую влияют на стоимость владения.
Границы анализа стоимости
Совокупная стоимость владения может включать куда больше факторов: лицензии ОС и прикладного ПО, обновления и патчи, сетевую инфраструктуру, фонд оплаты труда ИТ-персонала, межрегиональные различия тарифов связи, обслуживание программного стека и др. В рамках данного материала сравнение умышленно ограничено инфраструктурой (прежде всего вычислительным «железом») и расходами на электроэнергию и охлаждение. Такая фокусировка позволяет корректно сопоставить локальные и облачные сценарии для типичных высоконагруженных задач инференса и обучения. Следует учитывать, что в реальных проектах возникают дополнительные статьи расходов, не попавшие в этот анализ.
Затраты на облачное развертывание
Облако обеспечивает гибкость за счет оплаты по факту потребления и управляемых сервисов, снижая стартовые капитальные вложения. Однако суммарные расходы быстро растут из-за плат за хранение, передачу и извлечение данных, а также поминутной тарификации вычислений. Долгосрочные обязательства дают скидки, но уменьшают свободу маневра; переменная нагрузка и зависимость от поставщика усложняют прогнозирование бюджета. Для краткосрочных или динамичных задач облако остается удобным выбором, но при длительной стабильной эксплуатации, как будет показано далее, зачастую оказывается дороже локальной инфраструктуры.
Границы анализа стоимости
В этом сравнении сопоставляется совокупная стоимость владения у ведущих облачных платформ — AWS, Google Cloud Platform (GCP) и Microsoft Azure — с локальной инфраструктурой на базе серверов Lenovo. Фокус: закупка серверов, потребление электроэнергии и охлаждение. Ради сопоставимости исключены дополнительные облачные статьи затрат: управляемые сервисы (например, AWS Bedrock), хранилища данных (AWS EBS/S3) и плата за трафик. Сравнение опирается на почасовые тарифы вычислительных экземпляров уровня EC2-класса. Рассматриваются как on-demand цены, так и скидки по 1- и 3-летним планам экономии, после чего они напрямую сопоставляются с почасовой себестоимостью эксплуатации локальных узлов.
Сравнение стоимости: локально vs облако
Далее оценивается совокупная стоимость владения по трем типовым сценариям и для репрезентативного набора из семи серверных конфигураций. Фокус — на трех классах GPU, характерных для задач генеративного ИИ: NVIDIA H100, H200 и L40S. Для каждой локальной конфигурации серверов Lenovo подбирается функционально сопоставимый облачный экземпляр у провайдеров AWS и GCP.
|
Сервер
|
Конфигурация локального сервера
|
Облачный эквивалент
|
|
Сервер 1
|
ThinkSystem SR675 V3 — 8× NVIDIA H100 NVL 94 ГБ, PCIe Gen5
|
Amazon AWS EC2 p5.48xlarge — 8× NVIDIA Tesla H100
|
|
Сервер 2
|
ThinkSystem SR675 V3 — 8× NVIDIA H200 NVL 141 ГБ, PCIe Gen5
|
Amazon AWS EC2 p5en.48xlarge — 8× NVIDIA Tesla H200
|
|
Сервер 3
|
ThinkSystem SR675 V3 — 4× NVIDIA H100 NVL 94 ГБ
|
Google GCP a3-highgpu-4g — 4× NVIDIA H100 80 ГБ
|
|
Сервер 4
|
ThinkSystem SR675 V3 — 8× NVIDIA L40 48 ГБ PCIe*
|
Google GCP a2-ultragpu-8g — 8× NVIDIA A100 80 ГБ
|
|
Сервер 5
|
ThinkSystem SR650 V3 — 1× NVIDIA L40S 48 ГБ, Intel Xeon Silver 4514Y (16 ядер, 150 Вт, 2,0 ГГц)
|
Amazon AWS EC2 g6e.8xlarge — 1× NVIDIA L40S Tensor Core GPU
|
|
Сервер 6
|
ThinkSystem SR650 V3 — 1× NVIDIA L40S 48 ГБ PCIe Gen4, Intel Xeon Gold 6530 (32 ядра, 270 Вт, 2,1 ГГц)
|
Amazon AWS EC2 g6e.16xlarge — 1× NVIDIA L40S Tensor Core GPU
|
|
Сервер 7
|
ThinkSystem SR650a V4 — 4× NVIDIA L40S 48 ГБ PCIe Gen4, Intel Xeon 6747P (48 ядер, 330 Вт, 2,7 ГГц)
|
Amazon AWS EC2 g6e.24xlarge — 4× NVIDIA L40S Tensor Core GPU
|
Чтобы не перегружать статью, ниже приведены расчеты только для Сервера 1, а полные данные по остальным конфигурациям вынесены в отдельные документы - ссылки на них можно найти внизу статьи.
Сценарии сравнения:
-
Анализ точки безубыточности — когда локальный вариант становится экономичнее облака.
-
Стоимость владения и экономия во времени — динамика суммарных затрат и накопленная разница.
-
Порог утилизации по часам — минимальная загрузка, при которой локальная система оправдывает себя.
Сценарий 1. Точка безубыточности
В этом сценарии определяется момент, когда накопленные расходы на облако сравниваются с общей стоимостью локальной инфраструктуры. До этой точки облако может быть экономичнее, а после — локальный вариант обеспечивает бóльшую долгосрочную экономию.
Пример (Сервер 1). ThinkSystem SR675 V3 с 8× NVIDIA H100 NVL 94 ГБ PCIe Gen5. Облачный аналог — Amazon EC2 p5.48 x large: 8× NVIDIA H100, 192 vCPU и 2048 GiB памяти. Для наглядности сравнивается одна серверная конфигурация, а не стойка.
-
On-Demand (облако): 98,32 $/час
-
Резерв на 1 год (облако): 77,43 $/час
-
Локально: питание+охлаждение: ≈ 0,87 $/час (по 0,15 $/кВт⋅ч для сервера и HVAC)
-
Локально: стоимость системы: ≈ 833 806 $ (без учета скидок)
Модель затрат:
Ищем точку безубыточности при cloud_cost = onprem_cost:
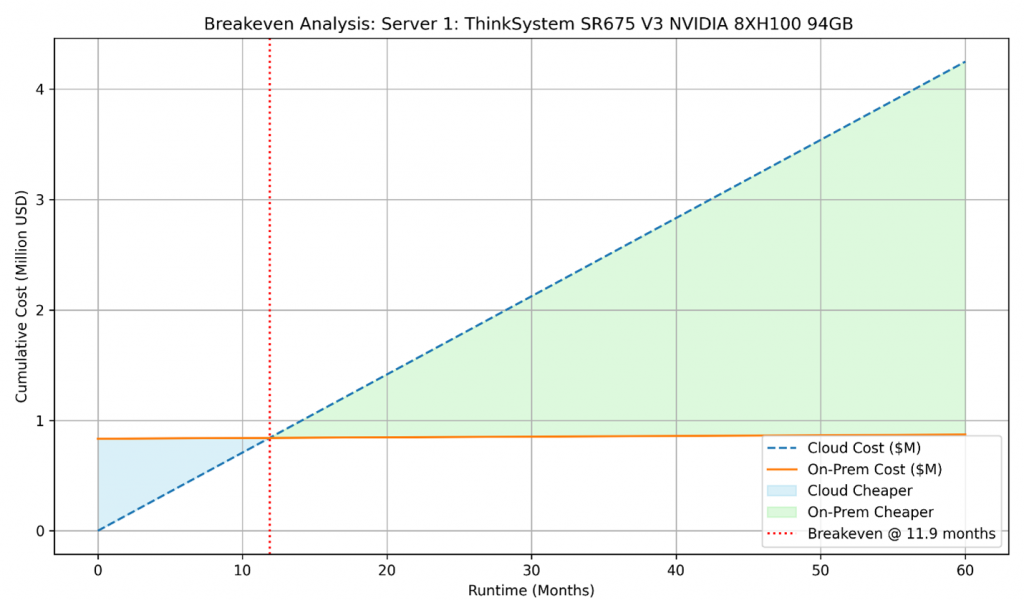
98.32 × x = 0.87 × x + 833806 ⇒ (98.32 − 0.87) × x = 833806 ⇒ x ≈ 8 556 часов.
Это примерно 11,9 месяца непрерывной работы. После ~8 556 часов эксплуатация локальной инфраструктуры становится экономичнее, чем продолжение работы в облаке. Визуализация двух линий (облако vs локально) на графике наглядно показывает точку пересечения и зону экономии.
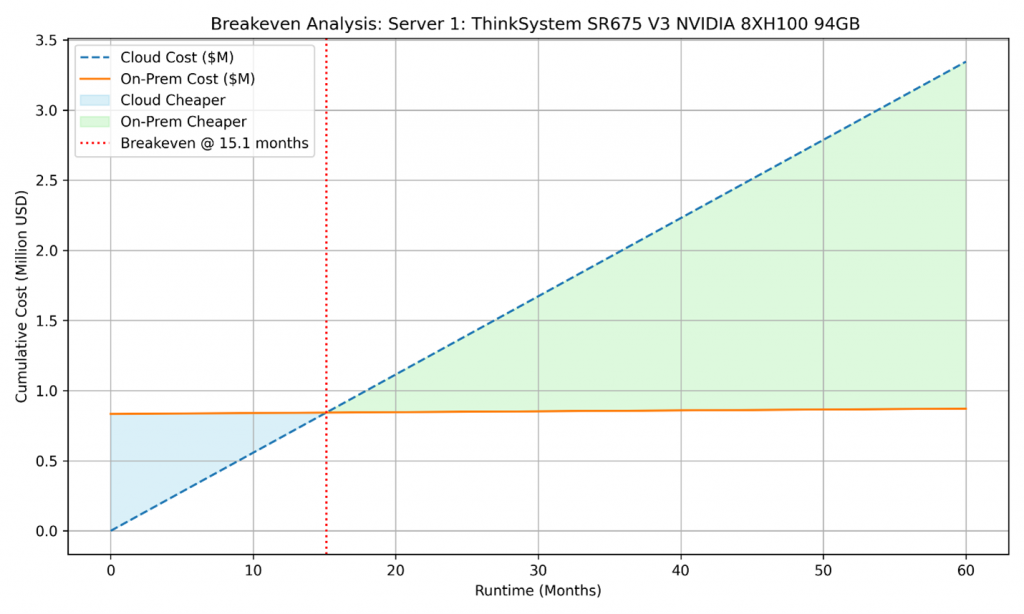
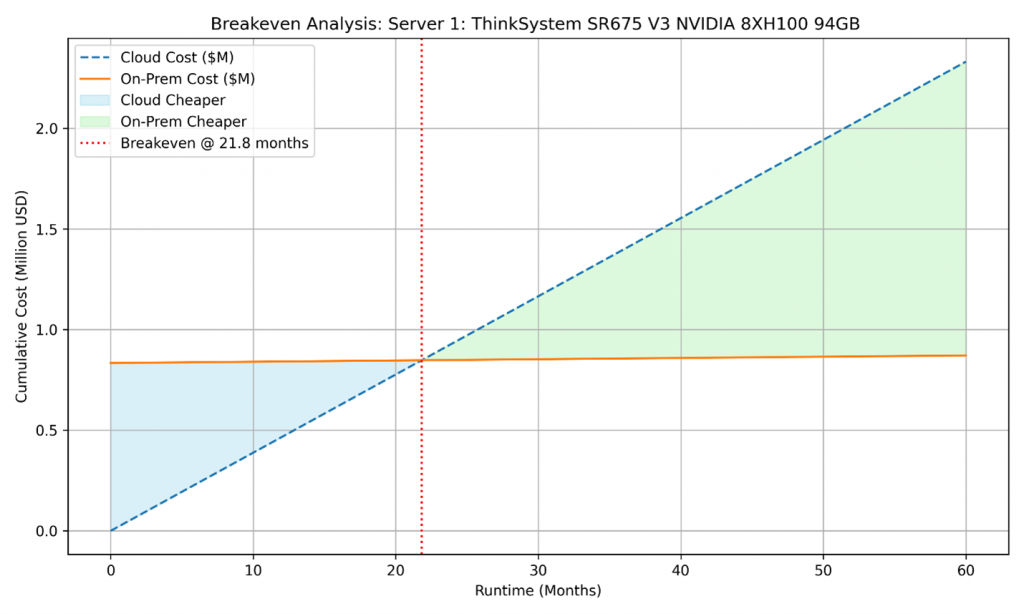
Для того же Сервера 1 рассчитаем точку безубыточности, используя сниженные почасовые ставки по планам экономии AWS (Savings Plans).
Формулы те же:
-
Облако: cloud_cost = rate × x
-
Локально: onprem_cost = 0,87 × x + 833 806
-
Точка безубыточности: rate × x = 0,87 × x + 833 806 ⇒ x = 833 806 / (rate − 0,87)
1-годовой план (77,427 $/час)
x = 833 806 / (77,427 − 0,87) ≈ 10 891 часов ≈ 15,13 месяца
3-летний план (53,945 $/час)
x = 833 806 / (53,945 − 0,87) ≈ 15 710 часов ≈ 21,82 месяца (чуть меньше двух лет)
Вывод: даже при сниженных облачных тарифах точка безубыточности уходит вправо (нужно больше часов, чтобы локальная система «обогнала» облако), однако при длительной стабильной эксплуатации локальная инфраструктура всё равно становится экономичнее на горизонте полутора–двух лет.
Сценарий 2. Совокупная стоимость владения и накопленная экономия
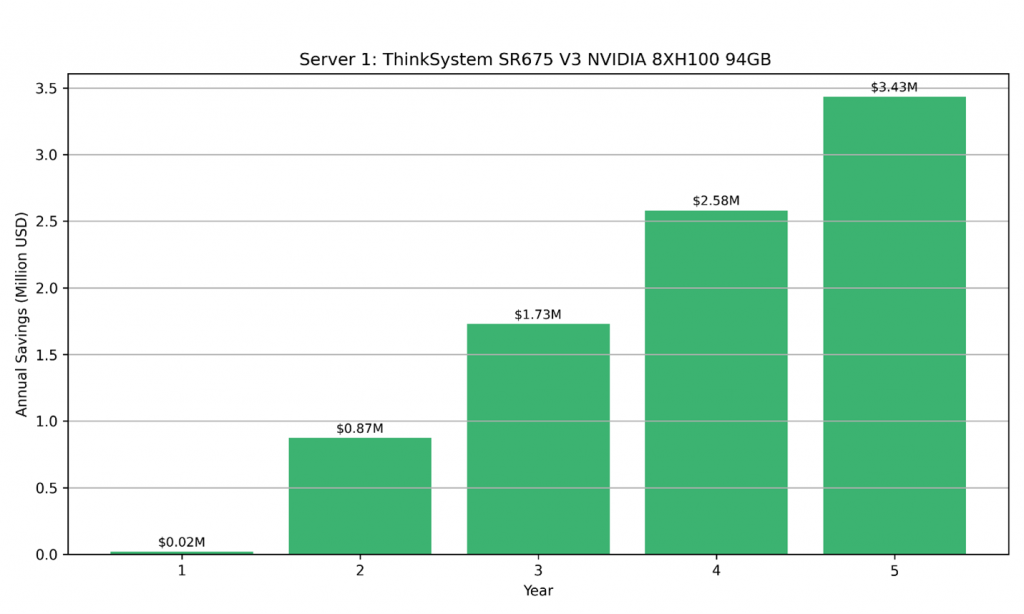
Принимается 5-летний срок эксплуатации локальных серверов. Сравниваются суммарные затраты во времени и оценивается как годовая, так и накопленная экономия при выборе локальной инфраструктуры вместо облака. Пятилетний срок трактуется как полная амортизация без остаточной стоимости: расходы на покупку (например, GPU NVIDIA H100) равномерно распределяются на весь срок службы. Для оценки долгосрочной экономики рассчитывается стоимость непрерывной работы (24×7) в течение пяти лет — и в облаке, и локально. Это показывает накопленную выгоду за типичный жизненный цикл сервера.
Допущения
Формулы
-
Стоимость облака за 5 лет: cloud_hourly × 43 800
-
Стоимость локально за 5 лет: onprem_base_cost + (onprem_hourly × 43 800)
-
Экономия: cloud_5yr − onprem_5yr
Пример (Server 1: ThinkSystem SR675 V3 — 8× NVIDIA H100 NVL 94 ГБ PCIe Gen5; облачный аналог — Amazon EC2 p5.48 x large, 8× NVIDIA H100)
-
Локально: 833 806 + (0,87 × 43 800) = 871 912 $
-
Облако (on-demand 98,32 $/ч): 98,32 × 43 800 = 4 306 416 $
-
Накопленная экономия за 5 лет: 4 306 416 − 871 912 = 3 434 504 $
Итог: за 5 лет непрерывной работы локальная конфигурация формирует значительную денежную разницу в пользу on-prem - ежегодная и суммарная экономия растут по мере увеличения горизонта использования.
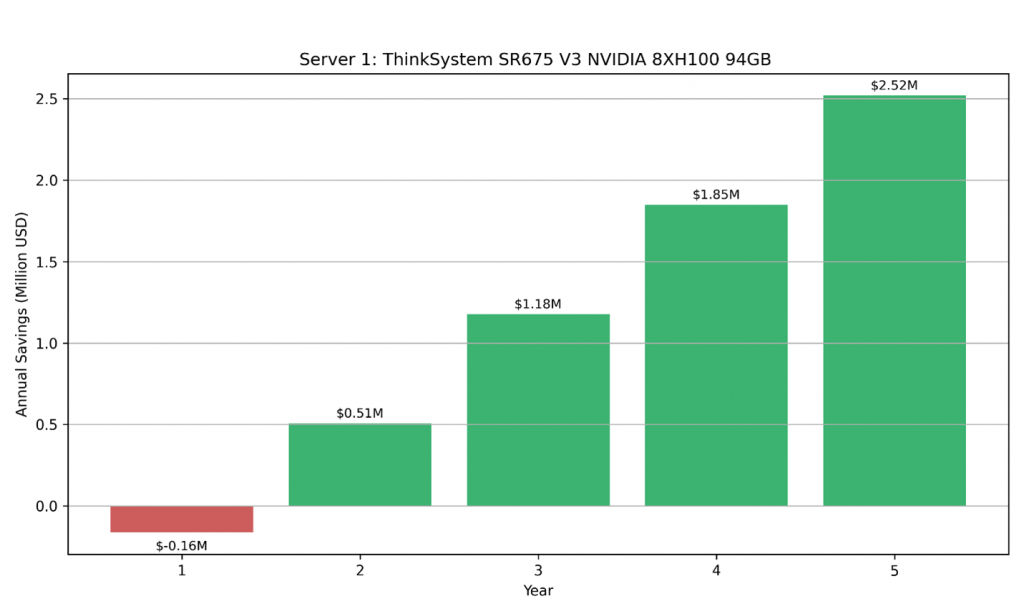
Сценарий 2 с 1-годовым планом экономии AWS
Берем скидочную ставку 77,427 $/ч и тот же горизонт 5 лет (43 800 ч).
-
Облако (Savings Plan 1 год): 77,427 × 43 800 = 3 391 302,6 $
-
Локально: 833 806 + (0,87 × 43 800) = 871 912 $
-
Накопленная экономия за 5 лет: 3 391 302,6 − 871 912 = 2 519 390,6 $
Вывод: даже с учётом 1-годового плана экономии облачный счёт за 5 лет остаётся значительно выше; локальная конфигурация даёт ≈2,52 млн $ экономии при непрерывной работе 24×7.
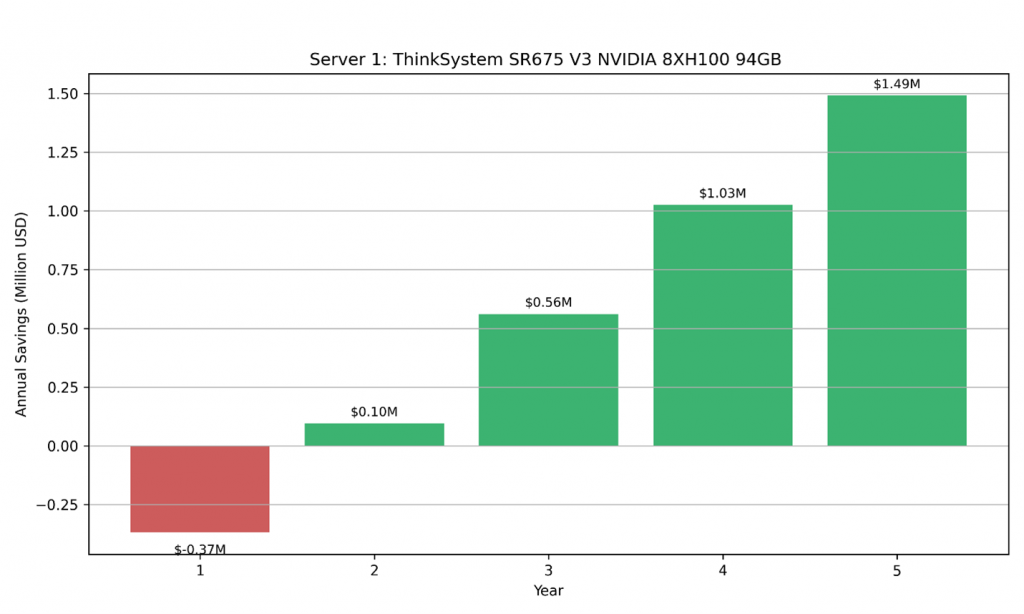
Сценарий 2 с 3-летним планом экономии AWS
Берем ставку 53,94547 $/ч и тот же горизонт 5 лет (43 800 ч).
-
Облако (Savings Plan 3 года): 53,94547 × 43 800 = 2 362 811,59 $
-
Локально: 833 806 + (0,87 × 43 800) = 871 912 $
-
Накопленная экономия за 5 лет: 2 362 811,59 − 871 912 = 1 490 899,59 $
Вывод: даже при более низкой почасовой ставке по 3-летнему плану суммарные затраты облака за 5 лет остаются выше; локальная конфигурация даёт ≈1,49 млн $ экономии при непрерывной работе 24×7.
Сценарий 3. Порог суточной утилизации (часов в день)
Задача — определить минимальное число часов работы в сутки, при котором локальная инфраструктура за 5 лет становится экономичнее облака. Предполагается, что в «активные часы» система и GPU загружены на 100% (типичный высокопоточный инференс). Это дает ясный ориентир для оценки окупаемости капитальных затрат при неполной круглосуточной работе.
Методика
-
Сначала считаем 5-летнюю стоимость круглосуточной работы (24×7) для облака и локально:
— Облако (5 лет): cloud_hourly × 43 800
— Локально (5 лет): onprem_base_cost + onprem_hourly × 43 800
-
Затем считаем коэффициент использования (Usage Ratio):
Usage Ratio = On-Prem 5-Year Cost / Cloud 5-Year Cost
-
Переводим в суточный порог:
Daily Threshold (часов/сутки) = Usage Ratio × 24
Пример (Server 1: SR675 V3, 8× H100; облако — p5.48xlarge)
-
Локально (5 лет): 833 806 + 0,87 × 43 800 = 871 912 $
-
Облако on-demand (5 лет): 98,32 × 43 800 = 4 306 416 $
-
Usage Ratio = 871 912 / 4 306 416 ≈ 0,2025
Порог: 0,2025 × 24 ≈ 4,86 ≈ ~5 часов/сутки
С учётом скидок AWS (Savings Plans)
-
1 год: облако 3 391 302,6 $ → (871 912 / 3 391 302,6) × 24 ≈ 6,17 ч/сутки
-
3 года: облако 2 362 811,59 $ → (871 912 / 2 362 811,59) × 24 ≈ 8,86 ≈ ~9 ч/сутки
Вывод: скидочные тарифы облака снижают почасовую ставку, повышая порог суточной утилизации для окупаемости локального варианта. Иначе говоря, при дисконтированных ценах облака локальную систему нужно загружать больше часов в день, чтобы инвестиции в «железо» были экономически оправданы.
Заключение
Анализ показывает различие стратегий использования облака и локальной инфраструктуры в задачах генеративного ИИ. Облачные платформы дают максимум гибкости и масштабируемости — это удобно для краткосрочных потребностей: экспериментов с моделями, дообучения, нерегулярных нагрузок. Но по мере перехода к устойчивой и предсказуемой эксплуатации совокупные расходы растут за счет регулярной оплаты вычислений, хранения и трафика.
Локальное развертывание требует большего капитального бюджета, но обеспечивает ощутимую экономию на горизонте нескольких лет — после прохождения точки безубыточности ССВ становится ниже, чем в облаке. Для долгоживущих сценариев (серверный инференс, обслуживание больших потоков запросов) этот порог достигается сравнительно быстро.
Серверы Lenovo ThinkSystem (как и сопоставимые решения Dell PowerEdge и HPE ProLiant) усиливают преимущества on-prem за счет производительности, надежности и энергоэффективности: это прочная база для длительных GenAI-инициатив — от крупномасштабного инференса до промышленной эксплуатации моделей.
Оптимальная стратегия зависит от длительности и интенсивности нагрузки, а также финансовых целей. Если планируются непрерывные ИИ-операции на годы, локальная инфраструктура чаще всего оказывается наиболее экономичным и устойчивым решением.






Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!