Автоматическое распознавание речи - Automated Speech Recognition (ASR) - применяется для расшифровки записей, подготовки субтитров, анализа обращений в контакт-центрах и работы голосовых помощников. Современные ASR-системы все чаще строятся на базе крупных моделей-трансформеров, способных точнее обрабатывать разные акценты, тематику и условия записи. Однако для корпоративного применения одной точности недостаточно. Не менее важны задержки, пропускная способность, параллельная обработка запросов и требования к вычислительной инфраструктуре.
Поэтому оценка системы распознавания речи должна включать два последовательных этапа.
Сначала необходимо проверить, не снижает ли оптимизация качество расшифровки. Затем следует определить, какую нагрузку подготовленная конфигурация способна обрабатывать в условиях, приближенных к эксплуатации.
Ниже подробно рассматривается Whisper Large v3 как основа англоязычной ASR-системы. Исходная контрольная точка Hugging Face в формате FP16 сравнивается с вариантами OpenVINO FP16 и INT4 на наборах LibriSpeech и TED-LIUM. Для оценки качества используется показатель доли ошибочно распознанных слов - WER. Его задача состоит прежде всего в том, чтобы подтвердить отсутствие существенного ухудшения точности при переходе от FP16 к INT4.
После проверки качества анализ расширяется до оценки серверной производительности.
Тесты на LibriSpeech с использованием vLLM на двух моделях процессоров Intel Xeon в конфигурациях BF16 и W8A8 измеряют пропускную способность, задержки, число одновременно обрабатываемых запросов и поведение системы при росте нагрузки.
Такой подход позволяет разделить три аспекта развертывания:
-
WER показывает качество распознавания;
-
результаты OpenVINO отражают эффективность оптимизированной среды выполнения;
-
испытания vLLM характеризуют реальную производительность сервиса, включая параллельную обработку и задержки наиболее медленных запросов.
Дополнительное сравнение процессоров Intel Xeon 5-го и 6-го поколений позволяет оценить применимость современных серверных платформ для высоконагруженных ASR-систем без графических ускорителей. Векторные инструкции AVX-512 и матричные ускорители Intel AMX повышают эффективность обработки моделей на базе трансформеров и делают процессорный вывод рабочим вариантом для масштабируемых корпоративных сервисов расшифровки.
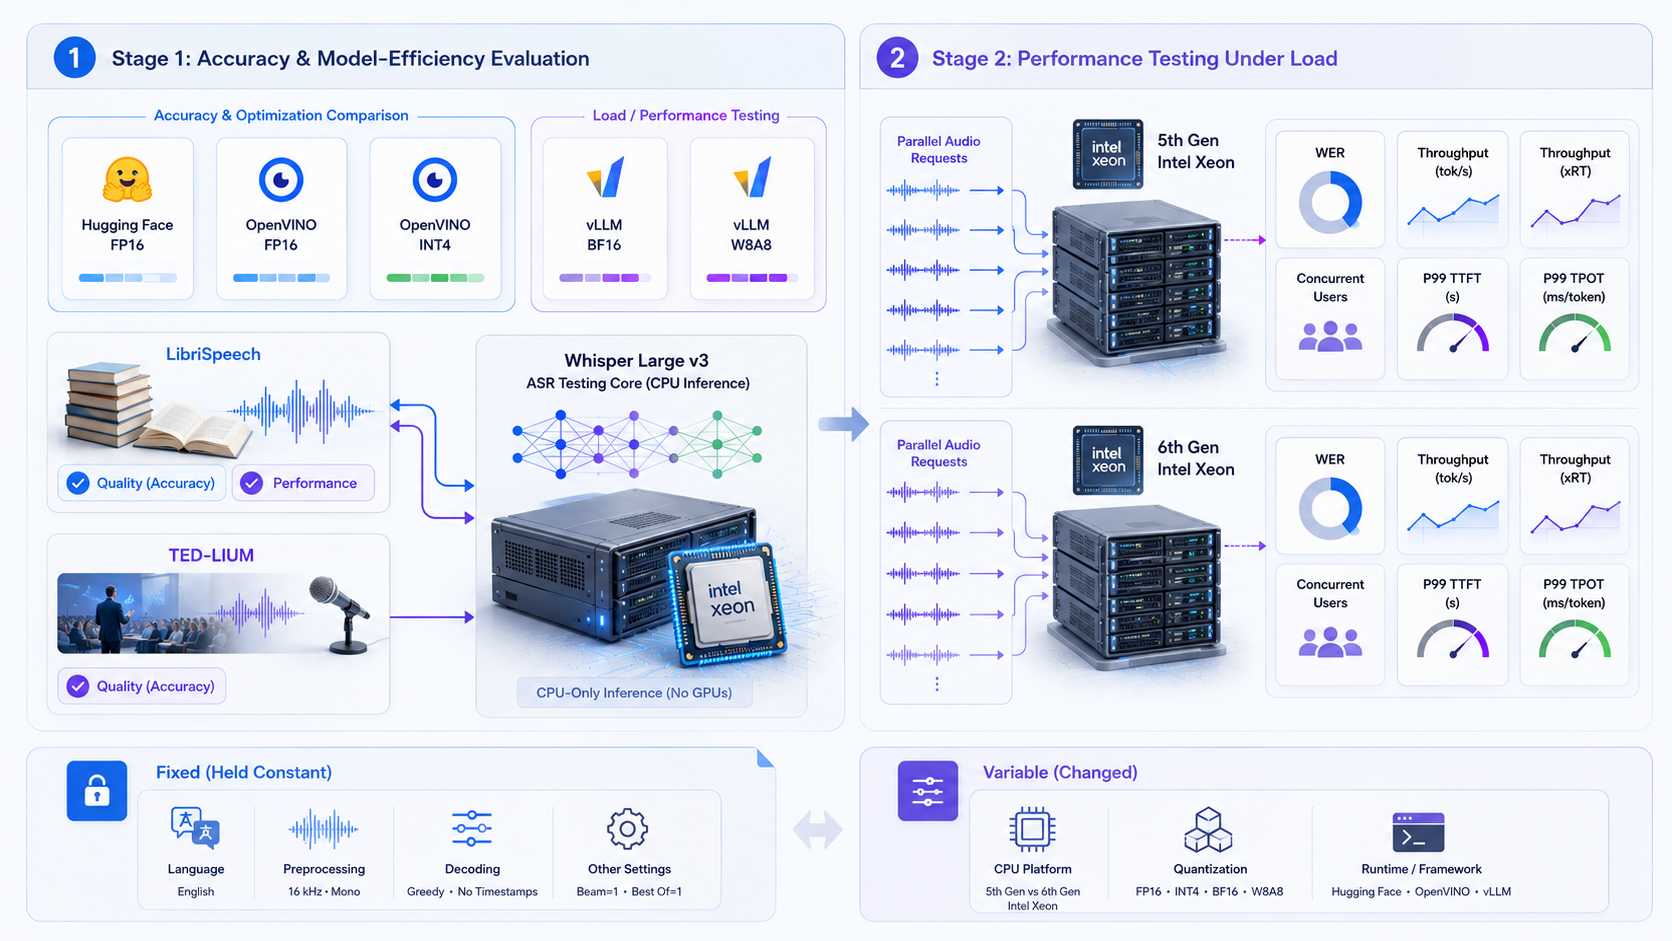
Как оценивались точность и производительность
Чтобы сравнение отражало не только качество распознавания, но и реальную производительность системы, в план тестирования включены несколько вариантов модели, разные тестовые нагрузки и единый набор показателей. Такой подход позволяет отдельно оценить точность расшифровки и понять, как процессорный сервис ведет себя под нагрузкой.
Модель, формат вычислений и среда выполнения
В тестах сравниваются пять вариантов развертывания на базе одной модели Whisper Large v3, представленных в таблице ниже.
Первые три конфигурации используются для оценки точности распознавания и эффективности выполнения модели в форматах FP16 и INT4. Варианты vLLM BF16 и vLLM W8A8 добавлены для измерения производительности процессорного сервиса при нагрузке, приближенной к промышленной эксплуатации.
|
Модель
|
Среда выполнения / формат вычислений
|
Роль в тестировании
|
|
openai/whisper-large-v3
|
Hugging Face FP16
|
Исходная реализация оригинальной контрольной точки, используемая как базовый вариант для сравнения.
|
|
OpenVINO/whisper-large-v3-fp16-ov
|
OpenVINO FP16
|
Оптимизированный вариант среды выполнения, сохраняющий точность распознавания.
|
|
OpenVINO/whisper-large-v3-int4-ov
|
OpenVINO INT4
|
Вариант с высокой степенью сжатия, предназначенный для сервисов, где приоритетом является эффективность обработки.
|
|
openai/whisper-large-v3
|
vLLM BF16
|
Конфигурация для оценки производительности процессорного сервиса при выполнении модели в формате BF16.
|
|
openai/whisper-large-v3
|
vLLM W8A8
|
Конфигурация для оценки производительности процессорного сервиса с квантованием весов и активаций до INT8.
|
Поскольку все конфигурации основаны на одной модели Whisper Large v3, исследование сосредоточено не на сравнении архитектур ASR, а на разных вариантах развертывания и обслуживания запросов.
Сначала показатель WER используется для проверки того, что переход к пониженной точности вычислений не приводит к заметному ухудшению качества распознавания. После этого конфигурации vLLM BF16 и W8A8 позволяют оценить полную производительность процессорного сервиса на выбранных серверах Intel Xeon под нагрузкой.
Какие данные использовались в тестах
Для тестов выбраны два англоязычных набора данных ASR. Один используется для оценки точности распознавания чистой речи, второй - для измерения производительности сервиса при одинаковых условиях процессорного вывода.
|
Набор данных
|
Источник данных
|
Тип речи
|
Акустическая сложность
|
Назначение в тестах
|
|
LibriSpeech
|
Аудиокниги
|
Чтение вслух
|
Низкая
|
Оценка WER и измерение производительности сервиса vLLM
|
|
TED-LIUM Release 3
|
Выступления TED
|
Подготовленная речь
|
Средняя
|
Только оценка WER
|
LibriSpeech используется как контрольный набор чистой речи для оценки точности распознавания и производительности сервиса под нагрузкой. TED-LIUM добавляет более естественную вариативность речи и позволяет проверить, сохраняется ли точность за пределами записей аудиокниг.
Испытания vLLM проводятся только на LibriSpeech. Это связано с тем, что тест MLPerf Inference Whisper от MLCommons также использует Whisper Large v3 и модифицированный набор аудиозаписей LibriSpeech. Такой выбор сохраняет общую направленность с методикой MLCommons/MLPerf, одновременно отделяя оценку серверной производительности от более широкого сравнения WER на LibriSpeech и TED-LIUM.
Показатели оценки
Для оценки качества расшифровки используются метрики точности, а для анализа работы системы под нагрузкой - показатели производительности сервиса:
-
WER - Word Error Rate, доля ошибочно распознанных слов. Рассчитывается с учетом замен, пропусков и вставок относительно общего числа слов в эталонной расшифровке. Чем ниже WER, тем выше точность распознавания.
-
Пропускная способность, токенов/с - Throughput tok/s. Показывает, сколько выходных токенов vLLM формирует за секунду по всем активным запросам. Более высокое значение означает большую производительность сервиса.
-
Пропускная способность в реальном времени - Throughput xRT. Показывает, во сколько раз быстрее длительности исходной записи система обрабатывает звук. Например, 10xRT означает, что за одну секунду реального времени обрабатывается десять секунд аудио.
-
Максимальное число одновременных пользователей. Наибольшее количество параллельных пользователей или запросов, которое система способна обрабатывать с соблюдением заданных требований к задержке и качеству обслуживания.
-
P99 TTFT - время до первого токена в 99-м процентиле. Характеризует задержку получения первого результата для наиболее медленных запросов при высокой нагрузке.
-
P99 TPOT - время формирования одного выходного токена в 99-м процентиле. Показывает задержку последовательного декодирования после получения первого токена в наиболее неблагоприятных условиях нагрузки.
Что фиксировалось, а что менялось в тестах
Чтобы результаты WER отражали различия между вариантами развертывания, а не влияние аппаратной платформы или настроек, все три конфигурации - Hugging Face FP16, OpenVINO FP16 и OpenVINO INT4 - должны тестироваться на одном сервере и одной модели процессора. Также фиксируются параметры декодирования, язык, предварительная обработка аудио, правила работы с временными метками и нормализация расшифровок.
Испытания производительности vLLM проводятся отдельно на двух моделях Intel Xeon. Здесь процессорная платформа меняется намеренно, поскольку задача состоит в оценке масштабирования BF16- и W8A8-конфигураций. Сравнение включает пропускную способность в токенах/с и xRT, число одновременных запросов, а также задержки P99 TTFT и P99 TPOT.
Конфигурации серверов для тестирования
|
Компоненты
|
Нода A - Сервер на Intel Xeon 6-го поколения
|
Нода B - Сервер на Intel Xeon 5-го поколения
|
|
Процессоры
|
2 × Intel Xeon 6980P
|
2 × Intel Xeon Platinum 8568Y+
|
|
Топология процессоров
|
128 ядер на сокет, 2 потока на ядро, всего 512 потоков
|
48 ядер на сокет, 2 потока на ядро, всего 192 потока
|
|
Частота процессоров
|
До 3,9 ГГц
|
До 4,0 ГГц
|
|
Оперативная память
|
1,0 Тбайт DDR-6400
|
2,0 Тбайт DDR-5600
|
Программное обеспечение
|
Программное обеспечение
|
Версия
|
|
Системное программное окружение
|
|
Операционная система
|
Ubuntu 24.04.3 LTS (Noble Numbat)
|
|
Ядро Linux
|
6.8.0-94-generic
|
|
Python
|
3.12
|
|
Основные пакеты Python
|
|
torch
|
2.9.1+cu130
|
|
transformers
|
4.57.6
|
|
sentence-transformers
|
5.2.2
|
|
openvino
|
2026.1.0
|
|
optimum-intel
|
1.27.0
|
|
pandas
|
2.3.3
|
|
huggingface_hub
|
0.36.2
|
|
vLLM
|
0.21.1 + cpu
|
Что показали тесты
Полученные результаты позволяют сравнить варианты развертывания по трем ключевым направлениям - точности распознавания, эффективности выполнения модели и производительности процессорного сервиса под выбранными ASR-нагрузками.
Точность и эффективность выполнения
Результаты, полученные на платформе с процессором Intel Xeon 8568Y+ 5-го поколения, показывают позволяет ли оптимизации OpenVINO FP16 и INT4 повысить эффективность выполнения модели, сохранив точность распознавания на уровне, близком к исходной конфигурации Hugging Face FP16.
|
Вариант модели
|
Среда выполнения / формат вычислений
|
WER LibriSpeech
|
WER TED-LIUM
|
Пропускная способность, с аудио/с
|
TTFT, мс
|
TPOT, мс/токен
|
|
openai/whisper-large-v3
|
HF FP16
|
2,00%
|
3,88%
|
4,02
|
925,2
|
33,27
|
|
OpenVINO/whisper-large-v3-fp16-ov
|
OpenVINO FP16
|
1,98%
|
3,89%
|
10,42
|
139,8
|
20,23
|
|
OpenVINO/whisper-large-v3-int4-ov
|
OpenVINO INT4
|
2,01%
|
3,93%
|
11,55
|
150,9
|
17,37
|
Разница в пропускной способности и задержках заметна сразу. Базовая конфигурация Hugging Face FP16 обрабатывает 4,02 секунды аудио за одну секунду реального времени, OpenVINO FP16 - 10,42 секунды, а OpenVINO INT4 - 11,55 секунды.
Задержка TTFT сокращается с 925,2 до примерно 140 мс. Показатель TPOT снижается с 33,27 мс на токен до 20,23 мс для OpenVINO FP16 и до 17,37 мс для OpenVINO INT4.
Изменение относительно базовой конфигурации Hugging Face FP16
Сравнение выполнено на той же платформе с процессором Intel Xeon 5-го поколения, которая использовалась для оценки точности и эффективности выполнения. Все значения приведены относительно Hugging Face FP16 и показывают, как меняются точность распознавания, пропускная способность и задержки при использовании оптимизированных вариантов развертывания.
|
Вариант модели
|
Δ среднего WER
|
Δ пропускной способности
|
Δ TTFT
|
Δ TPOT
|
|
OpenVINO/whisper-large-v3-fp16-ov
|
~0%
|
+159,20%
|
-84,89%
|
-39,19%
|
|
OpenVINO/whisper-large-v3-int4-ov
|
+1,02%
|
+187,31%
|
-83,69%
|
-47,79%
|
OpenVINO FP16 выглядит наиболее сбалансированным вариантом развертывания: точность остается практически на уровне Hugging Face FP16, при этом скорость выполнения существенно возрастает.
OpenVINO INT4 показывает максимальную эффективность среди протестированных конфигураций - самую высокую пропускную способность и минимальный TPOT. При этом средний WER на LibriSpeech и TED-LIUM остается сопоставимым с базовым вариантом.
Производительность Whisper Large v3 в vLLM под нагрузкой
Тестирование vLLM расширяют оценку от автономного измерения точности и эффективности выполнения до анализа работы процессорного сервиса в условиях, приближенных к эксплуатации. В сравнении рассматриваются конфигурации BF16 и W8A8 на платформах Intel Xeon 5-го и 6-го поколений.
Измеряются пропускная способность, число одновременно обрабатываемых запросов и задержки наиболее медленных обращений в автономном, пакетном режимах и при обработке одиночных запросов.
|
Режим
|
Процессор
|
Формат вычислений
|
Одновременные пользователи
|
Пропускная способность, xRT
|
Пропускная способность, токенов/с
|
P99 TTFT, мс
|
P99 TPOT, мс/токен
|
|
Автономный
|
6980P_128C
|
BF16
|
-
|
556,84
|
1 737,79
|
-
|
-
|
|
Автономный
|
8568_48C
|
BF16
|
-
|
231,29
|
722,19
|
-
|
-
|
|
Автономный
|
8568_48C
|
W8A8
|
-
|
266,30
|
836,30
|
-
|
-
|
|
Пакетный
|
6980P_128C
|
BF16
|
72
|
-
|
-
|
2 147,54
|
94,65
|
|
Пакетный
|
8568_48C
|
BF16
|
48
|
-
|
-
|
2 791,86
|
77,06
|
|
Пакетный
|
8568_48C
|
W8A8
|
96
|
-
|
-
|
2 498,33
|
100,9
|
|
Одиночный запрос
|
6980P_128C
|
BF16
|
-
|
-
|
-
|
278,98
|
19,42
|
|
Одиночный запрос
|
8568_48C
|
BF16
|
-
|
-
|
-
|
1 181,28
|
60,05
|
|
Одиночный запрос
|
8568_48C
|
W8A8
|
-
|
-
|
-
|
832,28
|
34,84
|
Тест vLLM показывает, как Whisper Large v3 работает в автономном, пакетном режиме и при одиночных запросах. В автономном режиме конфигурация 6980P_128C BF16 достигла 556,84 xRT и 1 737,79 токена/с. На 8568_48C результаты составили 231,29 xRT и 722,19 токена/с для BF16, а также 266,30 xRT и 836,30 токена/с для W8A8.
В пакетном режиме 6980P_128C BF16 поддерживал 72 одновременных пользователя при P99 TTFT 2 147,54 мс и P99 TPOT 94,65 мс. При обработке одиночного запроса эта же конфигурация показала минимальные среди представленных результатов задержки - 278,98 мс по P99 TTFT и 19,42 мс на токен по P99 TPOT.
Что результаты означают для корпоративного внедрения
Результаты показывают, что Whisper Large v3 можно оптимизировать для процессорного ASR-сервиса без заметного ухудшения качества распознавания. Значения WER для OpenVINO FP16 и INT4 остаются близкими к базовой конфигурации Hugging Face FP16. Это позволяет рассматривать форматы с пониженной точностью вычислений, но только после проверки качества на целевых аудиоданных.
В рамках проведенного тестирования Intel Xeon 8568Y+ 5-го поколения с 48 ядрами и Xeon 6980P 6-го поколения со 128 ядрами справились с основными сценариями обработки речи исключительно средствами центральных процессоров. Для протестированных конфигураций и нагрузок применение графических ускорителей не потребовалось.
Нода A: Intel Xeon 6980P 6-го поколения, 128 ядер
Нода A представляет высокопроизводительную платформу Intel Xeon 6-го поколения, которая тестировалась для оценки предельной производительности Whisper Large v3 при выполнении только на центральных процессорах. Конфигурация со 128 ядрами ориентирована на крупномасштабную автономную расшифровку и плотные ASR-нагрузки в реальном времени, где основными требованиями становятся пропускная способность одного узла и параллельная обработка запросов.
Автономная обработка аудио: ожидаемая производительность
В сценариях автономной расшифровки нода A рассматривалась как платформа пакетной обработки. Основная задача такой конфигурации - обработать максимальный объем записанного аудио за единицу вычислительного времени.
|
Показатель
|
Значение и комментарий
|
|
Оптимальная конфигурация
|
Whisper Large v3, BF16, автономный режим
|
|
Коэффициент реального времени
|
556,84 xRT, или 1 737,79 токена/с - около 556 секунд аудио расшифровываются за одну секунду вычислительного времени
|
|
За минуту
|
Около 9,3 часа аудио обрабатывается за одну минуту вычислений
|
|
За час
|
Около 557 часов аудио обрабатывается за один час вычислений
|
|
За сутки работы узла
|
Около 13 000 часов аудио обрабатывается одним узлом за сутки
|
|
Пример
|
Архив объемом 100 000 часов, например многолетние записи разговоров, обрабатывается одним узлом примерно за 8 дней
|
Субтитры в реальном времени: максимальная параллельная нагрузка
В сценариях формирования субтитров в реальном времени нода A оценивается по числу одновременных аудиопотоков, которые она способна обрабатывать, сохраняя время до первого результата и задержку последующего декодирования в практически приемлемых пределах.
|
Показатель
|
Значение и комментарий
|
|
Тестовая конфигурация
|
Whisper Large v3, BF16, пакетный режим
|
|
Поддерживаемая параллельная нагрузка
|
72 одновременных аудиопотока при P99 TTFT около 2 147 мс и P99 TPOT около 94,65 мс
|
Где наиболее эффективен сервер на Intel Xeon 6-го поколения
В корпоративных ASR-системах нода A наиболее оправдана в двух сценариях - при необходимости быстро обработать большой накопленный архив записей и при максимальной плотности аудиопотоков на одном процессорном сервере.
-
Быстрая обработка архивов. Высокая пропускная способность позволяет заметно сократить сроки расшифровки больших массивов аудио и отказаться от поминутной оплаты внешних сервисов. Для протестированной конфигурации графические ускорители не требуются.
-
Меньше серверов и проще инфраструктура. Высокая производительность одного узла сокращает необходимое количество систем, сетевых подключений и объем работ по управлению распределенной средой.
-
Рекомендуемая роль. Основной узел для автономной расшифровки больших архивов, а также платформа для обработки речи в реальном времени, когда приоритетом является максимальное число потоков на сервер.
Нода B: Intel Xeon 8568Y+ 5-го поколения, 48 ядер
Нода B представляет платформу Intel Xeon 5-го поколения для эффективной работы Whisper Large v3 на центральных процессорах. Конфигурация сочетает высокую пропускную способность, параллельную обработку запросов и более сбалансированные требования к стоимости развертывания.
Автономная обработка аудио: ожидаемая производительность
В сценариях автономной расшифровки нода B оценивается по скорости пакетной обработки заранее записанного аудио.
|
Показатель
|
Значение и комментарий
|
|
Оптимальная конфигурация
|
Whisper Large v3, W8A8, автономный режим; показатели BF16 приведены в скобках
|
|
Коэффициент реального времени
|
266,30 xRT, или 836,30 токена/с, для W8A8; 231,29 xRT для BF16 - квантование повышает производительность примерно на 15%
|
|
За минуту
|
Около 4,4 часа аудио обрабатывается за одну минуту вычислений в конфигурации W8A8
|
|
За час
|
Около 267 часов аудио обрабатывается за один час вычислений в конфигурации W8A8
|
|
За сутки работы узла
|
Около 6 400 часов аудио обрабатывается одним узлом за сутки
|
|
Пример
|
Архив объемом 100 000 часов обрабатывается одним узлом примерно за 16 дней в конфигурации W8A8
|
Субтитры в реальном времени: максимальная параллельная нагрузка
В этом сценарии нода B оценивается по числу одновременных аудиопотоков, которые она способна обрабатывать при сохранении практически приемлемого уровня задержки.
|
Показатель
|
Значение и практический смысл
|
|
Оптимальная конфигурация
|
Whisper Large v3, W8A8, пакетный режим
|
|
Поддерживаемая параллельная нагрузка
|
96 одновременных аудиопотоков при P99 TTFT около 2 498 мс и P99 TPOT около 100,9 мс
|
|
Базовая конфигурация BF16
|
48 одновременных аудиопотоков при TPOT около 77,06 мс - квантование вдвое увеличивает плотность потоков на той же аппаратной платформе
|
|
Рекомендации по планированию
|
Для W8A8 можно ориентироваться примерно на 96 потоков на один узел и наращивать производительность горизонтально, добавляя новые узлы по мере роста нагрузки
|
Масштабирование ASR на Intel Xeon 5-го поколения
Нода B представляет практичный вариант для горизонтального масштабирования систем распознавания речи в реальном времени. Наибольший эффект достигается при использовании W8A8, которое увеличивает число одновременно обрабатываемых потоков на той же аппаратной платформе.
-
Выше плотность потоков. В тестовой конфигурации переход от BF16 к W8A8 увеличил параллельную нагрузку с 48 до 96 аудиопотоков на узел.
-
Меньше серверов при той же нагрузке. При сохранении аналогичных требований к задержкам удвоение плотности потоков позволяет примерно вдвое сократить число узлов для заданного количества пользователей.
-
Удобная единица масштабирования. Количество серверов можно рассчитывать по пиковой параллельной нагрузке и постепенно увеличивать по мере роста числа запросов.
Intel Xeon 5-го и 6-го поколений: разница в скорости обработки аудио
Сравнение двух нод показывает, как выбор процессорной платформы влияет на сроки обработки крупных аудиоархивов и требуемое количество серверов. Для бизнеса это означает возможность заранее оценить, насколько оправдан переход к более производительной конфигурации при больших объемах расшифровки и жестких сроках выполнения.
|
Показатель
|
Нода A: Xeon 6980P, BF16
|
Нода B: Xeon 8568Y+, W8A8
|
Разница
|
|
Коэффициент реального времени
|
556,84 xRT
|
266,30 xRT
|
Нода A выше на 109,1%
|
|
Пропускная способность
|
1 737,79 токена/с
|
836,30 токена/с
|
Нода A выше на 107,8%
|
|
Обработка за минуту вычислений
|
Около 9,3 часа аудио
|
Около 4,4 часа аудио
|
Нода A выше на 111,4%
|
|
Обработка за час вычислений
|
Около 557 часов аудио
|
Около 267 часов аудио
|
Нода A выше на 108,6%
|
|
Обработка за сутки
|
Около 13 000 часов аудио
|
Около 6 400 часов аудио
|
Нода A выше на 103,1%
|
|
Обработка архива 100 000 часов
|
Около 8 дней
|
Около 16 дней
|
Ноде A требуется на 50% меньше времени
|
В протестированных конфигурациях сервер с двумя Xeon 6980P в режиме BF16 показала примерно в 2,1 раза более высокую автономную пропускную способность, чем сервер с двумя Xeon Platinum 8568Y+ в режиме W8A8.
Таким образом нода на Intel Xeon 6980P 6-го поколения обрабатывает аудио примерно вдвое быстрее и сокращает время расшифровки архива объемом 100 000 часов с 16 до 8 дней. Нода на Intel Xeon 8568Y+ 5-го поколения остается более умеренной по масштабу конфигурацией для задач, где максимальная производительность одного сервера не является главным требованием.
Заключение
Результаты тестов показывают, что Whisper Large v3 можно разворачивать на современных серверах для ИИ-инференса и при этом сохранять практическое качество распознавания речи. По сравнению с исходной конфигурацией Hugging Face FP16 вариант OpenVINO FP16 увеличил пропускную способность на 159% и сократил время до получения первого результата на 85%. OpenVINO INT4 обеспечил прирост пропускной способности на 187% и уменьшил время формирования последующих токенов на 48%.
Для бизнеса это означает, что ускорение расшифровки достигается не только за счет наращивания аппаратных ресурсов. Оптимизация среды выполнения и формата вычислений позволяет быстрее обрабатывать накопленные архивы звонков, увеличивать число одновременных аудиопотоков и сокращать задержки в сервисах субтитров, помощниках для встреч и системах голосового перевода.
OpenVINO FP16 остается наиболее консервативным вариантом для проектов, где приоритетом является сохранение точности на уровне базовой модели. INT4 и W8A8 лучше подходят для сценариев, в которых важны максимальная пропускная способность и плотность параллельных запросов. Платформы Intel Xeon с большим числом ядер, в свою очередь, наиболее уместны для массовой автономной расшифровки и высоконагруженных сервисов реального времени.
В рамках проведенных испытаний Whisper Large v3 уверенно работала без графических ускорителей. Это делает процессорную инфраструктуру практичным вариантом для компаний, которым важно заранее рассчитывать производительность, масштабировать систему по числу пользователей и снизить зависимость от специализированных ускорителей.






Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!