Корпоративная инфраструктура искусственного интеллекта смещает приоритет с обучения моделей на их промышленную эксплуатацию, что меняет экономику проектов. Обучение обычно представляет собой капиталоёмкий этап с определенным сроком завершения. Обработка запросов становится постоянной производственной нагрузкой, которая сохраняется всё время работы сервиса, а её результат измеряется количеством сгенерированных токенов. Поэтому ключевым показателем становится экономика генерации: после установки графических ускорителей и определения лимита энергопотребления бизнес-результат зависит от того, сколько токенов способна выдать приобретённая инфраструктура.
В продолжительных диалогах с множеством запросов накопленный контекст многократно проходит через модель. Графический ускоритель уже затратил ресурсы на его обработку, однако после вытеснения KV-кэша системе приходится повторно вычислять тот же контекст. Именно повторные вычисления становятся основным источником потерь. При масштабной эксплуатации ими нельзя пренебречь: затраты возвращаются в виде дополнительного энергопотребления, занятости графических ускорителей, увеличения очередей и необходимости закупать новое оборудование.
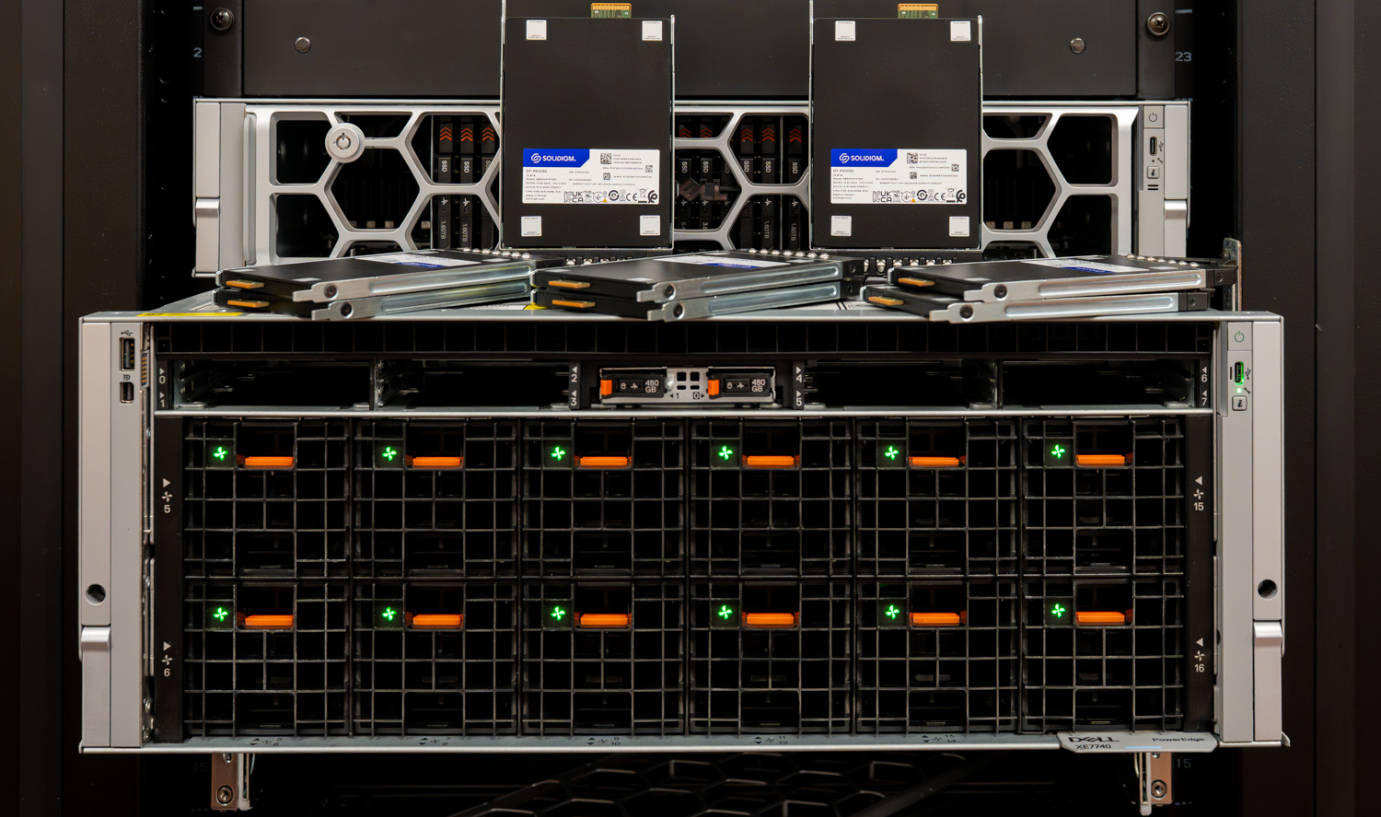
Первым очевидным решением становится расширение самых дорогих ресурсов сервера — установка дополнительных графических ускорителей и модулей оперативной памяти. Однако повторные вычисления заново создают данные, которые уже можно использовать повторно. KV-кэш представляет собой массив данных, поэтому его можно сохранять на более доступном уровне хранения и затем загружать обратно. Небольшие затраты на чтение в этом случае заменяют значительно более ресурсоёмкую повторную обработку контекста.
Поэтому основной вопрос заключается в выборе уровня хранения с учётом производительности и стоимости. Видеопамять остаётся самым быстрым, но одновременно наиболее дефицитным ресурсом. После её заполнения сервер начинает вытеснять сохранённые кэши. Оперативная память увеличивает доступный запас ёмкости, однако обходится дорого. Флеш-накопители способны изменить экономику системы: они медленнее оперативной памяти, но значительно дешевле в расчёте на терабайт и располагают достаточной ёмкостью для хранения контекста, который приходится удалять с более быстрых уровней. В результате вместо повторной обработки всей истории диалога данные можно просто считать с накопителя.
Для оценки эффекта был подготовлен многотуровый сценарий работы ИИ-агента на сервере Dell PowerEdge XE7740. Модель, графические ускорители и программная среда обработки запросов оставались неизменными. Основной интерес представляло поведение системы после заполнения доступных уровней памяти.
После достижения этого предела флеш-накопители поддерживали совокупную скорость около 30 тыс. токенов/с, тогда как оперативная память обеспечивала около 17 тыс. токенов/с. Производительность флеш-уровня сохранялась на уровне 94% от собственного максимума, а показатель оперативной памяти снижался до 42%.
На пике оба варианта выгрузки заметно превосходили конфигурацию, использующую только видеопамять: в 2,9 раза при выгрузке в оперативную память и в 2,2 раза при использовании флеш-накопителей. Однако достижение пикового результата на оперативной памяти одновременно означало приближение к пределу её ёмкости. Дорогая память позволяла получить максимальную производительность, а флеш-накопители помогали удерживать её по мере дальнейшего роста контекста.
Перед рассмотрением результатов необходимо уточнить, что представляет собой KV-кэш, почему он заполняет память и по какой причине производительность обработки запросов резко снижается, если системе негде хранить его на более доступном уровне.
Как работает обработка запросов
Большие языковые модели работают авторегрессионно: каждый новый токен формируется с учётом всех предшествующих токенов. Этот принцип реализуется механизмом внимания. Для каждого токена рассчитывается вектор запроса Q, который сопоставляется с векторами ключей K и значений V всех предыдущих токенов. Результат внимания представляет собой взвешенную комбинацию значений, где веса определяются скалярными произведениями векторов Q и K.
После поступления запроса модель не может начать формировать ответ, пока для каждого токена исходного текста не будут рассчитаны тензоры K и V. Этот этап называется предварительной обработкой запроса, или prefill. Механизм обработки пропускает весь исходный текст через модель за один параллельный проход и записывает полученные тензоры K и V в память. Поэтому этап предварительной обработки ограничен вычислительной производительностью, а его задержка увеличивается по мере роста длины запроса.
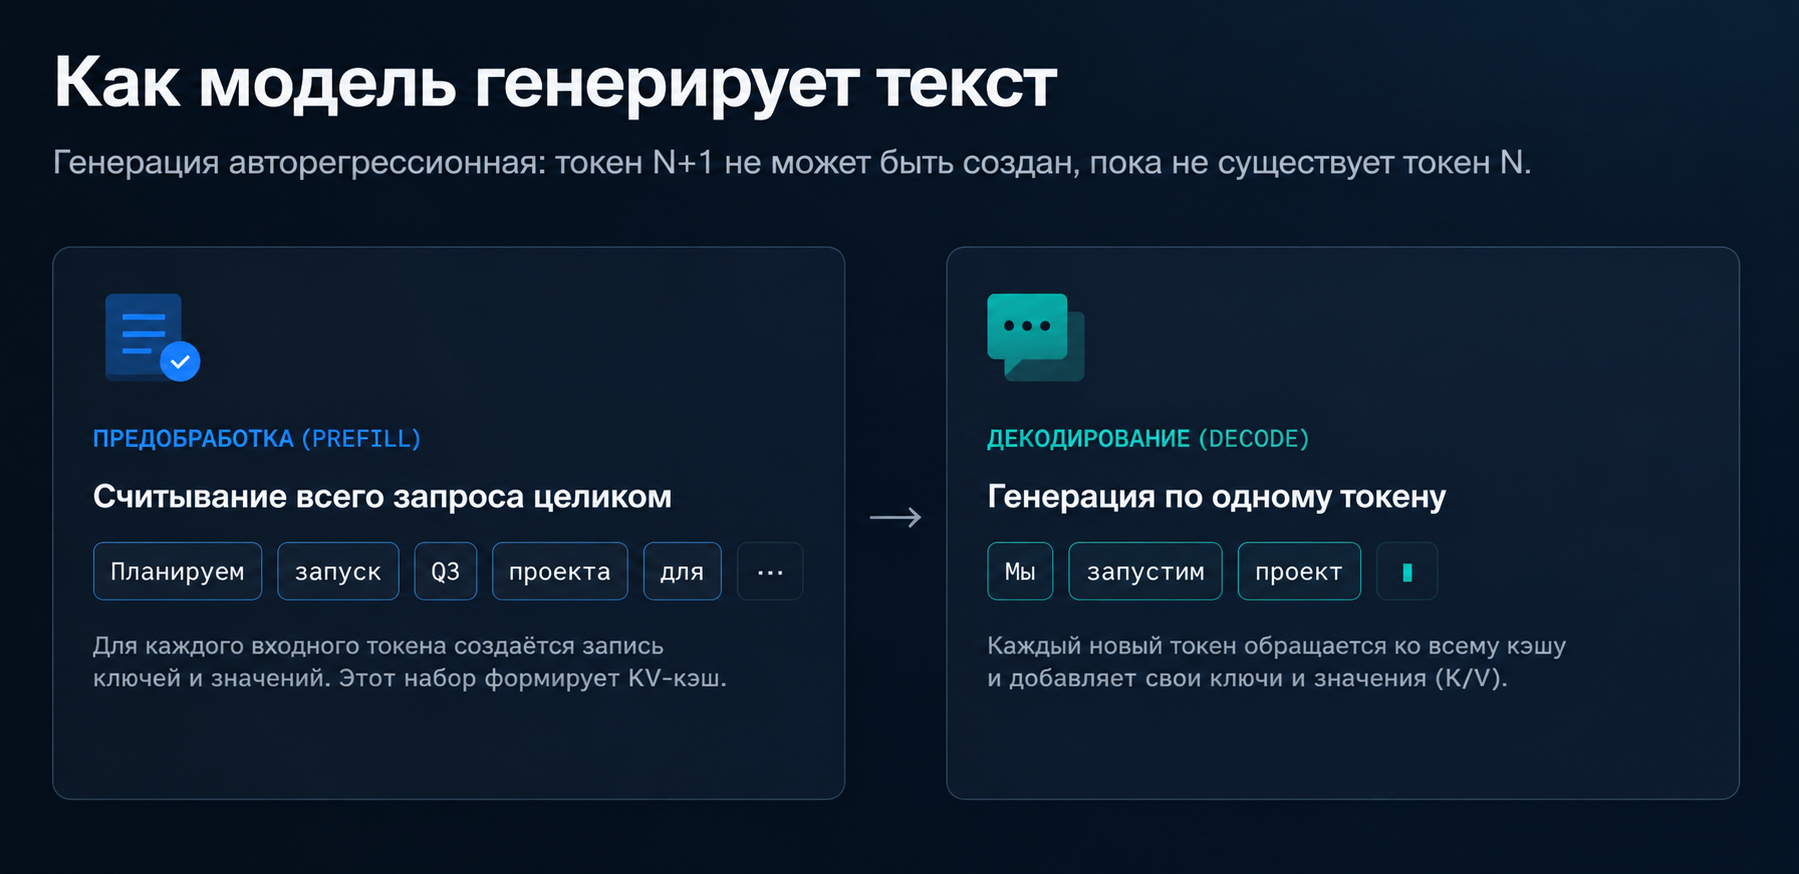
После завершения предварительной обработки система формирует ответ последовательно — по одному токену. Для каждого нового токена она считывает из памяти тензоры K и V всех предшествующих токенов, рассчитывает результат механизма внимания, а затем записывает собственные K и V для следующего шага. Эта фаза называется декодированием. Она выполняется последовательно и ограничивается пропускной способностью памяти: перед генерацией каждого токена необходимо загрузить весь накопленный набор K и V, обработать его механизмом внимания и сохранить новую пару тензоров.
Тензоры K и V, созданные на этапах предварительной обработки и декодирования, образуют KV-кэш. Без него при генерации токена n+1 системе пришлось бы на каждом шаге заново рассчитывать ключи и значения для всех n предыдущих токенов, что приводило бы к квадратичному росту объёма вычислений. При использовании кэша новый токен рассчитывает только собственные K и V, а остальные данные считывает из памяти. Поэтому вычислительные затраты на один шаг растут линейно с длиной контекста.
Как выглядит нагрузка от ИИ-агентов
Обработку запросов часто считают ограниченной пропускной способностью памяти, поскольку в воспринимаемом пользователем времени ответа обычно преобладает этап декодирования. Однако фактическое соотношение двух фаз зависит от характера нагрузки. Короткий запрос на подготовку большого текста создаёт основную нагрузку на декодирование, тогда как длинный запрос ИИ-агента с требованием внести небольшое изменение в JSON — на предварительную обработку. От преобладающей фазы зависит, какие ресурсы сильнее пострадают при неэффективном управлении KV-кэшем.
Масштаб повторных вычислений определяется тем же соотношением, а сценарии работы ИИ-агентов могут существенно различаться. Одним из наиболее распространённых вариантов стало программирование с помощью ИИ-агентов, которое занимает заметное место в статистике использования OpenRouter.
Для оценки характерной нагрузки можно использовать сбор телеметрии Claude Code средствами OpenTelemetry и выгрузку данные за неделю в Grafana. Ниже показано распределение токенов по типам. Измерения проводились с моделью Claude Opus 4.8, поддерживающей контекст до 1 млн токенов, при одновременной работе над несколькими программными проектами.
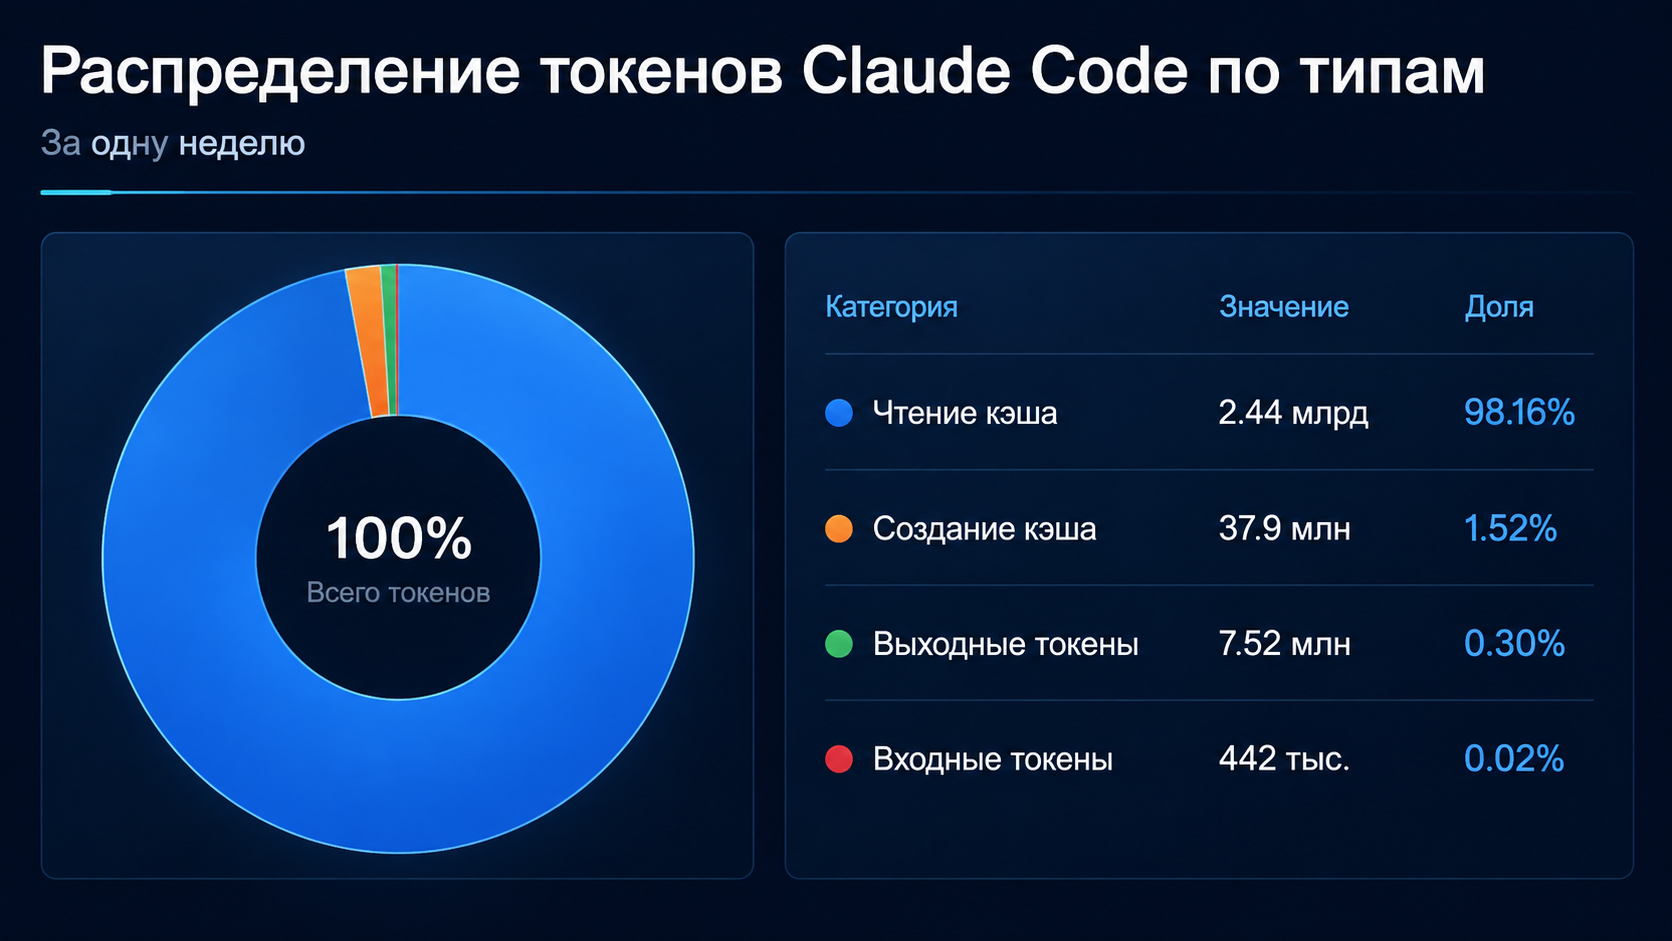
На чтение кэша приходилось 98,16% всего потока токенов. Повторное создание кэша — заново выполненная предварительная обработка ранее встречавшегося префикса после истечения срока хранения записи — составляло 1,52%. Доля выходных токенов достигала 0,30%, а действительно новых входных токенов — только 0,02%.
При нагрузке, в которой около 98% обращений приходится на чтение кэша, его вытеснение без выгрузки заставляет систему повторно обрабатывать основную часть уже подготовленных данных. Узкое место смещается с пропускной способности памяти на этапе декодирования, которую обычно оптимизируют в первую очередь, на вычисления предварительной обработки, ранее уже выполненные графическим ускорителем. По этой же причине в масштабных архитектурах с распределенными узлами обработки нередко используется больше узлов предварительной обработки, чем узлов декодирования: именно первая фаза ограничивает общую производительность.
Показатель 98% отражает структуру нагрузки одного пользователя. В коротких диалогах доля новых входных данных будет выше. Аналогичная картина возможна в системах с дополненной генерацией, где на каждом шаге в контекст добавляются разные документы. Общая закономерность сохраняется для продолжительных диалогов со стабильными префиксами и регулярным возвращением пользователей к ранее накопленному контексту.
Где хранится KV-кэш и что происходит после заполнения памяти
После загрузки весов модели оставшаяся видеопамять выделяется под KV-кэш и разделяется на блоки фиксированного размера. При запуске система сообщает, контекст какого объёма в токенах может вместить эта область. В стандартной конфигурации без выгрузки KV-кэша другого места для его хранения нет.
Серверы с графическими ускорителями требуют значительных вложений, а результат их работы измеряется количеством токенов. Поэтому ускорители необходимо поддерживать под постоянной нагрузкой. Для этого перед ними формируется небольшая очередь запросов, которая не позволяет вычислительным ресурсам простаивать, но при этом ограничивается так, чтобы задержка ответа соответствовала целевому показателю уровня обслуживания (SLO).
Не каждый запрос использует всё доступное контекстное окно, поэтому KV-данные завершённых сеансов могут некоторое время оставаться в видеопамяти. При длительной нагрузке выделенная область постепенно заполняется. После достижения предела старые записи вытесняются, освобождая место для новых.
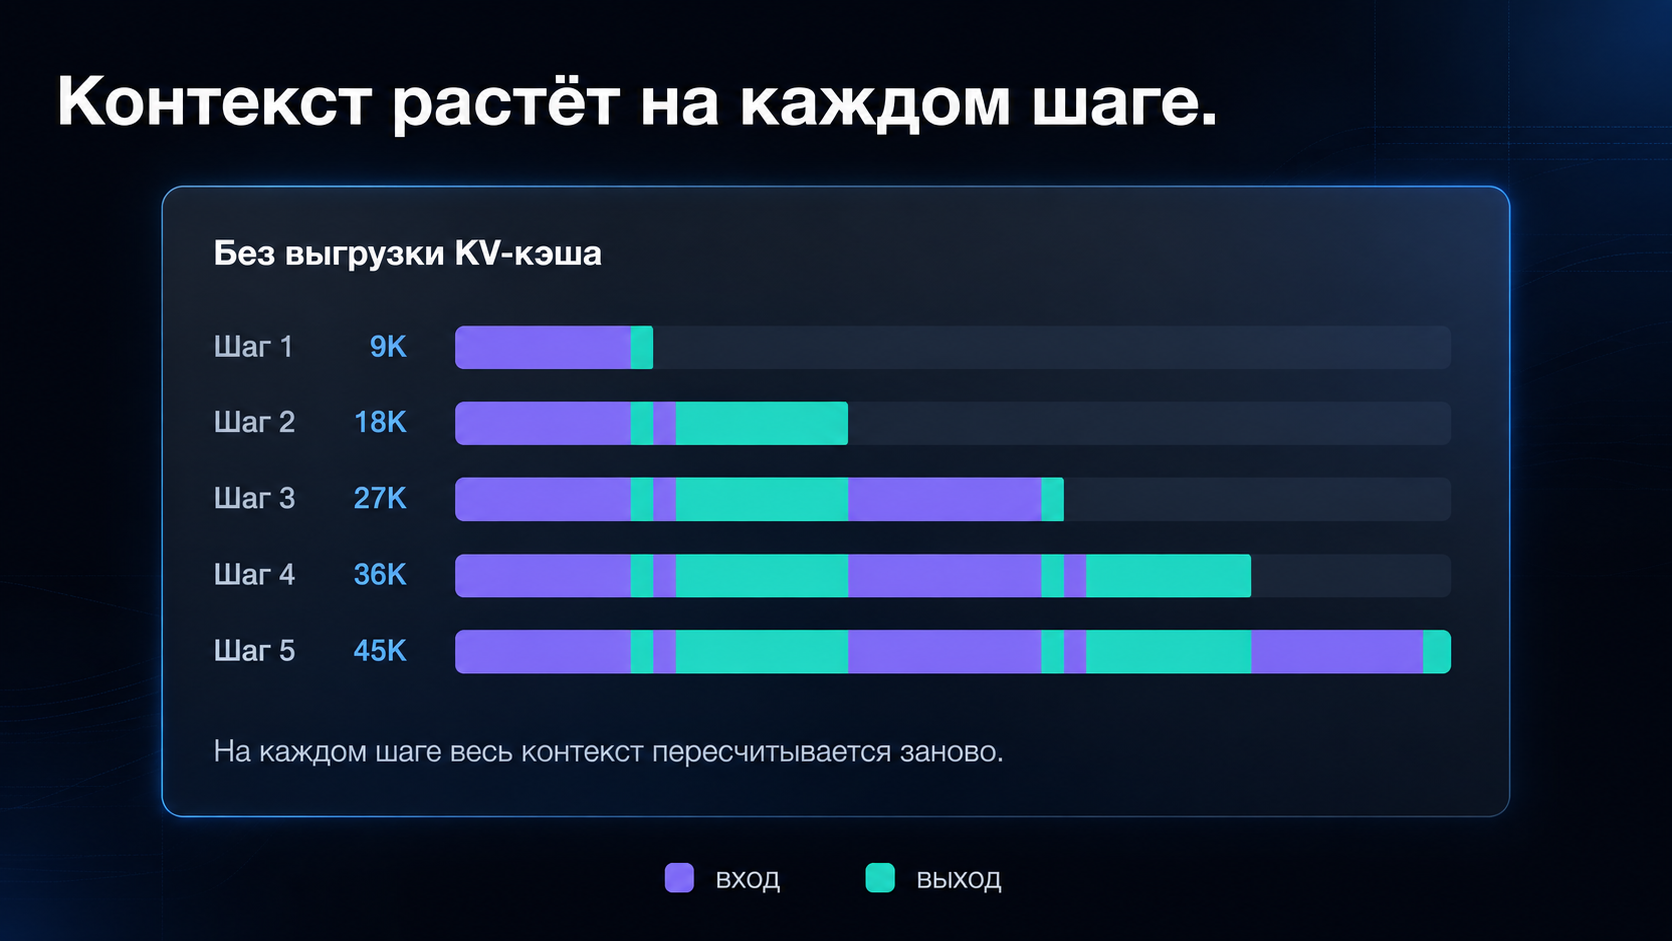
В идеальном сценарии модель формировала бы окончательный ответ за один проход. На практике этого удаётся добиться не всегда, поэтому применяются многошаговые циклы взаимодействия — с последовательным обменом запросами между пользователем и ИИ-агентом либо между несколькими агентами.
Когда поступает следующий запрос и соответствующий KV-кэш отсутствует, система заново обрабатывает всю накопленную историю вместе с новыми токенами. Контекст каждого предыдущего шага повторно проходит через модель, поэтому уже выполненные графическим ускорителем вычисления оплачиваются второй, третьей и последующими обработками. Такие операции расходуют ресурсы, не создавая нового полезного результата.
Что меняет выгрузка KV-кэша
Вместо немедленного удаления данных после заполнения видеопамяти KV-кэш последовательно переносится на нижние уровни хранения: из видеопамяти в оперативную память сервера, а затем — на твердотельные накопители. Наиболее востребованные данные остаются в видеопамяти. Записи, которым там не хватает места, перемещаются в оперативную память, а после её заполнения — на локальные накопители или сетевой уровень хранения.
При достаточной ёмкости уровней выгрузки полное удаление KV-кэша становится редким и определяется преимущественно заданным сроком хранения данных — TTL, а не нехваткой свободной памяти.
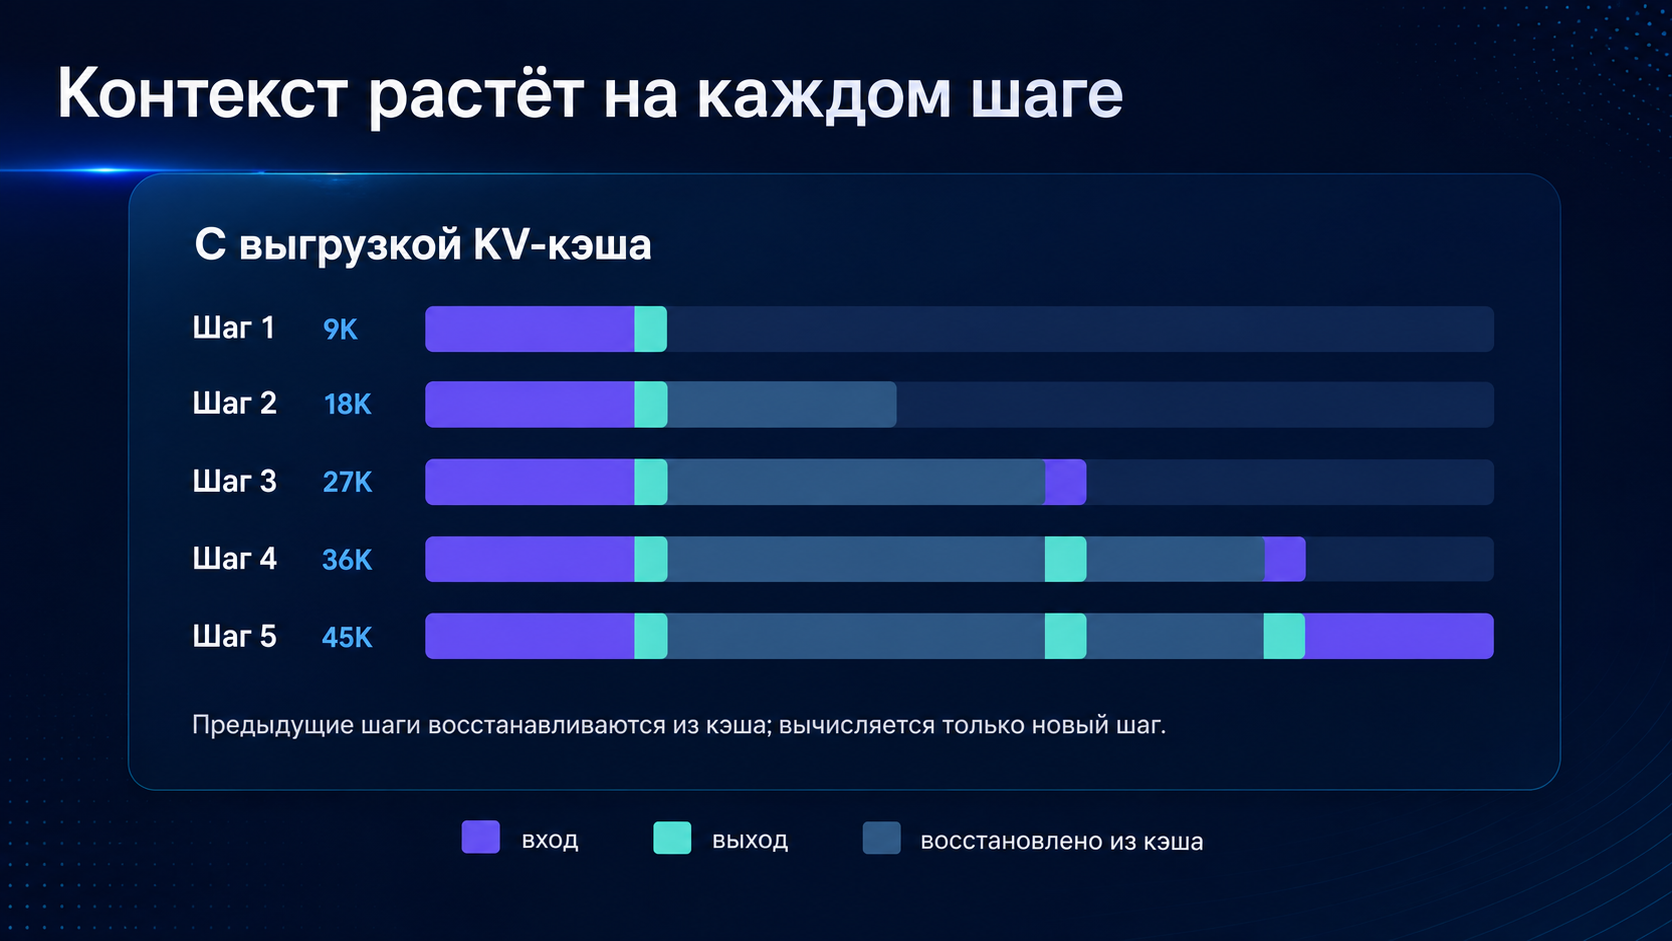
При поступлении следующего запроса вместо повторной обработки десятков тысяч токенов контекста система загружает KV-кэш обратно из оперативной памяти или с накопителей. Восстановление из оперативной памяти добавляет небольшую задержку, но требует значительно меньше времени и вычислительных ресурсов, чем повторная предварительная обработка.
Чтение с NVMe-накопителей выполняется медленнее, чем из оперативной памяти, однако при подходящей конфигурации оно также может занимать меньше времени, чем повторный расчёт контекста. Ёмкость систем хранения сравнительно доступна, тогда как вычислительные ресурсы графических ускорителей остаются дорогими. Поэтому небольшое увеличение задержки в начале очередного шага может быть оправдано, если оно позволяет исключить повторные вычисления продолжительностью в несколько секунд.
От видеопамяти до NVMe: методика тестирования KV-кэша
Для проверки подхода был собран следующий испытательный стенд:
-
Сервер — Dell PowerEdge XE7740
-
Графические ускорители — 4 × NVIDIA RTX PRO 6000 Blackwell Server Edition, по 96 Гбайт
-
Оперативная память — 1 Тбайт DDR5, 16 × 64 Гбайт, 5200 МТ/с
-
Накопители — 8 × Solidigm D7-PS1030 E3.S ёмкостью 12,8 Тбайт, RAID 10
-
Программная платформа обработки запросов — vLLM 0.22.0 и LMCache 0.5.0
-
Модель — MiniMax-M2.7
Dell PowerEdge XE7740 подходит для такой нагрузки благодаря поддержке до восьми полноразмерных двухслотовых графических ускорителей с подключением PCIe Gen5 x16. Испытанная конфигурация с четырьмя ускорителями оставляет возможность увеличить их количество в том же сервере по мере роста нагрузки.
Каждый GPU-ускоритель NVIDIA RTX PRO 6000 Blackwell Server Edition оснащён 96 Гбайт памяти GDDR7. Совокупный объём видеопамяти четырёх ускорителей составляет 384 Гбайт. Физически память распределена между отдельными GPU, а модель и KV-кэш размещаются на них средствами параллельного выполнения vLLM.
Нижний уровень хранения был построен на восьми NVMe-накопителях Solidigm D7-PS1030 PCIe 5.0 ёмкостью 12,8 Тбайт, объединённых в RAID 10. Solidigm относит эту модель к накопителям со средним ресурсом записи, рассчитанным на смешанные и преимущественно ориентированные на запись нагрузки.
Модель MiniMax-M2.7 была выбрана как решение, ориентированное на программирование, программную инженерию и многошаговую работу с инструментами. Она помещалась в конфигурацию из четырёх графических ускорителей. Модель была представлена 18 марта 2026 года.
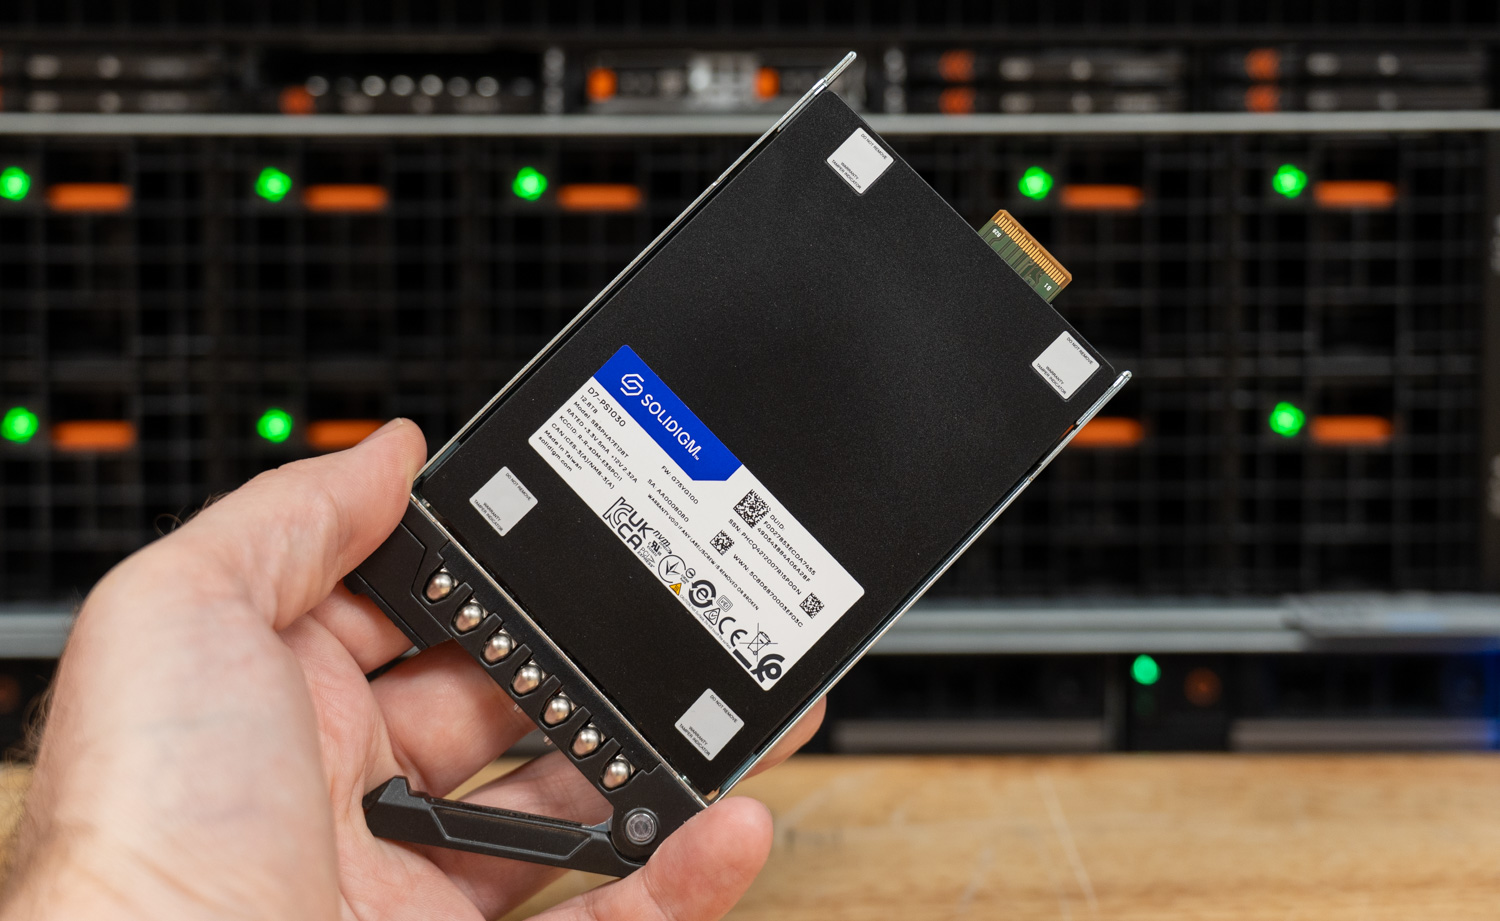
В испытании сравнивались три конфигурации:
-
Базовый вариант — стандартная конфигурация vLLM без выгрузки: KV-кэш сохранялся только в видеопамяти, а не поместившиеся записи вытеснялись.
-
Выгрузка LMCache в оперативную память — под KV-кэш выделялось 512 Гбайт.
-
Выгрузка LMCache на накопители — уровнем хранения служил локальный массив NVMe RAID 10, перед которым использовался промежуточный буфер оперативной памяти объёмом 64 Гбайт.
Нагрузка имитировала реальную работу программных ИИ-агентов, а не последовательное тестирование одного синтетического префикса. Основная её часть приходилась на предварительную обработку контекста, объём выходных данных оставался сравнительно небольшим, а ранее обработанные префиксы использовались многократно.
Сеансы поступали в соответствии с потоком Пуассона с интенсивностью λ = 2,5 сеанса в минуту. Каждый сеанс состоял из нескольких шагов. На очередном шаге модель обычно получала дополнение объёмом от 250 до 600 токенов — например, результат выполнения команды или инструмента. Периодически добавлялось содержимое файла размером от 1500 до 3500 токенов.
Ответ обычно включал от 40 до 200 токенов с вызовами инструментов или краткими рассуждениями. В отдельных случаях модель формировала блок программного кода объёмом от 400 до 900 токенов. Длина каждого шага дополнительно изменялась в пределах ±100 токенов.
Контекст сеансов последовательно увеличивался до предела 64 тыс. токенов. Такая нагрузка позволяла перейти в режим длинного контекста, при котором рабочий набор данных переставал помещаться в видеопамяти. Для всех трёх конфигураций использовалась одна и та же заранее заданная последовательность запросов, а перед измерением выполнялся трёхминутный прогрев кэша.
Первоначально сервер был оснащён 2 Тбайт DDR5. В целом, такой объём избыточен для типичной конфигурации с четырьмя ускорителями, особенно после роста стоимости памяти в 2026 году. Для приближения стенда к более реалистичной конфигурации 1 Тбайт был удалён. В каждом канале оставили по одному модулю памяти, чтобы сохранить максимально доступную пропускную способность. PowerEdge XE7740 располагает восемью каналами памяти на каждый процессор.
При испытании флеш-уровня использовался локальный дисковый механизм LMCache с обязательным промежуточным буфером ОЗУ объёмом 64 Гбайт. За время теста объём KV-кэша на накопителях значительно превысил общий объём оперативной памяти сервера. Поэтому устойчивые результаты отражали фактическую работу массива NVMe, а не обслуживание запросов из ОЗУ.
Пропускная способность под нагрузкой
Совокупная скорость обработки запросов на протяжении испытания по мере того, как рабочий объём KV-кэша превышает ёмкость каждого уровня хранения:
Совокупная пропускная способность по токенам
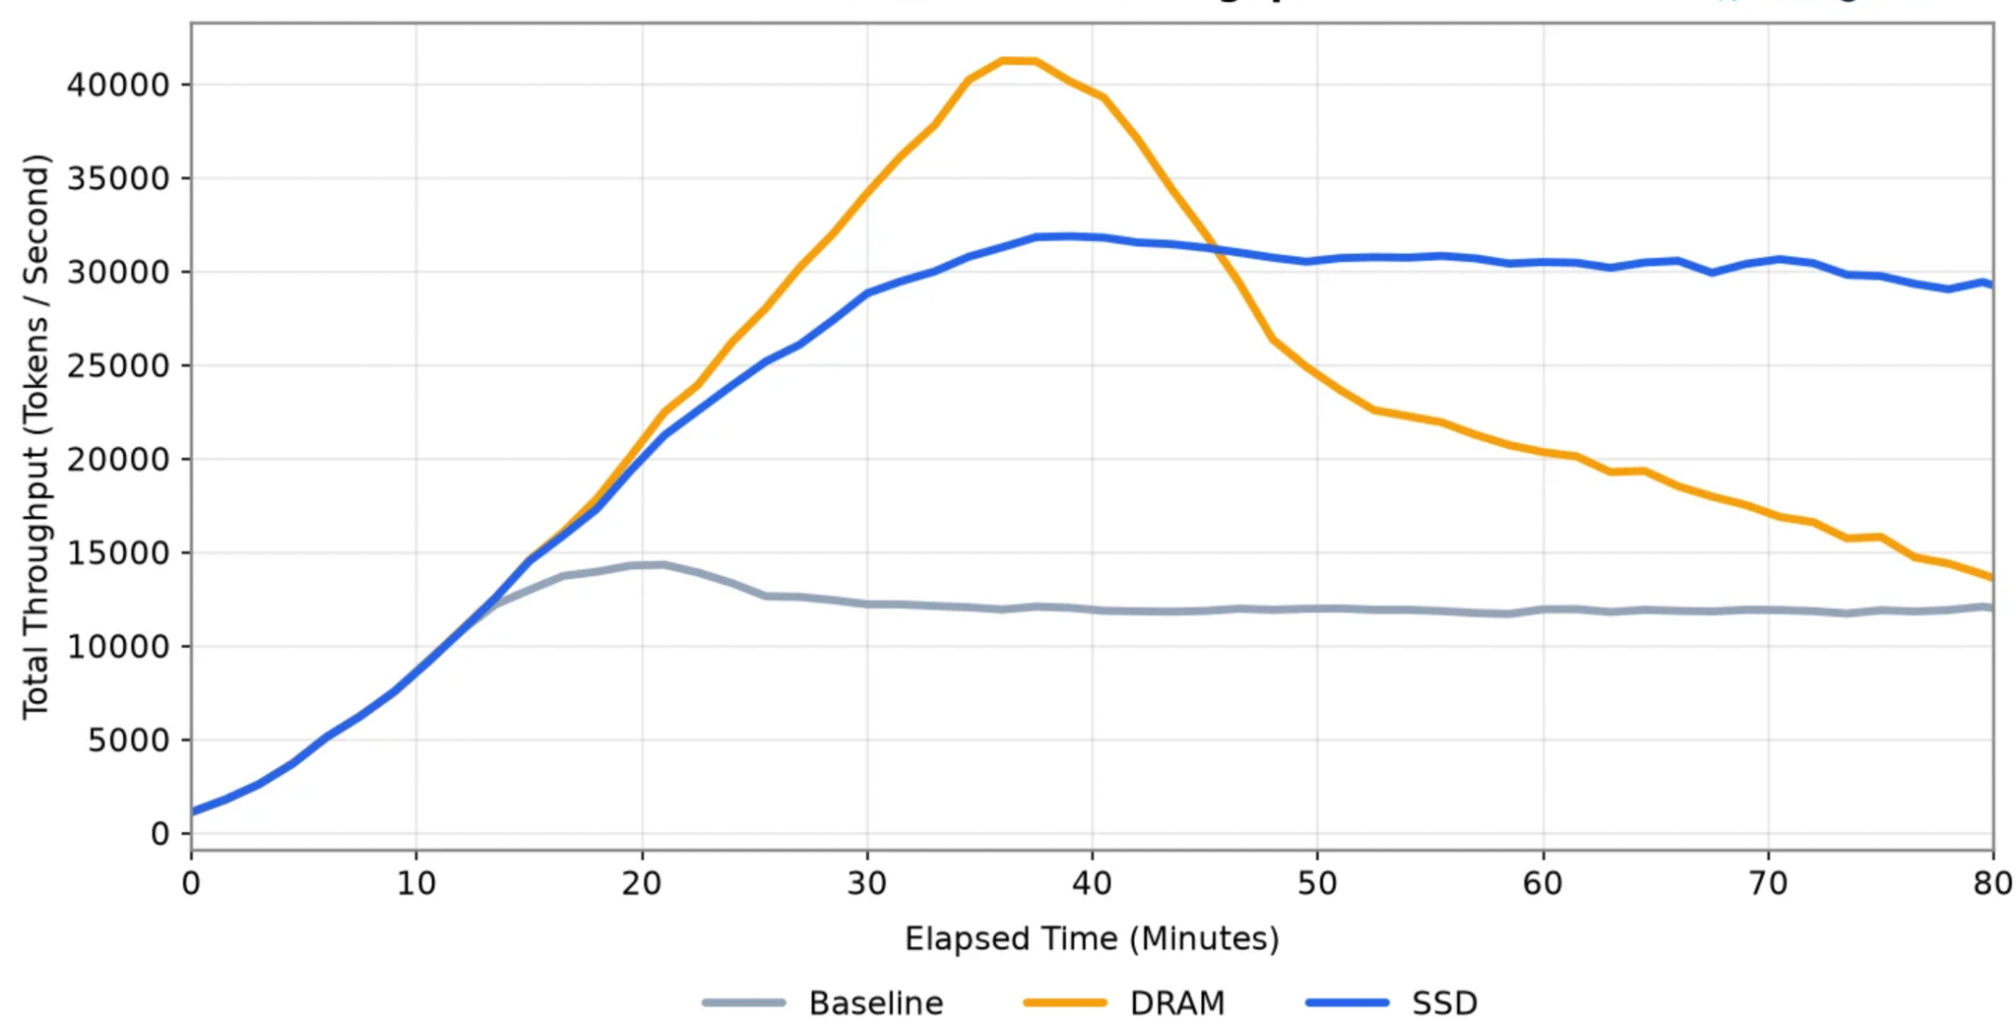
В течение первых десяти минут, пока кэш продолжал заполняться, производительность всех трёх конфигураций росла практически одинаково. Различия появились после заполнения доступных уровней памяти.
Первой достигла предела базовая конфигурация, использующая только видеопамять. После её насыщения совокупная пропускная способность стабилизировалась примерно на уровне 12 тыс. токенов/с. Каждый новый сеанс вытеснял один из ранее сохранённых, а при возвращении пользователя удалённый KV-кэш приходилось создавать заново. В результате всё больше времени расходовалось на повторную предварительную обработку контекста и всё меньше — на генерацию ответа.
Конфигурации с выгрузкой в оперативную память и на накопители продолжали наращивать производительность. Пока их ёмкость оставалась достаточной, большинство ранее обработанных префиксов считывалось из памяти или с дисков, а не рассчитывалось повторно. Время, которое базовая конфигурация тратила на восстановление контекста, использовалось для обработки новых токенов.
На пике выгрузка KV-кэша увеличила совокупную пропускную способность относительно базовой конфигурации до 2,9 раза при использовании оперативной памяти — на 188% — и до 2,2 раза при использовании флеш-накопителей — на 122%. До заполнения видеопамяти результаты всех трёх вариантов отличались менее чем на 1%: вытеснения ещё не происходили, поэтому выгрузка не давала преимущества. Эффект появлялся только после возникновения дефицита памяти и усиливался по мере роста нагрузки.
Преимущество более ёмкого уровня стало особенно заметно после заполнения ОЗУ. При заданной нагрузке кэш объёмом 512 Гбайт достигал предела примерно через 45 минут, после чего начиналось вытеснение данных. При повторном обращении отсутствующие префиксы приходилось обрабатывать заново.
Флеш-уровень, располагающий запасом в несколько терабайт, в рамках испытания этого предела не достиг. После заполнения оперативной памяти накопители поддерживали около 30 тыс. токенов/с против примерно 17 тыс. токенов/с у ОЗУ — преимущество составляло около 75%. После насыщения уровень оперативной памяти сохранял лишь 42% своей пиковой производительности, тогда как флеш-уровень — 94%.
Именно на разнице в ёмкости строится вся иерархия хранения: сначала заканчивается видеопамять, затем — 512 Гбайт оперативной памяти, а измеряемый терабайтами уровень накопителей продолжает хранить контекст после того, как более быстрые уровни уже вынуждены его вытеснять.
При этом совокупный показатель в десятки тысяч токенов в секунду не следует считать скоростью, с которой графические ускорители генерируют новые токены. Значительная его часть отражает пропускную способность уровня выгрузки. В общий результат входят все входные токены предварительной обработки и все выходные токены декодирования. При попадании в кэш префикс не обрабатывается повторно на GPU — соответствующие данные KV загружаются из оперативной памяти или с накопителей.
Если учитывать только выходные токены — ту часть производительности, ожидание которой непосредственно ощущает пользователь, — картина становится более наглядной:
Пропускная способность по выходным токенам
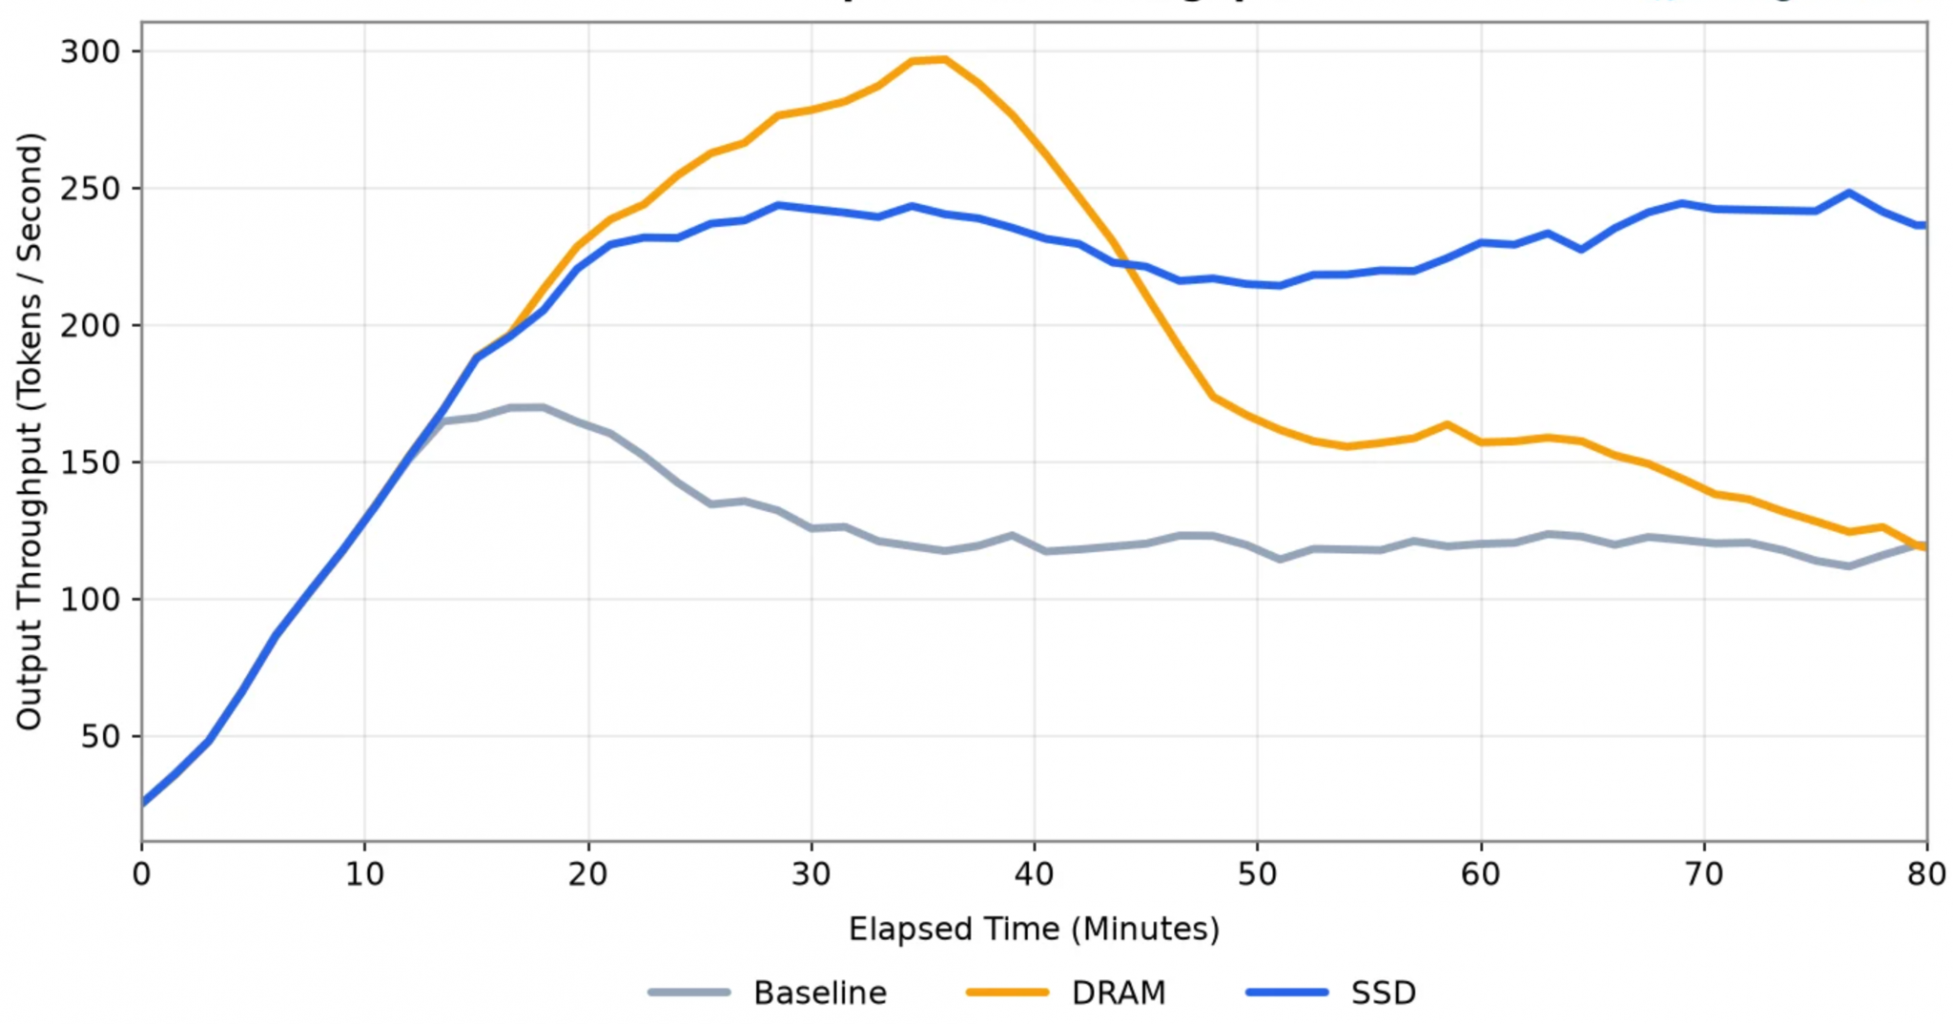
По пропускной способности выходных токенов все три конфигурации также показывали близкие результаты, пока кэш продолжал заполняться, а затем линии расходились. Уровень оперативной памяти достигал пика около 300 токенов/с, что на 75% выше базовой конфигурации, однако после начала вытеснения производительность снижалась. Флеш-уровень сохранял около 250 токенов/с до конца испытания — на 46% выше базового результата.
До заполнения оперативной памяти показатели ОЗУ и накопителей различались примерно на 10%. После достижения предела разрыв между ними увеличивался.
Время до первого токена: сколько ожидает пользователь
Пропускная способность показывает совокупный объём обработки токенов, тогда как время до первого токена — TTFT — отражает задержку, которую видит отдельный пользователь: от отправки запроса до начала формирования ответа. На графике приведено медианное значение TTFT по мере роста рабочего объёма KV-кэша и заполнения каждого уровня хранения.
Пока кэш помещался в доступной памяти, все три конфигурации возвращали первый токен примерно за 0,5 секунды. Затем результаты расходились в том же порядке, что и показатели пропускной способности.
Первой ухудшалась базовая конфигурация без выгрузки: уже на раннем этапе испытания задержка превышала 10 секунд. При использовании оперативной памяти TTFT значительно дольше оставался ниже одной секунды — до заполнения выделенных 512 Гбайт примерно на 45-й минуте. После начала вытеснения KV-кэша и повторных вычислений задержка резко возрастала.
Конфигурация с выгрузкой на накопители демонстрировала наиболее плавный рост TTFT и сохраняла минимальную задержку среди трёх вариантов на протяжении второй половины испытания.
Время до первого токена
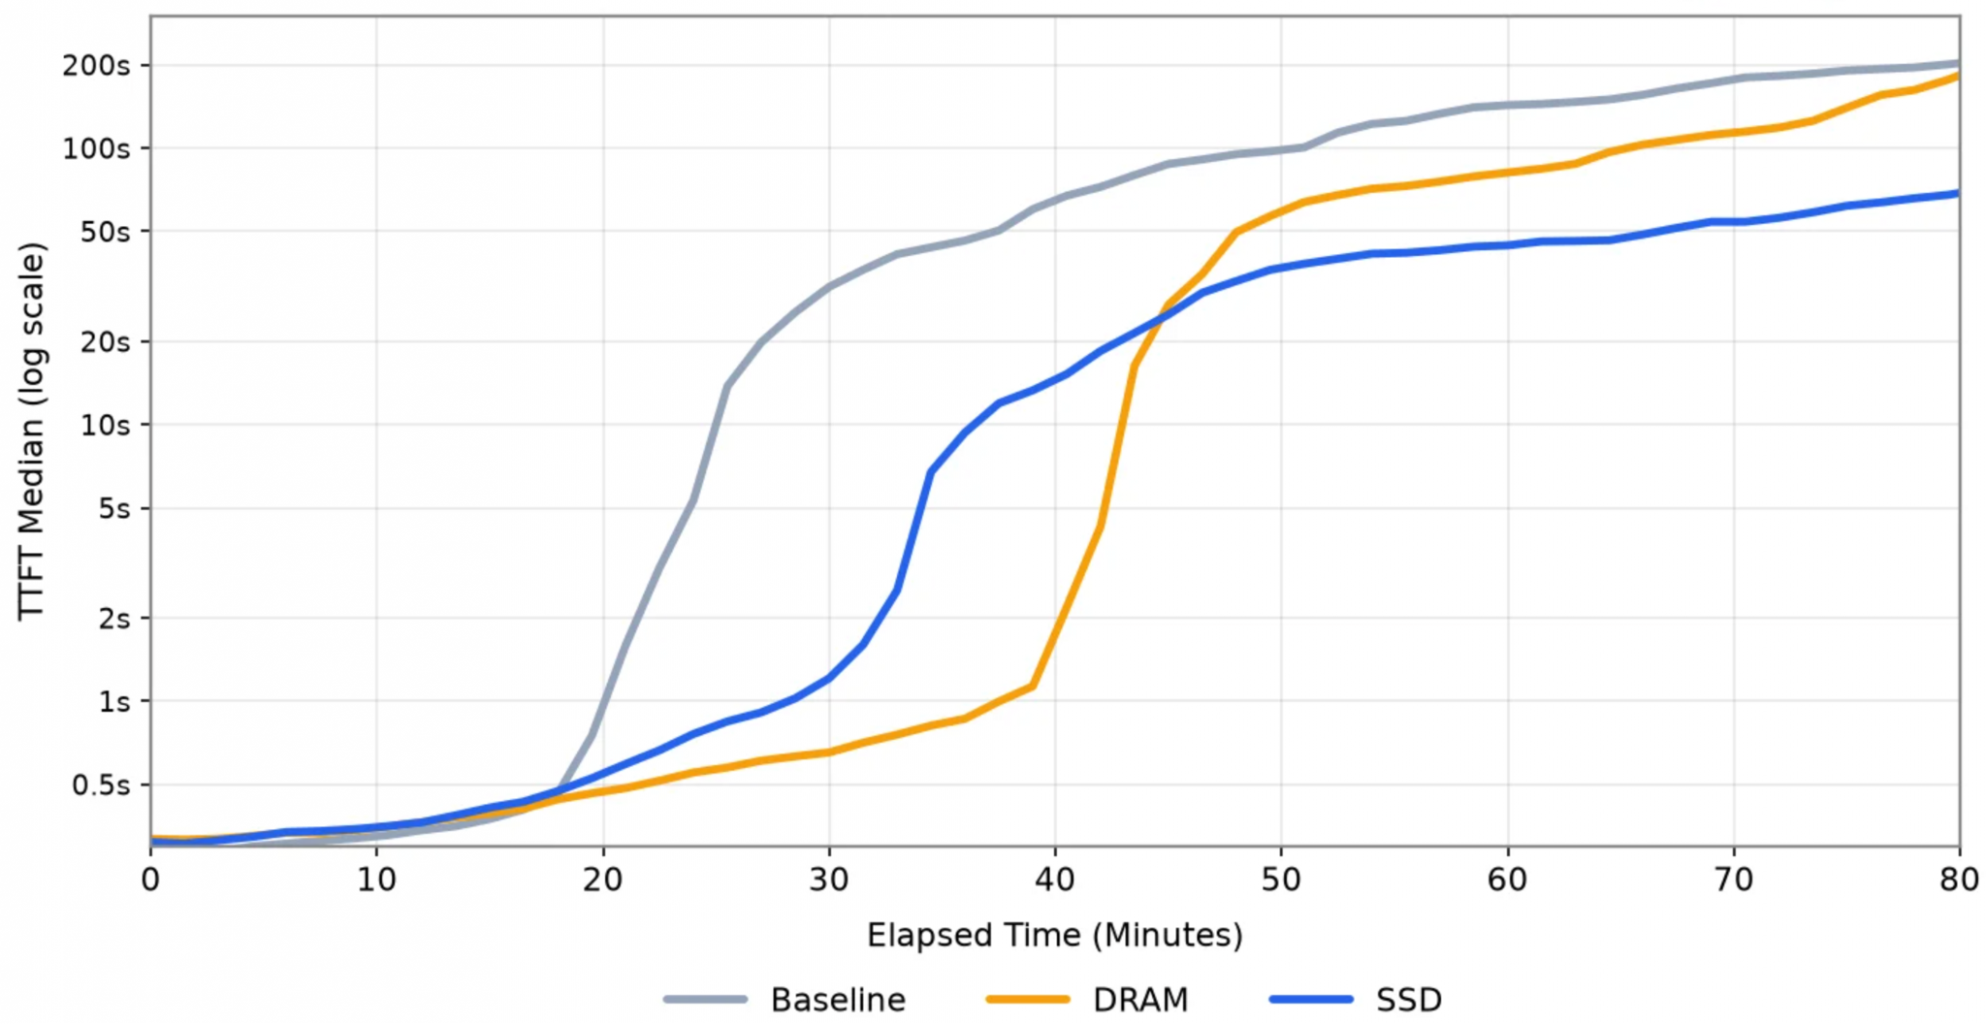
Эта смена преимущества наглядно показывает суть многоуровневого хранения. Пока рабочий объём KV-кэша помещается в оперативной памяти, она обеспечивает минимальную задержку. После заполнения этого уровня преимущество переходит к флеш-накопителям, поскольку они продолжают хранить контекст, который уже начал вытесняться из ОЗУ.
Проблема возвращающегося пользователя
Приведённые выше значения задержки относятся к шагам внутри непрерывного сеанса. При возвращении пользователя сценарий меняется: диалог приостанавливается примерно на 15 минут, а затем продолжается с того же места.
Для моделирования использовалась группа сеансов, которые переходили в неактивное состояние примерно после 20 шагов и возобновлялись через 15 минут. За это время сервер под нагрузкой успевал обработать другие запросы и обновить содержимое кэша.
В окно измерений каждого уровня хранения попало 11 таких возобновлений. Поскольку во всех испытаниях использовалась одинаковая заранее заданная нагрузка, в каждом запуске возобновлялись одни и те же 11 сеансов. Это позволило напрямую сравнить задержку на первом шаге после возврата.
На графике сопоставляется медианное время до первого токена при обычном шаге и при возобновлении сеанса. Вертикальный интервал показывает худший результат среди зафиксированных возвратов.
Задержка при возобновлении сеанса
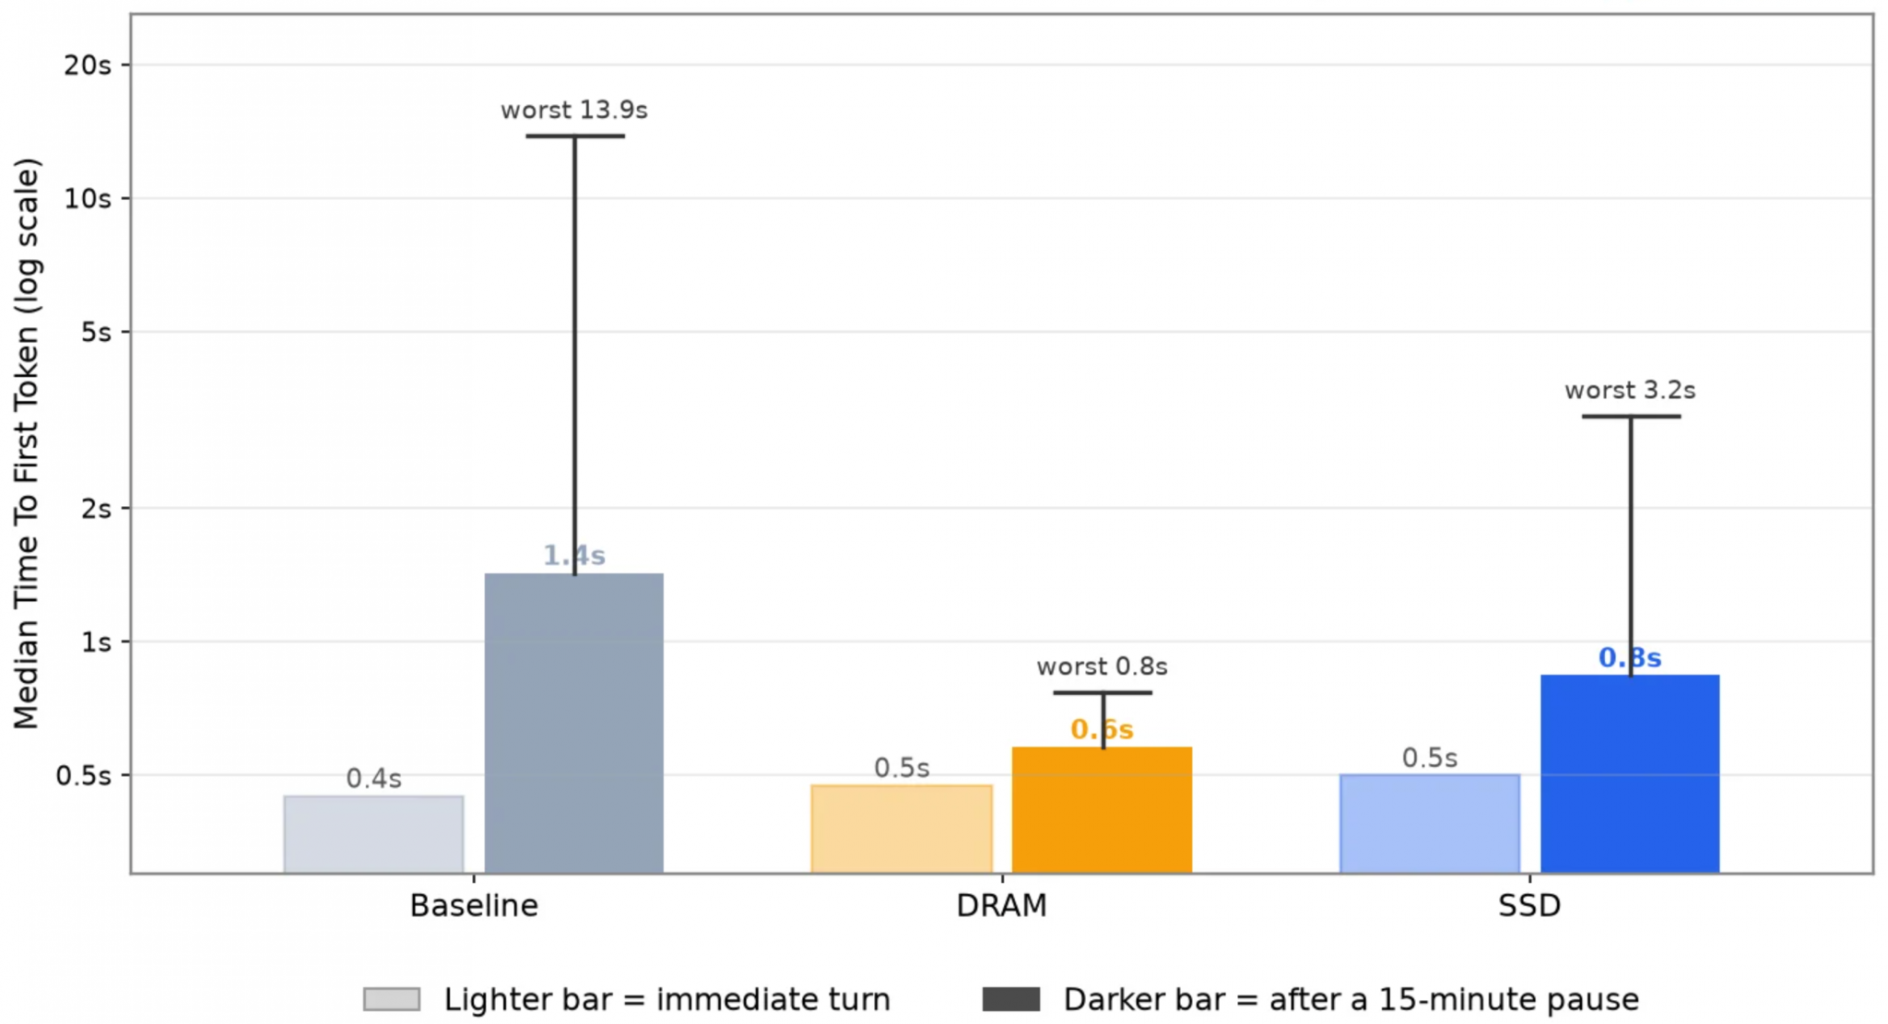
Медианные результаты соответствуют ожидаемому поведению уровней хранения. Оперативная память обеспечивала минимальную задержку: неактивный сеанс возобновлялся за 0,6 секунды против 0,5 секунды при обычном шаге. Флеш-накопители занимали второе место с результатом 0,8 секунды — чтение с NVMe ожидаемо медленнее обращения к ОЗУ. Базовая конфигурация без выгрузки показывала 1,4 секунды: за время простоя префикс сеанса вытеснялся из видеопамяти активными запросами, поэтому при возвращении его приходилось рассчитывать заново. Разница между медианными значениями составляла около одной секунды.
Однако решение определяется не лучшим, а худшим сценарием. Максимальная задержка среди 11 возобновлений составила 0,8 секунды при выгрузке в ОЗУ, 3,2 секунды при использовании накопителей и 13,9 секунды в базовой конфигурации.
Допустимость почти 14-секундного ожидания первого токена зависит от характера сервиса, но для интерактивных систем такая задержка, как правило, означает нарушение целевого уровня обслуживания. Только конфигурации с выгрузкой удерживали максимальное время ожидания в пределах, которые пользователь способен принять.
По мере увеличения контекста разрыв возрастает, поскольку стоимость повторной обработки зависит от объёма накопленной истории. В более длинных сеансах базовая конфигурация превышала задержку в 14 секунд, тогда как ОЗУ и накопители по-прежнему требовали только ограниченного времени на загрузку сохранённого KV-кэша.
Выбор и расчёт объёма KV-кэша
Оба уровня выгрузки значительно превосходят базовую конфигурацию, использующую только видеопамять, и показывают близкую пропускную способность. Разница невелика, поскольку основной прирост достигается за счёт освобождения видеопамяти. Объём высвобождаемого ресурса одинаков независимо от того, перемещается вытеснённый кэш в оперативную память или на накопители.
Для совокупной пропускной способности не принципиально, с какого уровня был восстановлен KV-кэш. Для задержки это важно: чтение из ОЗУ выполняется быстрее, чем с NVMe. Однако оба варианта требуют значительно меньше времени и ресурсов, чем повторный расчёт KV-кэша с нуля.
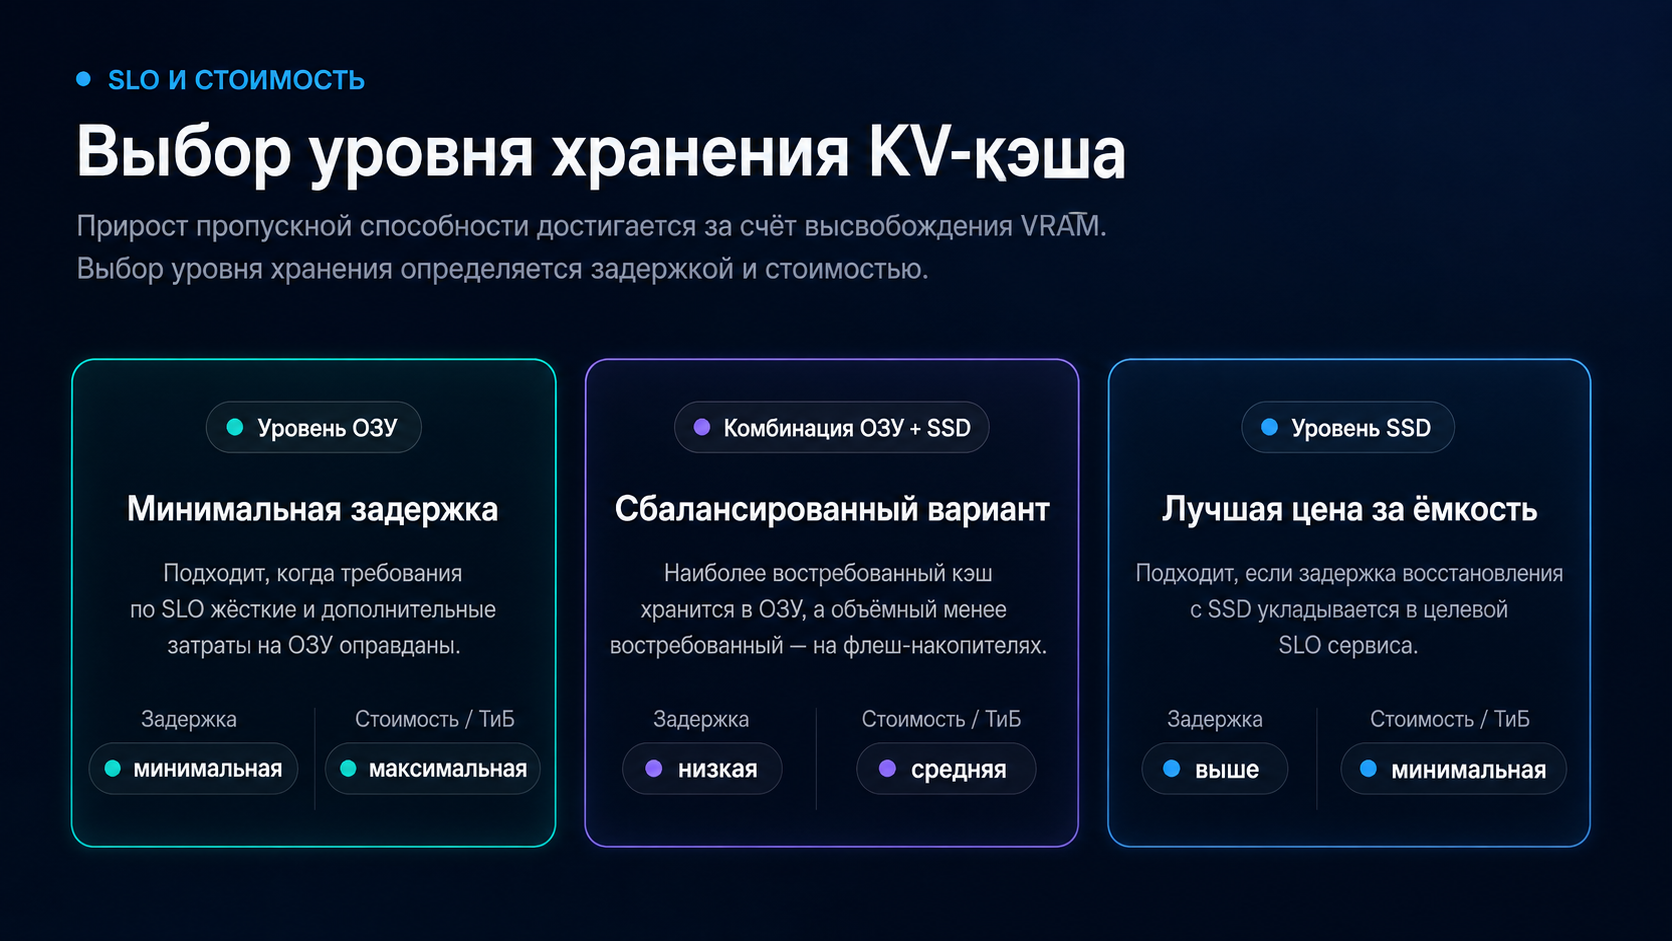
Выбор между ОЗУ и накопителями определяется компромиссом между требованиями SLO и стоимостью инфраструктуры. Размещение всего выгружаемого KV-кэша в оперативной памяти обеспечивает минимальную задержку, но требует значительных капитальных затрат ради сравнительно небольшого преимущества перед флеш-накопителями.
Компромиссным вариантом становится многоуровневая архитектура. Небольшой объём ОЗУ обслуживает наиболее востребованные данные, для которых критична минимальная задержка, а расположенный за ним уровень накопителей хранит более объёмную и реже используемую часть кэша, не требующую восстановления за несколько сотен миллисекунд.
Необходимую ёмкость KV-кэша можно оценивать через его размер. Число токенов, которые система должна одновременно хранить, определяется максимальной пропускной способностью по токенам и заданным сроком хранения записей — TTL. Каждый обработанный токен создаёт собственную запись в KV-кэше.
Для расчёта ёмкости хранения произведение токенов в секунду на TTL необходимо дополнительно умножить на размер KV-кэша одного токена:
Ёмкость KV-кэша = токенов/с × TTL × объём KV-данных на токен.
При тестировании в качестве двух базовых производственных сценариев рассматриваются сроки хранения пять минут и один час.
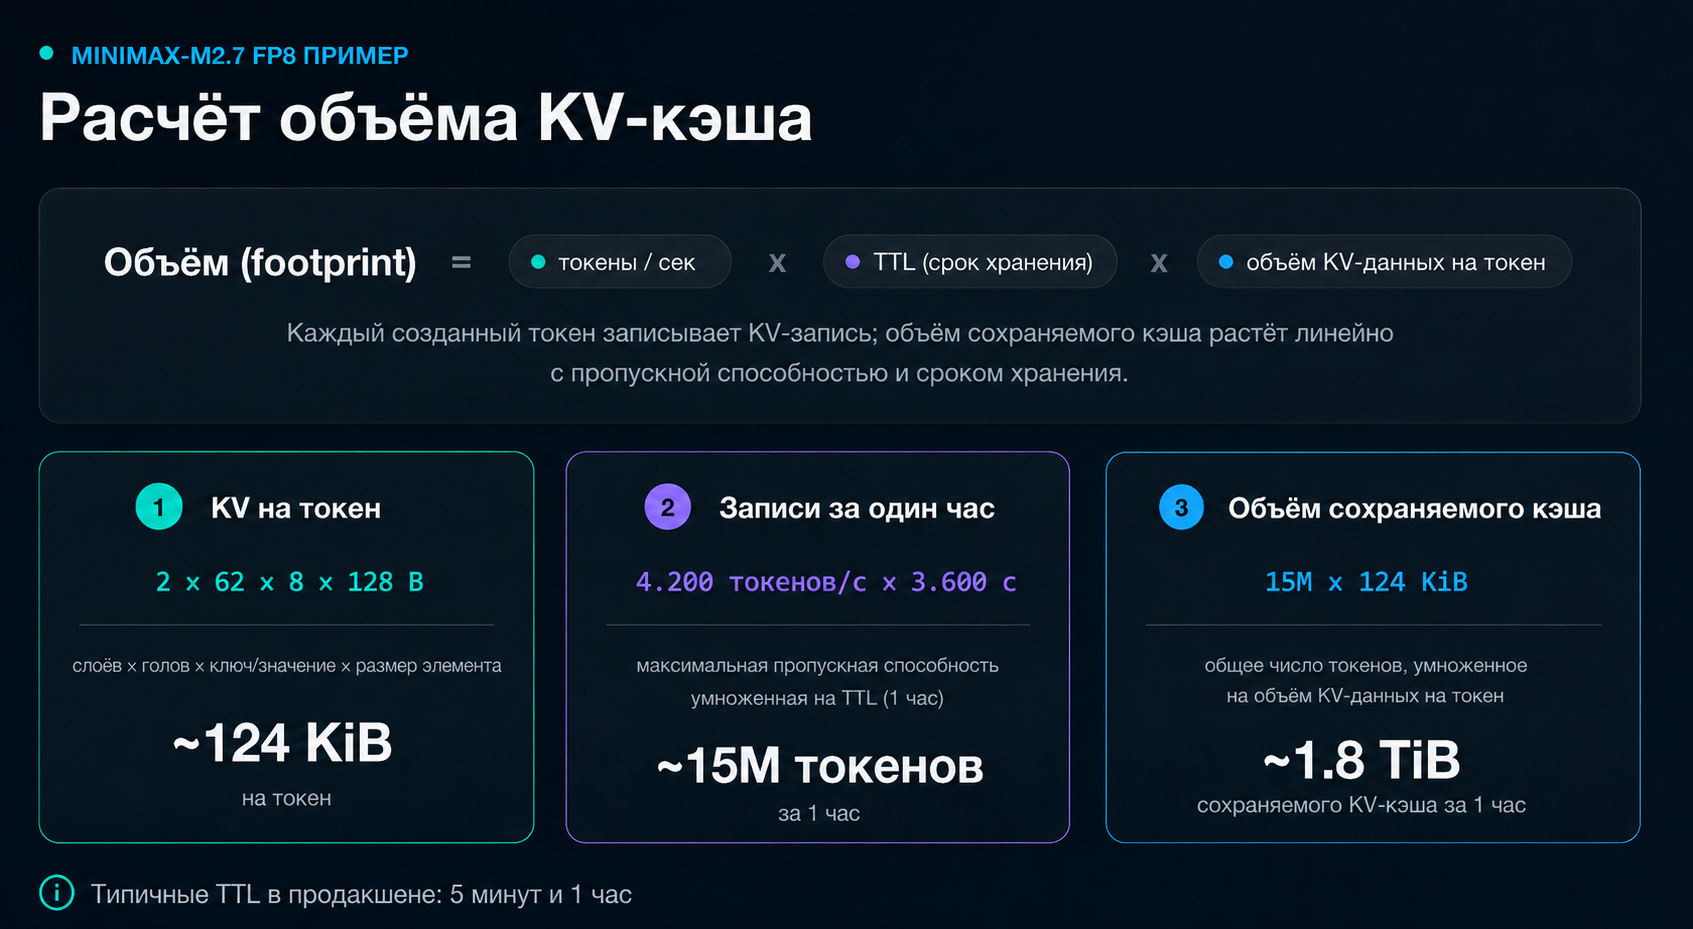
Рассчитаем объём KV-кэша MiniMax-M2.7 в формате FP8 для испытанной конфигурации. При размере одного элемента KV один байт на каждый токен приходится:
2 × 62 × 8 × 128 байт ≈ 124 КиБ.
Для любой модели-трансформера с групповым вниманием используется общая формула:
KV-кэш на токен = число слоёв × число KV-голов × размерность головы × 2 × размер элемента данных.
Множитель 2 учитывает ключ K и значение V. Поэтому увеличение числа слоёв или KV-голов пропорционально повышает объём данных, записываемых для каждого токена.
При пропускной способности около 4200 токенов/с за один час формируется примерно 15,1 млн записей. При 124 КиБ на токен для их хранения требуется около 1,75 ТиБ, или 1,92 Тбайт. Размещение такого объёма полностью в оперативной памяти заметно увеличивает стоимость сервера.
Выбор уровня хранения определяется требованиями SLO и бюджетом. Если задержка восстановления с SSD укладывается в допустимые показатели сервиса, второй уровень KV-кэша можно полностью разместить на накопителях, оставив в ОЗУ только промежуточный буфер, необходимый программной платформе. LMCache поддерживает выгрузку KV-кэша как в оперативную память, так и на локальные SSD и другие внешние уровни хранения.
В ходе испытаний максимальный поток записи KV-кэша составлял 4,1 Гбайт/с, а чтения — 1,1 Гбайт/с. Измеренная с помощью fio предельная пропускная способность массива достигала примерно 114 Гбайт/с. Таким образом, массив RAID 10 располагал почти 28-кратным запасом по скорости.
При сохранении близкого характера нагрузки такой запас позволяет увеличивать число параллельных запросов и масштабировать Dell PowerEdge XE7740 до более плотной конфигурации ускорителей без немедленного упора в пропускную способность накопителей.
Поэтому флеш-уровень можно рассчитывать прежде всего по требуемой ёмкости, а не по максимальной скорости. Каждый дополнительный терабайт увеличивает срок хранения KV-кэша и объём рабочего набора, который остаётся доступным без повторной обработки. Чем больше сохранённого контекста, тем реже GPU приходится заново выполнять предварительные вычисления.
Ресурс записи как основное ограничение
Выгрузка KV-кэша создаёт интенсивную нагрузку на запись. Каждый обрабатываемый токен формирует запись K/V, а удаление данных по истечении TTL постоянно освобождает место для новых записей. Поэтому накопители фактически работают под непрерывной нагрузкой.
В испытанном массиве из восьми накопителей устойчивый входящий поток записи составлял 1,9 Гбайт/с. В RAID 10 данные записываются в двух экземплярах, поэтому суммарная нагрузка на флеш-память удваивается:
1,9 Гбайт/с × 86 400 с × 2 ÷ 8 ÷ 12 800 Гбайт ≈ 3,2 DWPD на накопитель.
Это немного превышает заявленный для Solidigm D7-PS1030 показатель 3 DWPD. Solidigm позиционирует модель как SSD класса средней выносливости для смешанных и ориентированных на запись нагрузок; версия 12,8 Тбайт имеет заявленный ресурс 70 Пбайт записи.
Для основного хранилища данных превышение расчётного DWPD было бы существенным риском. В случае KV-кэша последствия иные: данные являются временными и могут быть заново рассчитаны. Отказ накопителя приводит прежде всего к снижению производительности и повторным вычислениям, а не к потере исходных пользовательских данных.
Для некоторых конфигураций возможен RAID 0. Отсутствие зеркалирования сокращает нагрузку примерно до 1,6 DWPD на накопитель, то есть оставляет её в пределах номинального ресурса. Однако одновременно исчезает отказоустойчивость: выход из строя одного SSD делает недоступным весь массив кэша.
Таким образом, при проектировании флеш-уровня KV-кэша определяющим параметром становится ресурс записи. Высокая пропускная способность современных SSD оставляет значительный запас, тогда как непрерывная перезапись данных быстро расходует их выносливость. Для такой нагрузки необходимы ёмкие корпоративные накопители, рассчитанные на постоянную запись, а схема RAID должна выбираться с учётом допустимого компромисса между ресурсом и отказоустойчивостью.
Токены на каждый вложенный рубль
Результаты испытаний показали, что после превышения ёмкости оперативной памяти флеш-уровень сохраняет большую часть пропускной способности и поддерживает более стабильное время до первого токена. Коммерческая ценность такого подхода определяется стоимостью уровня, на котором хранится KV-кэш.
Очевидный способ сократить повторные вычисления — установить больше оперативной памяти. Однако выгрузка на накопители имеет смысл только в том случае, если дополнительная ёмкость обходится заметно дешевле в расчёте на терабайт.
Наиболее наглядно различие проявляется не в цене, а в доступной ёмкости. Выделенный под выгрузку уровень ОЗУ объёмом 512 Гбайт заполнился и начал вытеснять данные, тогда как измеряемый терабайтами флеш-уровень за время испытания предела не достиг. Размещение десятков терабайт KV-кэша в оперативной памяти рядом с GPU потребовало бы несоразмерно дорогой конфигурации.
Поэтому при достаточно длинном контексте выбор фактически делается не между быстрым ОЗУ и более медленными накопителями. Он делается между сохранением KV-кэша на SSD и его удалением. Именно вытеснение контекста приводит к повторной предварительной обработке, снижению пропускной способности и увеличению задержки.
Корпоративные SSD традиционно предлагают существенно большую ёмкость при меньшей стоимости терабайта, чем DRAM. Это связано в том числе с различиями в устройстве памяти: DRAM рассчитана на минимальную задержку, а многослойная NAND — на высокую плотность хранения.
В 2026 году цены на оба вида памяти резко выросли. По данным TrendForce, в I квартале контрактные цены на стандартную DRAM увеличились примерно на 90–95% квартал к кварталу, а на NAND Flash — на 55–60%. Во II квартале прогноз составлял 58–63% для DRAM и 70–75% для NAND. В III квартале рост должен заметно замедлиться: стандартная DRAM может подорожать ещё на 13–18%, а NAND Flash — на 10–15% к предыдущему кварталу. Основными причинами замедления станут высокая база сравнения, рекордный уровень цен и снижение готовности производителей потребительской электроники принимать дальнейшее удорожание. При этом спрос со стороны серверов для ИИ и центров обработки данных останется высоким, поэтому речь идёт не о снижении стоимости, а о переходе от резких скачков к более умеренному росту.
Несмотря на рост цен, разрыв в стоимости терабайта сохраняется. Флеш-накопители остаются практичным уровнем для размещения многотерабайтного KV-кэша в пределах бюджета промышленной системы обработки запросов.
Пропускная способность и стоимость в данном случае указывают в одном направлении. После заполнения ОЗУ флеш-уровень обрабатывал больше токенов в секунду, а не меньше. Поэтому увеличение ёмкости не потребовало жертвовать устойчивой производительностью: накопители одновременно сохраняли больше контекста и превосходили переполненный уровень оперативной памяти.
Оперативная память остаётся предпочтительным уровнем, пока рабочий объём KV-кэша в неё помещается и требования к задержке оправдывают дополнительные затраты. Перед накопителями также сохраняется небольшой промежуточный буфер ОЗУ, необходимый программной платформе.
Однако расширение конфигурации дополнительными GPU и модулями DRAM означает максимальные затраты на терабайт ради пиковой производительности, которая сохраняется только до заполнения кэша. Выгрузка или многоуровневое хранение на SSD позволяет удержать большую часть производительности и разместить значительно больше контекста при меньшей стоимости ёмкости.
Окончательный выбор определяется требованиями SLO: допустимым временем до первого токена, характером пользовательских сеансов и сроком хранения KV-кэша.






Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!