Что такое NVIDIA A100
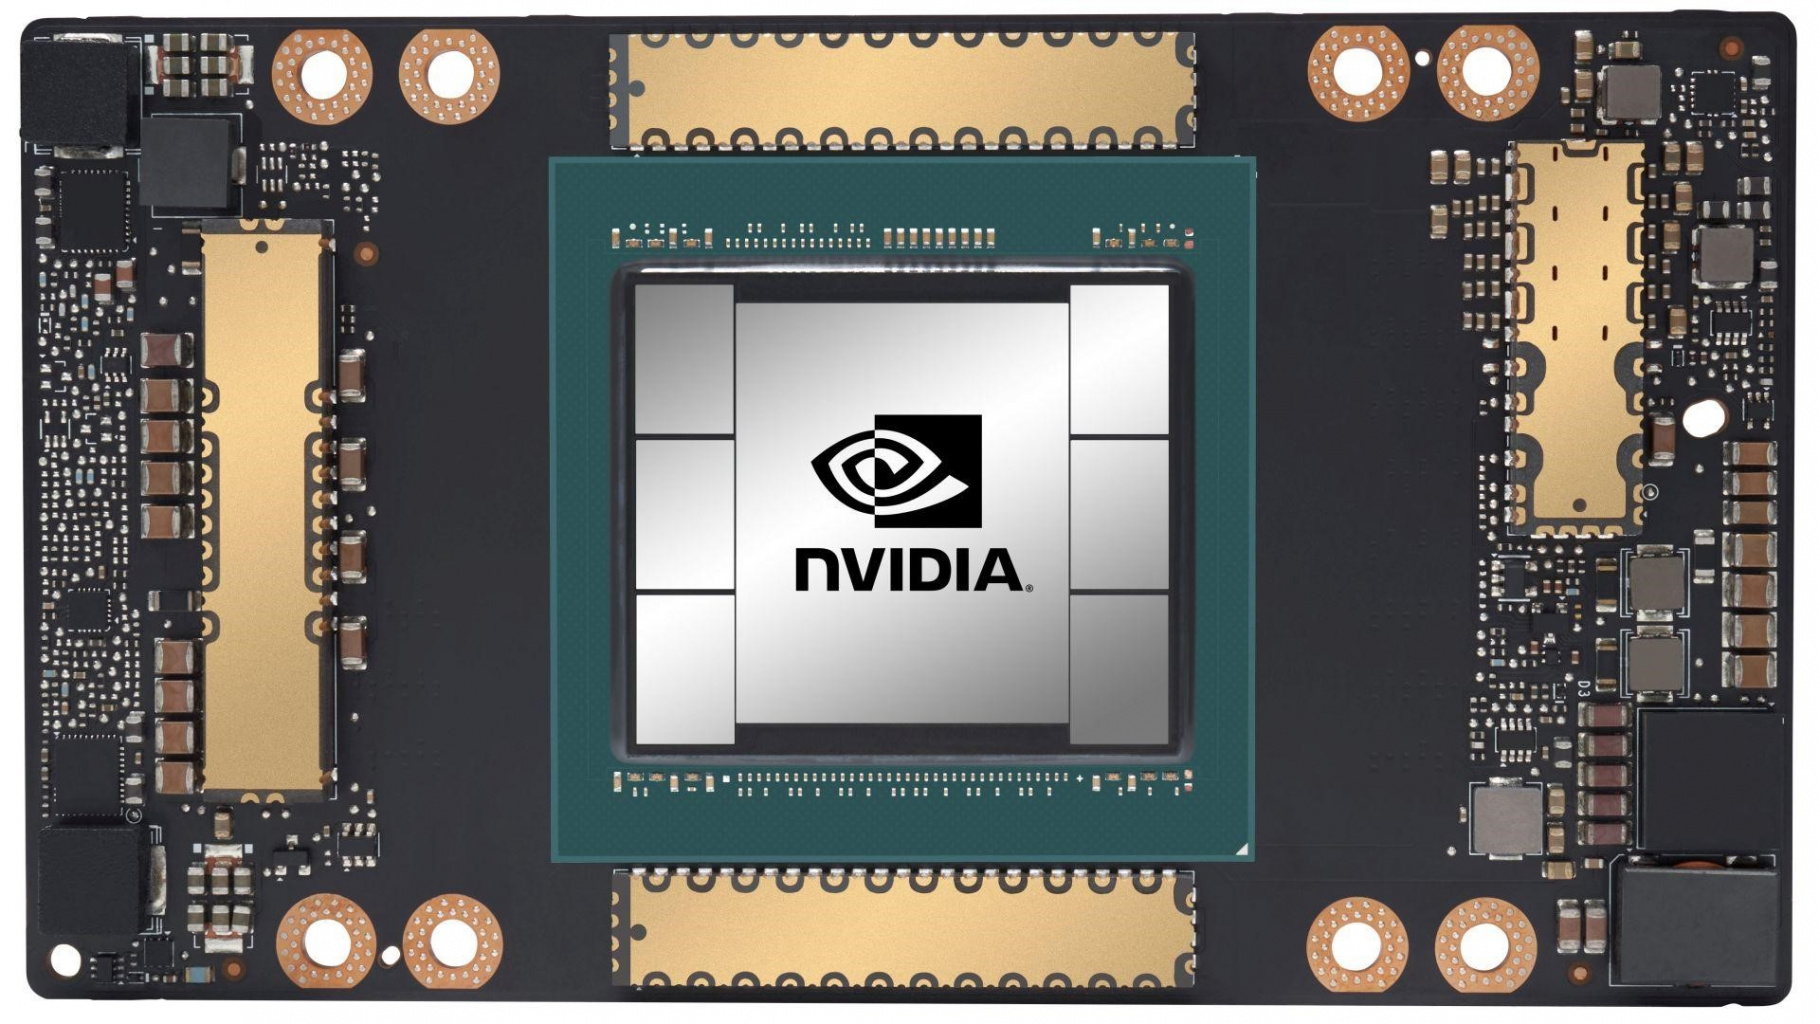
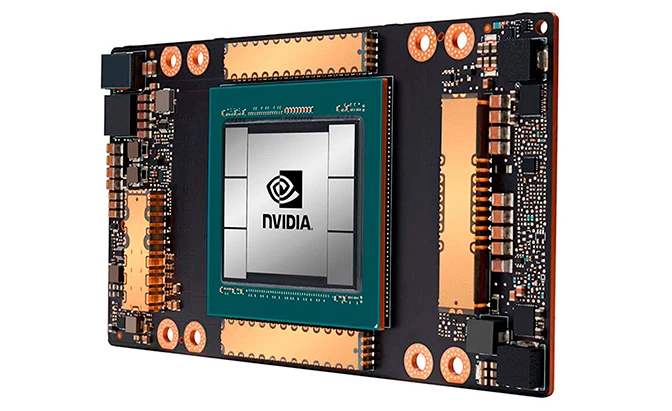
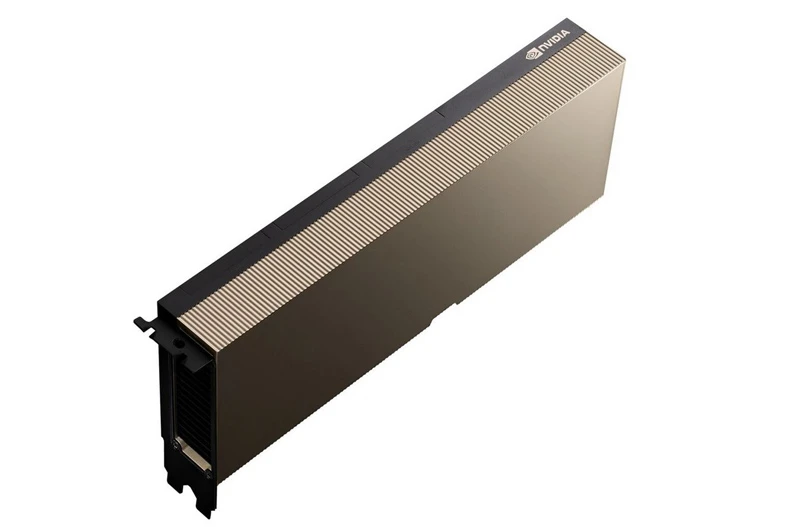
NVIDIA A100 Tensor Core GPU — это серверный вычислительный ускоритель на архитектуре NVIDIA Ampere. Он предназначен для задач искусственного интеллекта, высокопроизводительных вычислений, аналитики больших данных, инференса нейросетей и построения GPU-кластеров. Хотя A100 часто называют видеокартой, по сути это не графическая карта в привычном смысле, а специализированный дата-центровый ускоритель для параллельных вычислений.
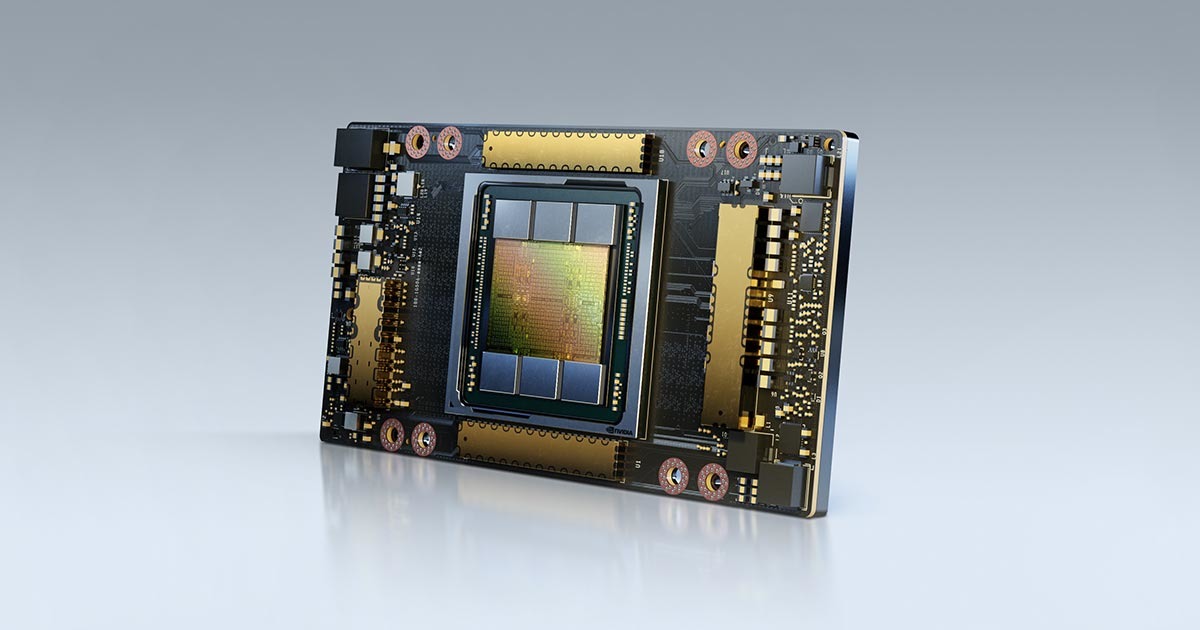
A100 не ориентирована на вывод изображения и работу с графикой на рабочем месте пользователя. Ее задача — ускорять вычисления в серверной инфраструктуре: обучение нейросетей, запуск моделей в production, инженерные симуляции, обработку больших массивов данных, научные расчеты и облачные GPU-сервисы. Именно поэтому A100 используется в GPU-серверах, кластерах, суперкомпьютерах, корпоративных AI-платформах и исследовательских центрах.
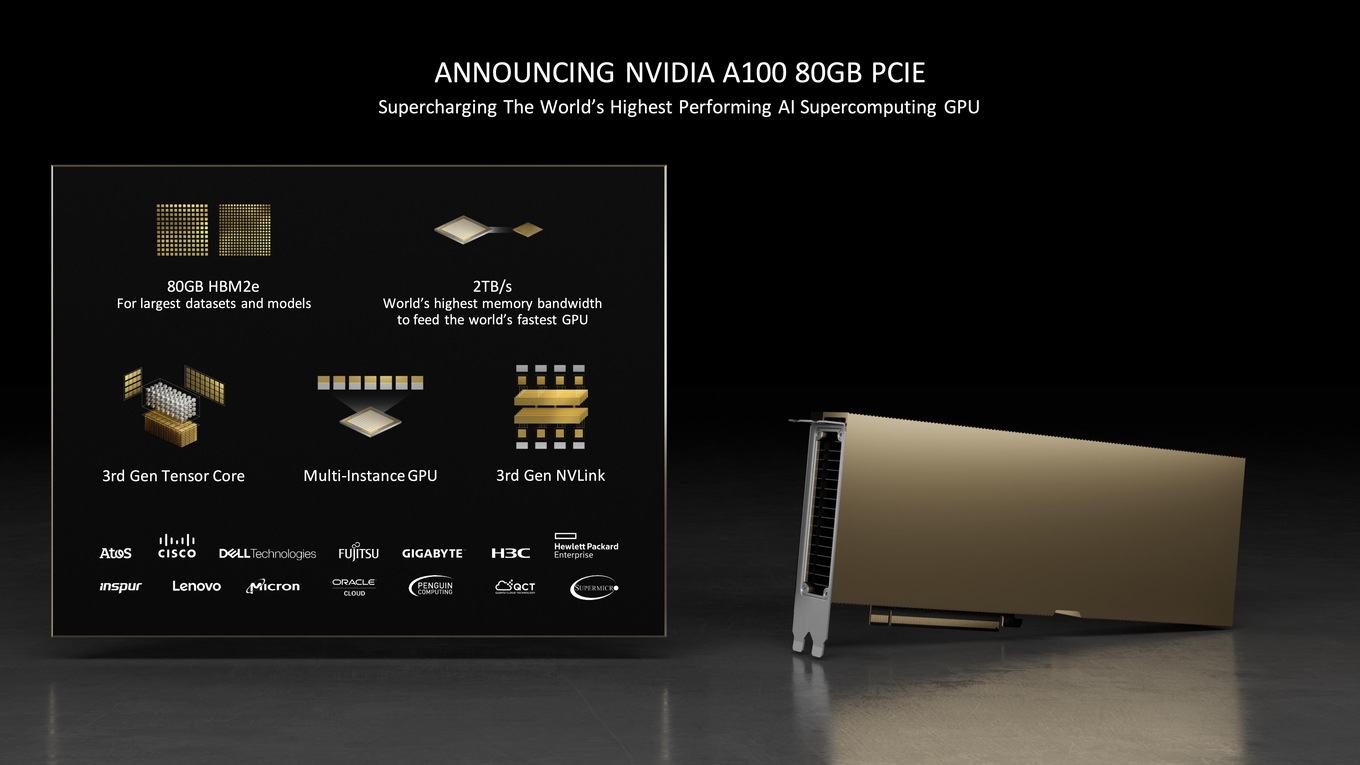
Главная особенность NVIDIA A100 — универсальность. Одна и та же GPU может применяться для разных классов задач: от обучения моделей машинного обучения до HPC-расчетов двойной точности. В A100 объединены тензорные ядра третьего поколения, высокоскоростная HBM-память, поддержка разных форматов вычислений, аппаратное разделение GPU через Multi-Instance GPU и масштабирование через NVLink.
|
Параметр
|
Значение
|
|
Архитектура
|
NVIDIA Ampere
|
|
GPU
|
GA100
|
|
Основное назначение
|
AI training, AI inference, HPC, аналитика данных
|
|
Форм-факторы
|
PCIe и SXM
|
|
Память
|
40 ГБ HBM2 или 80 ГБ HBM2e
|
|
Максимальная пропускная способность памяти
|
до 2 039 ГБ/с
|
|
FP32
|
19,5 TFLOPS
|
|
FP64 Tensor Core
|
19,5 TFLOPS
|
|
TF32 Tensor Core
|
156 TFLOPS / 312 TFLOPS с разреженностью
|
|
FP16 / BF16 Tensor Core
|
312 TFLOPS / 624 TFLOPS с разреженностью
|
|
INT8 Tensor Core
|
624 TOPS / 1 248 TOPS с разреженностью
|
|
Multi-Instance GPU
|
до 7 изолированных GPU-инстансов
|
|
TDP
|
250–400 Вт в зависимости от версии
|
Почему NVIDIA A100 важна для бизнеса
Компании используют A100 там, где обычных CPU-серверов уже недостаточно. Это могут быть задачи, в которых нужно быстро обучать модели, обрабатывать большие массивы данных, запускать AI-сервисы с высокой нагрузкой или выполнять инженерные расчеты, занимающие часы и дни на классической инфраструктуре.
A100 особенно полезна в проектах, где вычислительная нагрузка регулярно растет. Например, модель становится больше, датасеты увеличиваются, количество пользователей AI-сервиса растет, а время обработки запросов должно оставаться низким. В таких условиях GPU-ускорение позволяет не просто ускорить отдельную задачу, а изменить экономику всего процесса: быстрее проводить эксперименты, чаще обновлять модели, сокращать время расчетов и эффективнее использовать серверные ресурсы.
Еще одно преимущество A100 — возможность консолидации нагрузок. Один сервер с несколькими A100 может заменить набор разрозненных вычислительных узлов и обслуживать разные команды или сервисы. Благодаря Multi-Instance GPU один физический ускоритель можно разделить на несколько изолированных GPU-инстансов, если задача не требует всей мощности карты целиком.
Архитектура NVIDIA Ampere
Чип GA100
В основе NVIDIA A100 находится графический процессор GA100. Это крупный дата-центровый чип, разработанный специально для вычислительных нагрузок. Он производится по 7-нм техпроцессу и содержит 54,2 млрд транзисторов. По своему классу это не потребительская GPU, а специализированный ускоритель для серверов, кластеров и высоконагруженных вычислительных систем.
Полная архитектурная конфигурация GA100 включает 128 потоковых мультипроцессоров SM, 8 192 FP32 CUDA-ядер и 512 тензорных ядер. В серийной A100 активна не вся конфигурация: используется 108 SM, 6 912 FP32 CUDA-ядер и 432 тензорных ядра. Это стандартный подход для крупных дата-центровых чипов, где коммерческая версия подбирается по балансу производительности, энергопотребления, тепловыделения и надежности.
|
Параметр
|
Полный GA100
|
NVIDIA A100
|
|
Потоковые мультипроцессоры SM
|
128
|
108
|
|
FP32 CUDA-ядер
|
8 192
|
6 912
|
|
Tensor Cores
|
512
|
432
|
|
HBM-стеки
|
6
|
5
|
|
Контроллеры памяти
|
12 × 512 бит
|
10 × 512 бит
|
|
Тип продукта
|
Полная архитектурная конфигурация
|
Серийный дата-центровый ускоритель
|
Потоковый мультипроцессор SM
Потоковый мультипроцессор SM — базовый вычислительный блок GPU NVIDIA. В A100 каждый SM содержит 64 FP32 CUDA-ядра и 4 тензорных ядра третьего поколения. Именно SM выполняют основную работу при параллельной обработке данных: математические операции, тензорные вычисления, работу с памятью и выполнение CUDA-кода.
По сравнению с предыдущими поколениями архитектура Ampere получила более мощные тензорные ядра, поддержку новых форматов данных, увеличенный кэш и улучшенные механизмы работы с памятью. Это особенно важно для задач машинного обучения, где производительность определяется не только числом CUDA-ядер, но и эффективностью матричных операций.
Главное отличие Ampere от Volta
Предыдущее поколение дата-центровых GPU NVIDIA — Volta — стало важным этапом благодаря появлению тензорных ядер. Но Ampere заметно расширила эту концепцию. A100 получила поддержку TF32, BF16, FP64 Tensor Core, структурной разреженности, Multi-Instance GPU, увеличенного L2-кэша и более быстрой HBM-памяти.
Если сравнивать A100 и V100 только по FP32-производительности, прирост не выглядит радикальным. Но в реальных AI-нагрузках ключевую роль играют Tensor Cores, mixed precision, пропускная способность памяти и объем HBM. Именно по этим направлениям A100 значительно превосходит V100.
Тензорные ядра третьего поколения
Зачем нужны Tensor Cores
Tensor Cores — это специализированные вычислительные блоки для ускорения матричных операций. Такие операции лежат в основе большинства современных нейросетей: transformer-моделей, сверточных сетей, рекомендательных систем, моделей распознавания речи, компьютерного зрения и генеративного ИИ.
В A100 используются тензорные ядра третьего поколения. Они поддерживают больше форматов данных и обеспечивают высокую производительность не только для обучения, но и для инференса. Благодаря этому A100 подходит как для экспериментальной разработки моделей, так и для production-сервисов, где важны скорость, стабильность и стоимость обработки запроса.
|
Формат
|
Где применяется
|
Особенность на A100
|
|
FP64
|
HPC, научные расчеты, инженерное моделирование
|
Поддерживается нативно и через FP64 Tensor Core
|
|
FP32
|
Универсальные вычисления, классическое обучение моделей
|
Может ускоряться через TF32 в AI-нагрузках
|
|
TF32
|
Обучение нейросетей на FP32-данных
|
Позволяет ускорять FP32-пайплайны без глубокой переработки кода
|
|
FP16
|
Mixed precision training, инференс
|
Высокая производительность на Tensor Cores
|
|
BF16
|
Обучение крупных моделей
|
Широкий диапазон значений при компактном 16-битном формате
|
|
INT8
|
Инференс, production-AI
|
Высокая пропускная способность при квантовании моделей
|
|
INT4
|
Специализированный инференс
|
Еще более высокая плотность операций при меньшей точности
|
TF32: ускорение FP32-пайплайнов
Одна из ключевых особенностей A100 — поддержка формата TensorFloat-32, или TF32. Он был создан для ускорения задач, которые раньше выполнялись в FP32. TF32 сохраняет широкий диапазон значений FP32, но использует меньшую точность мантиссы. Для многих задач глубокого обучения такой компромисс приемлем, а выигрыш в скорости может быть значительным.
Практический смысл TF32 в том, что существующие модели и скрипты, рассчитанные на FP32, можно быстрее перенести на A100. Не всегда требуется сразу переписывать код под FP16 или BF16. Это снижает барьер перехода на GPU-ускорение: сначала можно получить прирост за счет TF32, а затем дополнительно оптимизировать код под mixed precision.
FP16 и BF16 для обучения моделей
FP16 и BF16 применяются в mixed precision training. Такой подход позволяет часть операций выполнять в 16-битных форматах, снижая объем передаваемых данных и повышая скорость вычислений. При этом критичные операции могут сохранять более высокую точность, чтобы обучение оставалось стабильным.
BF16 особенно интересен для обучения крупных моделей. Он имеет более широкий диапазон значений по сравнению с FP16, поэтому в ряде задач может быть удобнее и стабильнее. A100 поддерживает BF16 на Tensor Cores с той же пиковой производительностью, что и FP16, что делает ее подходящей для современных ML-нагрузок.
INT8 и INT4 для инференса
Для инференса важна не только точность, но и скорость обработки запросов. В production-среде часто требуется обслуживать тысячи или миллионы запросов, минимизировать задержку и снижать стоимость одного обращения к модели. Для этого применяются INT8 и INT4.
Квантование модели позволяет уменьшить точность представления весов и активаций, но сохранить приемлемое качество результата. A100 поддерживает INT8 и INT4 на Tensor Cores, поэтому хорошо подходит для высоконагруженного инференса: рекомендательных систем, классификации, поиска, обработки документов, компьютерного зрения и NLP-сервисов.
Пиковая производительность NVIDIA A100
Производительность A100 зависит от типа вычислений. В FP32 она составляет 19,5 TFLOPS, но при использовании Tensor Cores значения значительно выше. Например, для FP16 и BF16 Tensor Core производительность достигает 312 TFLOPS, а с использованием структурной разреженности — до 624 TFLOPS. Для INT8-инференса показатель достигает 624 TOPS и до 1 248 TOPS с разреженностью.
|
Тип вычислений
|
Производительность
|
Типичный сценарий
|
|
FP64
|
9,7 TFLOPS
|
HPC, инженерные расчеты
|
|
FP64 Tensor Core
|
19,5 TFLOPS
|
Ускоренные double precision workloads
|
|
FP32
|
19,5 TFLOPS
|
Универсальные вычисления
|
|
FP16
|
78 TFLOPS
|
Mixed precision workloads
|
|
BF16
|
39 TFLOPS
|
Обучение моделей с широким диапазоном значений
|
|
TF32 Tensor Core
|
156 / 312 TFLOPS
|
AI training на FP32-данных
|
|
FP16 Tensor Core
|
312 / 624 TFLOPS
|
Mixed precision training
|
|
BF16 Tensor Core
|
312 / 624 TFLOPS
|
Обучение крупных моделей
|
|
INT8 Tensor Core
|
624 / 1 248 TOPS
|
Инференс
|
|
INT4 Tensor Core
|
1 248 / 2 496 TOPS
|
Специализированный инференс
|
Эти показатели являются пиковыми. Реальная производительность зависит от конкретного приложения, размера модели, batch size, фреймворка, версии драйвера, CUDA-библиотек, скорости хранения данных и топологии сервера. Одна и та же A100 может показывать разные результаты в PyTorch, TensorFlow, TensorRT, RAPIDS или специализированном HPC-приложении.
Поэтому при выборе GPU-сервера важно смотреть не только на TFLOPS, но и на профиль нагрузки. Для обучения моделей критичны Tensor Cores, объем памяти и межсоединения между GPU. Для инференса — INT8/INT4, latency, TensorRT и возможность MIG. Для HPC — FP64, память, кэш и поддержка конкретного инженерного ПО.
Структурная разреженность
Что такое sparsity
A100 поддерживает структурную разреженность, или structured sparsity. В нейросетях многие веса могут быть нулевыми или близкими к нулю. Если модель подготовлена специальным образом, GPU может пропускать часть вычислений и выполнять операции эффективнее.
В A100 используется не произвольная, а структурированная разреженность. Это важно для аппаратного ускорения: GPU работает с определенным шаблоном и может заранее оптимизировать выполнение операций. В подходящих задачах это позволяет увеличить эффективную производительность Tensor Cores.
Где разреженность дает пользу
Наиболее заметный эффект sparsity может дать в инференсе. Если модель уже обучена и оптимизирована, разреженность помогает повысить throughput и снизить стоимость одного запроса. Это особенно важно для production-сервисов, где одна модель обрабатывает большой поток обращений.
Но разреженность не является универсальным ускорением для любой модели. Чтобы получить выгоду, модель нужно подготовить, а программный стек должен использовать соответствующие возможности A100. Если приложение не оптимизировано под sparsity, практический прирост может быть ниже пиковых значений.
Память HBM2 и HBM2e
Почему память важна не меньше TFLOPS
Для AI и HPC важна не только вычислительная мощность, но и скорость доступа к данным. Если GPU не успевает получать данные из памяти, вычислительные блоки простаивают. Поэтому A100 использует HBM-память с очень высокой пропускной способностью.
A100 выпускалась в версиях с 40 ГБ HBM2 и 80 ГБ HBM2e. Версия 80GB получила не только вдвое больший объем памяти, но и более высокую пропускную способность. Для больших моделей, крупных batch size, аналитики больших данных и memory-heavy HPC-задач это может быть решающим фактором.
|
Версия
|
Память
|
Пропускная способность памяти
|
TDP
|
Форм-фактор
|
|
A100 40GB PCIe
|
40 ГБ HBM2
|
1 555 ГБ/с
|
250 Вт
|
PCIe
|
|
A100 80GB PCIe
|
80 ГБ HBM2e
|
1 935 ГБ/с
|
300 Вт
|
PCIe
|
|
A100 40GB SXM
|
40 ГБ HBM2
|
1 555 ГБ/с
|
400 Вт
|
SXM
|
|
A100 80GB SXM
|
80 ГБ HBM2e
|
2 039 ГБ/с
|
400 Вт
|
SXM
|
40 ГБ или 80 ГБ
A100 40GB подходит для многих задач машинного обучения, инференса, HPC и аналитики, если рабочие данные помещаются в 40 ГБ памяти. Это может быть рациональный вариант для проектов, где важен баланс бюджета и производительности.
A100 80GB предпочтительнее, если используются крупные модели, большие батчи, тяжелые датасеты или несколько MIG-инстансов. Дополнительная память снижает риск нехватки VRAM и позволяет дольше масштабировать проект без замены оборудования.
|
Критерий
|
A100 40GB
|
A100 80GB
|
|
Объем памяти
|
40 ГБ
|
80 ГБ
|
|
Тип памяти
|
HBM2
|
HBM2e
|
|
Пропускная способность памяти
|
до 1 555 ГБ/с
|
до 2 039 ГБ/с
|
|
MIG-инстансы
|
до 7 × 5 ГБ
|
до 7 × 10 ГБ
|
|
Лучше подходит для
|
Средние модели, инференс, HPC, аналитика
|
Крупные модели, большие batch size, memory-heavy workloads
|
|
Риск нехватки GPU-памяти
|
Выше
|
Ниже
|
|
Стоимость конфигурации
|
Обычно ниже
|
Обычно выше
|
Кэш и подсистема памяти
A100 получила 40 МБ L2-кэша. Это значительно больше, чем у V100. Большой L2-кэш помогает удерживать часто используемые данные ближе к вычислительным блокам и уменьшать количество обращений к HBM-памяти. Для AI- и HPC-задач это важно, потому что производительность часто ограничена не только вычислениями, но и перемещением данных.
Кроме увеличенного L2-кэша, в Ampere улучшены механизмы работы с памятью: асинхронное копирование данных, управление кэшированием и сжатие данных. Для пользователя это выражается в более эффективной работе оптимизированных библиотек и приложений, особенно если нагрузка чувствительна к пропускной способности памяти.
|
Параметр
|
NVIDIA V100
|
NVIDIA A100
|
|
Архитектура
|
Volta
|
Ampere
|
|
Тип памяти
|
HBM2
|
HBM2 / HBM2e
|
|
Объем памяти
|
16 или 32 ГБ
|
40 или 80 ГБ
|
|
Максимальная пропускная способность памяти
|
до 900 ГБ/с у V100 SXM2
|
до 2 039 ГБ/с у A100 80GB SXM
|
|
L2-кэш
|
6 МБ
|
40 МБ
|
|
L1/shared memory на SM
|
до 128 КБ
|
до 192 КБ
|
Multi-Instance GPU
Что такое MIG
Multi-Instance GPU, или MIG, — одна из самых важных функций NVIDIA A100. Она позволяет разделить одну физическую GPU на несколько изолированных GPU-инстансов. Каждый инстанс получает выделенную часть вычислительных ресурсов, памяти и кэша.
Это не обычное программное распределение задач, при котором несколько процессов конкурируют за одну GPU. MIG обеспечивает аппаратную изоляцию ресурсов. Благодаря этому разные пользователи, контейнеры или сервисы могут работать на одной A100 более предсказуемо и независимо друг от друга.
На A100 40GB можно создать до 7 инстансов по 5 ГБ. На A100 80GB — до 7 инстансов по 10 ГБ. Это особенно полезно для инференса, разработки, тестирования, внутренних AI-платформ и облачных GPU-сервисов.
|
Сценарий
|
Без MIG
|
С MIG
|
|
Несколько небольших моделей
|
Конкурируют за одну GPU
|
Запускаются в отдельных GPU-инстансах
|
|
Командная ML-разработка
|
Один пользователь может занять весь ускоритель
|
Несколько пользователей получают выделенные доли GPU
|
|
Production-инференс
|
Сложнее обеспечить предсказуемую производительность
|
Проще разделить сервисы по изолированным профилям
|
|
Утилизация ресурсов
|
Часть GPU может простаивать
|
GPU используется плотнее
|
|
Изоляция задач
|
В основном программная
|
Аппаратно поддержанная
|
Когда MIG особенно полезен
MIG полезен, если на одном сервере нужно запускать несколько задач, каждая из которых не требует всей A100. Например, одна GPU может обслуживать несколько inference-сервисов: классификацию изображений, обработку документов, поиск похожих товаров, транскрибацию аудио или NLP-модели.
Без MIG такие сервисы конкурируют за ресурсы одной физической GPU. Один процесс может занять слишком много памяти или вычислений, влияя на остальные. MIG позволяет заранее задать профили и выделить каждой задаче собственный GPU-инстанс.
Ограничения MIG
MIG не всегда нужен. Если задача использует всю A100 целиком, например при обучении крупной модели, разделение GPU может быть невыгодным. В таких случаях лучше отдать приложению весь ускоритель.
Также важно учитывать, что изменение конфигурации MIG может требовать остановки нагрузок. Поэтому профили GPU-инстансов лучше планировать заранее: какие сервисы будут размещаться, сколько памяти им нужно, какие требования по задержке и как часто конфигурация будет меняться.
PCIe и SXM
A100 PCIe
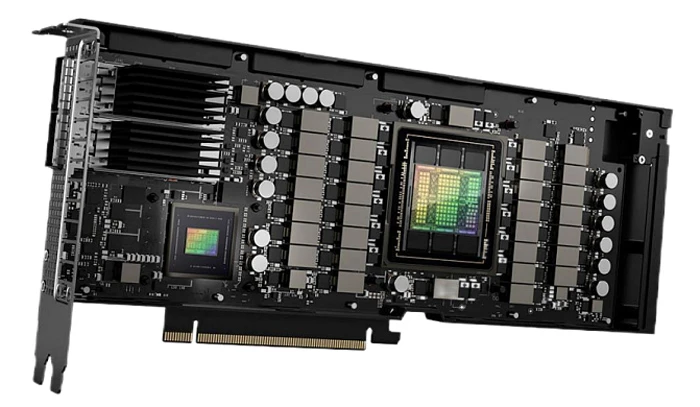
A100 PCIe — универсальная версия для серверов стандартной компоновки. Она устанавливается в PCIe Gen4-слоты и подходит для конфигураций с одной или несколькими GPU. Версия A100 80GB PCIe имеет TDP 300 Вт, а A100 40GB PCIe — 250 Вт.
Такой вариант подходит для компаний, которым нужен мощный GPU-сервер для обучения, инференса, аналитики или HPC, но не требуется максимальная плотность вычислений HGX/DGX-класса. A100 PCIe проще использовать в широком спектре серверных платформ, а конфигурации на ее основе обычно гибче по стоимости и составу.
A100 SXM
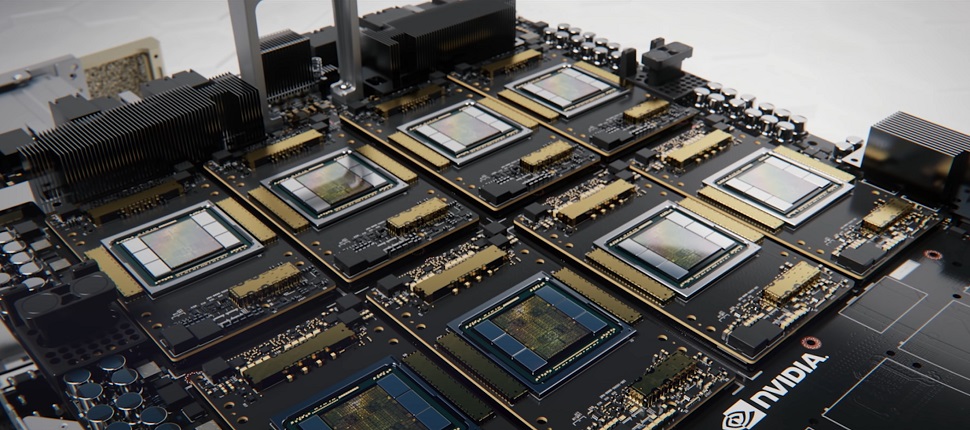
A100 SXM — модульная версия для высокоплотных GPU-платформ. Она используется в HGX и DGX-системах, поддерживает NVLink и NVSwitch и рассчитана на конфигурации с 4, 8 или 16 GPU. A100 80GB SXM имеет TDP 400 Вт и максимальную пропускную способность памяти среди версий A100 — 2 039 ГБ/с.
SXM-формат нужен там, где критично масштабирование между GPU: distributed training, крупные transformer-модели, HPC-кластеры, multi-GPU-инференс и задачи, где обмен между ускорителями становится важной частью производительности.
|
Параметр
|
A100 PCIe
|
A100 SXM
|
|
Тип установки
|
Стандартный PCIe-сервер
|
HGX / DGX-платформа
|
|
Типичные конфигурации
|
1–8 GPU
|
4, 8 или 16 GPU
|
|
TDP A100 80GB
|
300 Вт
|
400 Вт
|
|
Память A100 80GB
|
80 ГБ HBM2e
|
80 ГБ HBM2e
|
|
Пропускная способность памяти A100 80GB
|
1 935 ГБ/с
|
2 039 ГБ/с
|
|
GPU-to-GPU обмен
|
PCIe Gen4, NVLink Bridge для 2 GPU
|
NVLink / NVSwitch
|
|
Лучшие сценарии
|
Универсальные GPU-серверы, инференс, ML-разработка, аналитика
|
Масштабное обучение, HPC, multi-GPU-кластеры
|
NVLink и NVSwitch
A100 поддерживает NVLink третьего поколения. Это высокоскоростной интерфейс для обмена данными между GPU. В задачах, где одна модель или один расчет распределяется между несколькими ускорителями, скорость обмена между GPU может быть не менее важна, чем количество TFLOPS.
Для одиночных задач, которые полностью помещаются на одну GPU, NVLink может не играть решающей роли. Но при distributed training, model parallelism, pipeline parallelism, HPC-симуляциях и больших multi-GPU-нагрузках межсоединение между ускорителями напрямую влияет на масштабируемость.
NVSwitch используется в системах HGX/DGX и обеспечивает высокоскоростную связанность нескольких GPU внутри узла. Например, в 8-GPU-системах A100 ускорители могут обмениваться данными значительно эффективнее, чем через обычный PCIe-путь. Это помогает строить плотные вычислительные узлы для крупных AI- и HPC-задач.
|
Уровень масштабирования
|
Что важно
|
Где применяется
|
|
1 GPU
|
Объем памяти, локальное хранилище, загрузка данных
|
Fine-tuning, инференс, одиночные HPC-задачи, аналитика
|
|
2 GPU
|
PCIe-топология, NVLink Bridge, баланс CPU/GPU
|
Средние ML-задачи, несколько параллельных workloads
|
|
4 GPU
|
Охлаждение, питание, межсоединения, storage
|
Командная разработка, обучение моделей, inference-платформы
|
|
8 GPU
|
NVSwitch, высокоскоростная сеть, быстрый storage
|
Distributed training, HPC, крупные AI-платформы
|
|
Несколько серверов
|
InfiniBand или высокоскоростной Ethernet, NCCL, distributed storage
|
GPU-кластеры, обучение крупных моделей, научные расчеты
|
A100 для обучения нейросетей
Почему A100 подходит для training-задач
Обучение нейросетей требует высокой производительности матричных операций, большого объема GPU-памяти и эффективной работы с данными. A100 закрывает все три направления: Tensor Cores ускоряют вычисления, HBM-память обеспечивает высокую пропускную способность, а версии 80GB позволяют работать с крупными моделями и большими batch size.
A100 подходит для обучения моделей компьютерного зрения, NLP, рекомендательных систем, speech-to-text, transformer-архитектур, табличных ML-задач и мультимодальных моделей. Особенно заметна польза в проектах, где CPU-серверы уже не справляются по времени обучения, а модели требуют регулярных экспериментов и переобучения.
TF32 как быстрый старт
TF32 позволяет ускорять многие FP32 training-пайплайны без полного изменения кода. Это удобно, когда у компании уже есть модели, написанные под FP32, и нужно быстро перенести их на GPU-сервер. После первичной миграции можно дополнительно оптимизировать обучение с помощью Automatic Mixed Precision, FP16 или BF16.
80 ГБ памяти для крупных моделей
Для современных моделей объем GPU-памяти часто становится ограничением. Если модель, batch или датасет не помещаются в память, приходится уменьшать batch size, использовать gradient checkpointing, распределять модель между GPU или переносить часть данных в CPU-память. Все это усложняет обучение и может снижать производительность.
A100 80GB уменьшает этот риск. Она позволяет работать с более крупными моделями на одной GPU и эффективнее использовать multi-GPU-конфигурации. Поэтому версия 80GB особенно интересна для проектов, связанных с LLM, рекомендательными системами, компьютерным зрением высокого разрешения и большими обучающими выборками.
A100 для инференса
Высокая пропускная способность production-сервисов
Инференс — это запуск уже обученной модели для обработки реальных запросов. Здесь важны throughput, latency, стабильность и стоимость одного запроса. A100 подходит для инференса благодаря INT8/INT4 Tensor Cores, поддержке TensorRT и возможности разделения GPU через MIG.
Если модель оптимизирована и квантована, A100 может обслуживать большое количество запросов. Это полезно для сервисов классификации, рекомендаций, поиска, OCR, распознавания речи, обработки изображений, антифрода и NLP.
Размещение нескольких моделей на одной GPU
Не каждая модель требует всей A100. В production-среде часто есть несколько сервисов среднего размера, которым нужна GPU-акселерация, но не нужна целая физическая карта. MIG позволяет разместить такие сервисы на одной A100 и выделить каждому собственный инстанс.
Например, одна A100 80GB может быть разделена на несколько профилей по 10 ГБ. Это удобно для компаний, которые хотят повысить загрузку GPU и не покупать отдельный ускоритель под каждую небольшую модель.
|
Сценарий инференса
|
Что дает A100
|
|
Рекомендательные системы
|
Высокий throughput, поддержка INT8, работа с большими таблицами признаков
|
|
Компьютерное зрение
|
Ускорение CNN и vision transformer-моделей
|
|
NLP
|
Быстрая обработка запросов, возможность размещения нескольких моделей
|
|
Speech-to-text
|
Ускорение моделей распознавания речи и потоковой обработки
|
|
OCR и обработка документов
|
Параллельная обработка большого объема изображений и текстовых данных
|
|
Внутренние AI-сервисы
|
MIG, изоляция ресурсов, более высокая утилизация GPU
|
A100 для HPC и инженерных расчетов
A100 — это не только GPU для искусственного интеллекта. Она также подходит для высокопроизводительных вычислений, где важны FP64, пропускная способность памяти и масштабирование между GPU. Поддержка FP64 Tensor Core делает A100 особенно интересной для задач двойной точности.
К таким задачам относятся молекулярная динамика, квантовая химия, моделирование материалов, вычислительная гидродинамика, физические симуляции, энергетические расчеты, сейсмика, финансовое моделирование и другие инженерные workloads.
В HPC важно учитывать не только характеристики GPU, но и поддержку конкретного программного пакета. Одни приложения хорошо оптимизированы под CUDA и показывают значительный прирост, другие требуют настройки, специальных библиотек или лицензий. Поэтому для инженерных расчетов желательно тестировать производительность на реальных задачах, а не ориентироваться только на пиковые TFLOPS.
|
Параметр A100 для HPC
|
Почему важен
|
|
FP64
|
Нужен для расчетов, где требуется высокая численная точность
|
|
FP64 Tensor Core
|
Ускоряет часть double precision workloads
|
|
HBM-память
|
Помогает в задачах, чувствительных к пропускной способности памяти
|
|
80 ГБ памяти
|
Позволяет работать с более крупными сетками, матрицами и моделями
|
|
NVLink / NVSwitch
|
Повышает эффективность multi-GPU-расчетов
|
|
ECC
|
Повышает надежность вычислений при длительных расчетах
|
A100 для аналитики данных
A100 может использоваться для ускорения аналитики больших данных. GPU-ускоренные библиотеки позволяют переносить часть операций ETL, обработки таблиц, машинного обучения и подготовки данных с CPU на GPU. Это особенно полезно, когда компания регулярно обрабатывает большие объемы данных и хочет сократить время выполнения пайплайнов.
В таких сценариях важна не только GPU, но и вся система вокруг нее: процессоры, оперативная память, NVMe-хранилище, сеть и программный стек. Если данные медленно поступают в GPU, ускоритель будет простаивать. Поэтому для аналитики данных A100 лучше рассматривать как часть сбалансированной платформы, а не как отдельный компонент.
|
Задача аналитики
|
Как помогает A100
|
|
ETL-пайплайны
|
Ускоряет параллельную обработку больших объемов данных
|
|
Табличные данные
|
Позволяет использовать GPU-ускоренные dataframe-инструменты
|
|
ML на больших датасетах
|
Сокращает время подготовки и обучения моделей
|
|
NLP-аналитика
|
Ускоряет обработку текстов и embedding-моделей
|
|
Визуальная аналитика
|
Помогает обрабатывать изображения и видео в больших объемах
|
|
Подготовка данных для AI
|
Уменьшает время preprocessing перед обучением
|
Сравнение NVIDIA A100 и V100
NVIDIA V100 на архитектуре Volta была одним из самых популярных дата-центровых ускорителей предыдущего поколения. A100 развивает эту платформу и добавляет несколько принципиальных улучшений: больше памяти, более высокую пропускную способность, TF32, BF16, FP64 Tensor Core, MIG, увеличенный L2-кэш и более новые Tensor Cores.
|
Параметр
|
NVIDIA V100 SXM2
|
NVIDIA A100 40GB SXM
|
NVIDIA A100 80GB SXM
|
|
Архитектура
|
Volta
|
Ampere
|
Ampere
|
|
CUDA-ядер
|
5 120
|
6 912
|
6 912
|
|
Tensor Cores
|
640
|
432, третье поколение
|
432, третье поколение
|
|
Память
|
32 ГБ HBM2
|
40 ГБ HBM2
|
80 ГБ HBM2e
|
|
Пропускная способность памяти
|
900 ГБ/с
|
1 555 ГБ/с
|
2 039 ГБ/с
|
|
FP32
|
15,7 TFLOPS
|
19,5 TFLOPS
|
19,5 TFLOPS
|
|
FP64
|
7,8 TFLOPS
|
9,7 TFLOPS
|
9,7 TFLOPS
|
|
Tensor Performance
|
125 TFLOPS FP16 Tensor Core
|
312 TFLOPS FP16/BF16 Tensor Core
|
312 TFLOPS FP16/BF16 Tensor Core
|
|
TF32
|
Нет
|
Да
|
Да
|
|
BF16
|
Нет
|
Да
|
Да
|
|
FP64 Tensor Core
|
Нет
|
Да
|
Да
|
|
MIG
|
Нет
|
До 7 инстансов
|
До 7 инстансов
|
|
TDP
|
300 Вт
|
400 Вт
|
400 Вт
|
Если компания уже использует V100, переход на A100 дает наибольшую пользу в задачах, которые используют Tensor Cores, требуют большего объема памяти или выигрывают от MIG. Для классических FP32-задач прирост может быть умереннее, но для AI, mixed precision, инференса и memory-heavy workloads разница значительно заметнее.
Сравнение NVIDIA A100 и H100
H100 на архитектуре Hopper — более новое поколение дата-центровых GPU NVIDIA. Она получила четвертое поколение Tensor Cores, поддержку FP8, Transformer Engine, более высокую пропускную способность памяти и более быстрый NVLink. Поэтому для новых LLM-нагрузок и максимально производительного обучения H100 часто будет быстрее.
При этом A100 остается актуальной, если нужен зрелый и универсальный ускоритель для широкого набора задач: обучение, инференс, HPC, аналитика, MIG, поддержка существующего ПО и более доступные серверные конфигурации. Во многих проектах A100 может быть рациональным выбором по балансу стоимости, производительности и доступности.
|
Параметр
|
NVIDIA A100 80GB SXM
|
NVIDIA H100 SXM
|
|
Архитектура
|
Ampere
|
Hopper
|
|
Память
|
80 ГБ HBM2e
|
80 ГБ HBM3
|
|
Пропускная способность памяти
|
2 039 ГБ/с
|
3,35 ТБ/с
|
|
FP32
|
19,5 TFLOPS
|
67 TFLOPS
|
|
FP64 Tensor Core
|
19,5 TFLOPS
|
67 TFLOPS
|
|
TF32 Tensor Core
|
156 / 312 TFLOPS
|
989 TFLOPS
|
|
FP16/BF16 Tensor Core
|
312 / 624 TFLOPS
|
1 979 TFLOPS
|
|
FP8 Tensor Core
|
Нет
|
3 958 TFLOPS
|
|
INT8 Tensor Core
|
624 / 1 248 TOPS
|
3 958 TOPS
|
|
NVLink
|
600 ГБ/с
|
900 ГБ/с
|
|
MIG
|
До 7 инстансов
|
До 7 инстансов
|
|
TDP
|
400 Вт
|
до 700 Вт
|
A100 и H100 стоит сравнивать не абстрактно, а по конкретной задаче. Если приоритет — максимальная производительность в современных transformer- и LLM-нагрузках, H100 будет сильнее. Если нужен универсальный GPU-сервер для смешанных задач, A100 может оставаться более практичным вариантом.
Какие серверные конфигурации используют с A100
1×A100
Сервер с одной A100 подходит для пилотных проектов, fine-tuning, ML-разработки, инференса, аналитики и отдельных HPC-задач. Версия 80GB особенно полезна, если модель или датасет требуют большого объема памяти.
2–4×A100
Конфигурации с 2–4 GPU подходят для командной разработки, нескольких параллельных проектов, production-инференса и обучения моделей среднего масштаба. Здесь важно заранее понимать, будут ли GPU работать независимо или в связке. Если задачи независимые, PCIe-конфигурации часто достаточны. Если нужен активный обмен между GPU, стоит учитывать NVLink и топологию сервера.
8×A100
Системы с 8 A100 используются для распределенного обучения, HPC и крупных AI-платформ. В таких конфигурациях важны NVSwitch, сеть, storage, питание, охлаждение и мониторинг. Это уже не просто сервер с несколькими GPU, а полноценный вычислительный узел для тяжелых нагрузок.
|
Конфигурация
|
Типовые задачи
|
На что обратить внимание
|
|
1×A100 40GB
|
ML-разработка, инференс, HPC-пилоты, аналитика
|
Баланс CPU, RAM, NVMe и охлаждения
|
|
1×A100 80GB
|
Fine-tuning, крупные модели, memory-heavy workloads
|
Объем датасетов, скорость storage, системная память
|
|
2–4×A100 PCIe
|
Командная разработка, несколько сервисов, обучение средних моделей
|
PCIe-топология, питание, airflow, CPU feeding
|
|
4×A100 SXM/HGX
|
Multi-GPU training, HPC, крупная аналитика
|
NVLink, охлаждение, сеть, storage
|
|
8×A100 HGX/DGX
|
Distributed training, AI-платформа, HPC-кластер
|
NVSwitch, InfiniBand, мониторинг, MLOps
|
|
A100 с MIG
|
Multi-tenant inference, внутренняя GPU-платформа
|
Профили MIG, Kubernetes, изоляция нагрузок
|
На что обратить внимание перед выбором сервера с A100
Питание и охлаждение
A100 — мощный и энергоемкий ускоритель. В зависимости от версии TDP составляет от 250 до 400 Вт. В сервере с несколькими GPU суммарное энергопотребление и тепловыделение быстро растут, поэтому нужно заранее учитывать возможности стойки, блоков питания, системы охлаждения и помещения.
Особенно важно не путать серверные GPU с потребительскими картами. A100 PCIe обычно использует пассивное охлаждение и рассчитана на поток воздуха внутри серверного шасси. Установка такой карты в неподходящий корпус может привести к перегреву, снижению частот и нестабильной работе.
CPU и оперативная память
GPU не работает в вакууме. Процессор готовит данные, обслуживает dataloader, выполняет preprocessing, управляет сетью и хранилищем. Если CPU слишком слабый, A100 может простаивать. То же относится к оперативной памяти: для больших датасетов, кеширования и аналитики нужен достаточный объем RAM.
Для training-серверов обычно важны быстрые CPU, достаточное количество PCIe-линий, большой объем RAM и быстрые NVMe-накопители. Для инференса важны latency, сеть, стабильность и возможность масштабировать сервисы. Для HPC — баланс CPU/GPU, поддержка нужных библиотек и скорость обмена данными.
Хранилище
Если данные медленно загружаются с дисков или сетевого хранилища, GPU не сможет работать на полную мощность. Для обучения моделей и аналитики часто нужны NVMe SSD, быстрые файловые системы, кеширование датасетов и продуманная структура хранения.
В проектах с несколькими GPU скорость storage становится особенно важной. Чем больше ускорителей в сервере, тем выше требования к подаче данных. Иначе дорогие GPU будут простаивать, ожидая загрузки очередного batch.
Сеть
Для одиночного сервера сеть может быть важна для доступа к данным, API-запросов и взаимодействия с другими сервисами. Для кластера сеть становится критическим компонентом вычислительной платформы. Distributed training и HPC-задачи могут требовать низких задержек и высокой пропускной способности.
В крупных GPU-кластерах часто рассматривают InfiniBand или высокоскоростной Ethernet. Выбор зависит от задач, масштаба, бюджета и требований к задержкам.
|
Компонент сервера
|
Почему важен для A100
|
|
CPU
|
Готовит данные, обслуживает dataloader, управляет вводом-выводом
|
|
RAM
|
Нужна для кеширования датасетов и preprocessing
|
|
NVMe
|
Ускоряет загрузку данных и уменьшает простои GPU
|
|
Сеть
|
Важна для распределенного обучения, доступа к данным и API-сервисов
|
|
Охлаждение
|
Предотвращает throttling и нестабильность под нагрузкой
|
|
Блоки питания
|
Обеспечивают стабильную работу нескольких энергоемких GPU
|
|
PCIe-топология
|
Влияет на обмен данными между CPU, GPU и устройствами хранения
|
Программная экосистема
A100 раскрывает свой потенциал через программную экосистему NVIDIA: CUDA, cuDNN, cuBLAS, NCCL, TensorRT, RAPIDS, NVIDIA HPC SDK, контейнеры NGC и оптимизированные ML-фреймворки. Без актуальных драйверов, библиотек и правильно настроенного окружения GPU может работать значительно ниже своих возможностей.
Для обучения моделей чаще всего используются PyTorch и TensorFlow с поддержкой CUDA и mixed precision. Для инференса — TensorRT и оптимизированные runtime-среды. Для аналитики — RAPIDS и GPU-ускоренные dataframe-инструменты. Для HPC — CUDA-библиотеки, специализированные пакеты и компиляторы.
В production-среде удобен контейнерный подход. Окружение фиксируется в контейнере, а GPU-ресурсы выделяются через Kubernetes и NVIDIA GPU Operator. Это упрощает обновления, снижает риск конфликтов зависимостей и помогает масштабировать нагрузки между серверами.
|
Программный компонент
|
Для чего используется
|
|
CUDA
|
Базовая платформа GPU-вычислений NVIDIA
|
|
cuDNN
|
Ускорение deep learning-операций
|
|
cuBLAS
|
Линейная алгебра и матричные операции
|
|
NCCL
|
Коммуникации между GPU в multi-GPU и multi-node-сценариях
|
|
TensorRT
|
Оптимизация и запуск инференса
|
|
RAPIDS
|
GPU-ускоренная аналитика данных
|
|
NVIDIA HPC SDK
|
Инструменты для научных и инженерных вычислений
|
|
NVIDIA GPU Operator
|
Управление GPU в Kubernetes-средах
|
Преимущества NVIDIA A100
A100 сочетает высокую производительность, большой объем HBM-памяти, поддержку разных форматов вычислений и зрелую программную экосистему. Она подходит для широкого набора задач и может использоваться как в одиночных GPU-серверах, так и в multi-GPU-кластерах.
|
Преимущество
|
Что это дает на практике
|
|
80 ГБ HBM2e
|
Работа с крупными моделями, большими batch size и memory-heavy задачами
|
|
Tensor Cores третьего поколения
|
Высокая производительность AI training и inference
|
|
TF32
|
Ускорение FP32-пайплайнов без глубокой переработки кода
|
|
BF16 и FP16
|
Эффективное обучение моделей в mixed precision
|
|
INT8 и INT4
|
Высокопроизводительный инференс и снижение стоимости одного запроса
|
|
FP64 Tensor Core
|
Ускорение части HPC-задач двойной точности
|
|
MIG
|
Разделение одной GPU на несколько изолированных инстансов
|
|
NVLink / NVSwitch
|
Масштабирование в multi-GPU-системах
|
|
ECC и серверная надежность
|
Подходит для длительных вычислений и production-нагрузок
|
Ограничения NVIDIA A100
A100 остается мощной GPU, но она уже не относится к самому новому поколению. Для задач, ориентированных на максимальную производительность LLM, новые H100, H200 и последующие платформы могут быть эффективнее. Особенно это касается workloads, которые выигрывают от FP8, Transformer Engine и более высокой пропускной способности памяти.
Второе ограничение — зависимость от оптимизации. A100 показывает максимальную отдачу, когда workload использует Tensor Cores, mixed precision, TensorRT, NCCL, RAPIDS или оптимизированные HPC-библиотеки. Если приложение плохо распараллелено или не умеет эффективно работать с GPU, фактический прирост может быть ниже ожиданий.
Третье ограничение — инфраструктурные требования. Несколько A100 требуют качественного сервера, питания, охлаждения, storage, сети и администрирования. Поэтому при планировании проекта нужно учитывать не только цену GPU, но и стоимость всей платформы.
|
Ограничение
|
Что это значит
|
Как снизить риск
|
|
A100 не самое новое поколение
|
Для отдельных LLM-задач H100/H200 могут быть быстрее
|
Сравнить GPU на реальном workload
|
|
Нужна оптимизация ПО
|
Пиковые TFLOPS не гарантируют такой же прирост в приложении
|
Использовать CUDA-библиотеки, TensorRT, mixed precision, профилирование
|
|
Высокое энергопотребление
|
Сервер требует правильного питания и охлаждения
|
Подбирать серверную платформу под конкретное число GPU
|
|
Storage может стать узким местом
|
GPU простаивает, если данные подаются медленно
|
Использовать быстрые NVMe, кеширование, корректную архитектуру хранения
|
|
Multi-GPU требует быстрой сети
|
Масштабирование может упереться в обмен данными
|
Использовать NVLink/NVSwitch внутри узла и быструю сеть между узлами
|
Для каких задач стоит выбирать A100
A100 стоит рассматривать, если компании нужен мощный и универсальный серверный ускоритель для AI, HPC или аналитики. Она особенно хорошо подходит для проектов, где важны большой объем GPU-памяти, поддержка mixed precision, высокая пропускная способность, MIG и зрелая программная экосистема.
|
Задача
|
Почему подходит A100
|
|
Обучение нейросетей
|
Tensor Cores, TF32, FP16/BF16, высокая пропускная способность памяти
|
|
Fine-tuning моделей
|
80 ГБ памяти позволяют работать с более крупными моделями
|
|
Production-инференс
|
INT8/INT4, TensorRT, MIG, высокая плотность размещения сервисов
|
|
HPC
|
FP64, FP64 Tensor Core, HBM-память, ECC
|
|
Аналитика больших данных
|
HBM-память, RAPIDS, параллельная обработка данных
|
|
Внутренняя GPU-платформа
|
MIG, Kubernetes, контейнеризация, разделение ресурсов между командами
|
|
Смешанные нагрузки
|
Одна GPU подходит для обучения, инференса, HPC и аналитики
|
Когда лучше рассмотреть другие GPU
A100 не всегда будет оптимальным выбором. Если задача связана с самым современным обучением LLM и бюджет позволяет использовать более новые ускорители, стоит сравнить A100 с H100, H200 или другими актуальными дата-центровыми GPU. Если же нагрузка небольшая и не требует 40–80 ГБ HBM-памяти, может быть достаточно менее дорогих ускорителей.
Для инференса компактных моделей иногда выгоднее использовать GPU меньшего класса, особенно если важна стоимость одного сервера. Для тяжелых LLM-нагрузок, наоборот, может быть оправдан переход на Hopper или более новые архитектуры. Поэтому выбор GPU должен опираться на размер моделей, требования к памяти, целевую задержку, количество пользователей, бюджет и сроки окупаемости.
Итог
NVIDIA A100 — это мощный серверный ускоритель для искусственного интеллекта, высокопроизводительных вычислений и аналитики данных. Она объединяет тензорные ядра третьего поколения, 40 или 80 ГБ HBM-памяти, поддержку TF32, FP16, BF16, INT8, FP64 Tensor Core, Multi-Instance GPU и масштабирование через NVLink.
Для компаний A100 интересна прежде всего как универсальная платформа. Она подходит для обучения моделей, инференса, инженерных расчетов, аналитики и построения внутренних GPU-сервисов. Версия A100 80GB особенно полезна в задачах, где важен большой объем памяти и возможность разделить GPU на несколько изолированных инстансов.
A100 уже не является самым новым ускорителем NVIDIA, но остается зрелым и практичным решением для широкого круга задач. Если проекту нужна надежная серверная GPU с высокой производительностью, большой памятью, поддержкой корпоративного ПО и понятными сценариями масштабирования, NVIDIA A100 по-прежнему заслуживает внимания.










Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!