Корпоративный проект с искусственным интеллектом часто начинается с небольшой команды и вполне конкретной задачи: ускорить поиск по технической документации, помочь разработчикам работать с внутренним кодом, автоматизировать подготовку материалов или проверить новую аналитическую модель. На этом этапе компании важно быстро перейти от идеи к измеримому результату. Для этого нужны доступные вычислительные ресурсы, возможность работать со своими данными и среда, в которой эксперименты можно повторять без длительной подготовки инфраструктуры.
При выборе оборудования приходится учитывать сразу несколько ограничений. Облачные ресурсы удобны для нерегулярных тяжелых расчетов, но требуют контроля расходов и порядка передачи данных. Универсальная рабочая станция может нуждаться в дополнительной настройке ускорителей и программных зависимостей. Отдельный сервер оправдан при более высокой загрузке и требованиях к обслуживанию нескольких пользователей. Решение зависит от характера работы команды, размера моделей и того, насколько быстро должны возвращаться результаты.
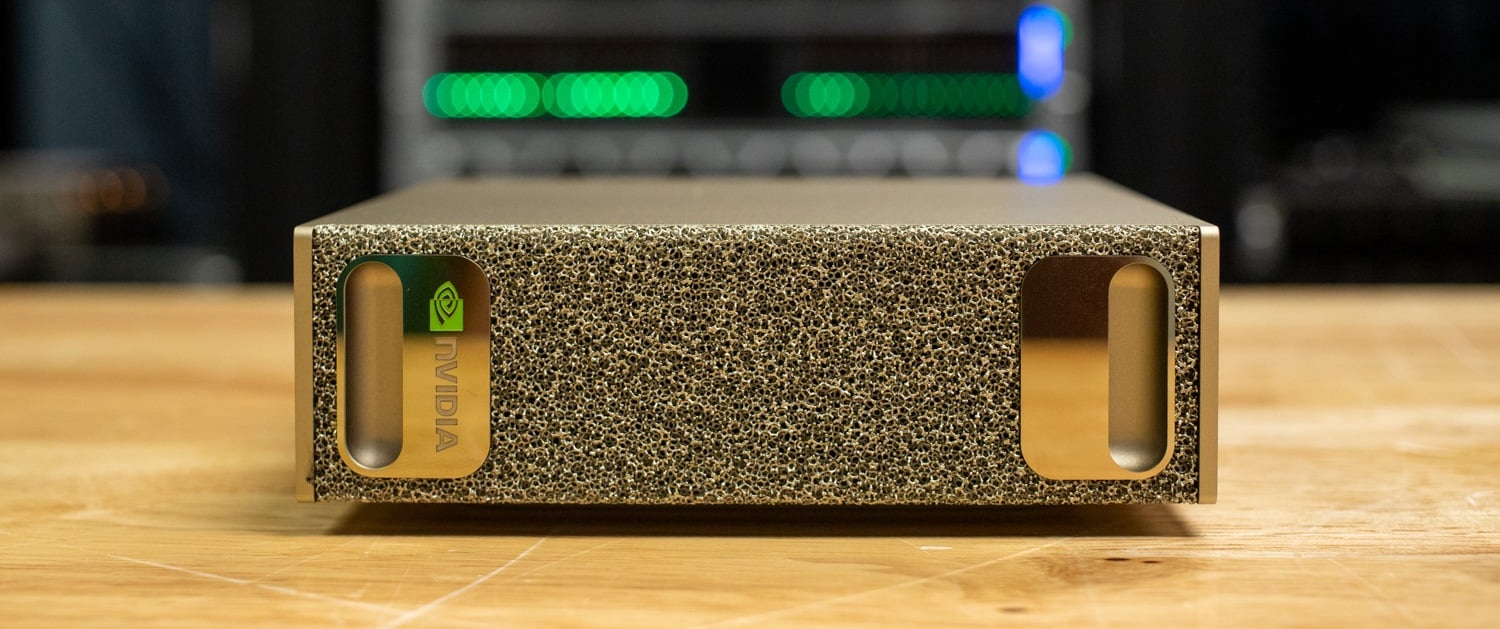
NVIDIA DGX Spark занимает место компактного локального вычислительного узла для разработки и выполнения моделей. В рассматриваемой конфигурации он объединяет процессор Arm, графический ускоритель Blackwell и 128 Гбайт общей памяти. Устройство можно поставить рядом с рабочим местом, подключить к корпоративной сети и использовать с ноутбука или настольного компьютера. Для бизнеса это способ выделить команде собственную среду экспериментов с программной экосистемой NVIDIA.
Главная ценность такой системы проявляется в рабочем процессе: как быстро загружается нужная модель, сколько времени занимает обработка документа, насколько удобно проводить дообучение и может ли несколько задач выполняться без постоянной перестройки окружения. Поэтому мы рассматриваем DGX Spark через прикладные сценарии, устройство платформы и результаты испытаний, а затем разбираем, что изменилось после программных обновлений, представленных на CES 2026.
Основной предмет обзора — DGX Spark с 128 Гбайт памяти. Измерения начального программного стека относятся к октябрю 2025 года, а данные об ускорении после обновлений — к отдельным демонстрациям и испытаниям NVIDIA в январе 2026 года. Их условия различаются - при выборе системы важна проверка именно своей модели, формата весов и режима нагрузки.
Какие задачи бизнеса решает локальная ИИ-система
Собственная среда для пилотных проектов
Для пилота обычно нужно сравнить несколько моделей, подготовить данные, настроить запросы и проверить качество ответов на реальных примерах. Доступный команде локальный узел позволяет выполнять эти действия последовательно и сохранять рабочие окружения между экспериментами. Особенно это полезно, когда сотрудники регулярно возвращаются к одним и тем же моделям и наборам данных: сокращается число повторных загрузок и подготовительных операций.
Практическую цель пилота стоит определить до закупки оборудования. Например, для помощника службы поддержки это может быть время подготовки ответа с корректной ссылкой на внутреннюю инструкцию. Для разработчиков — доля полезных изменений кода и время проверки предложенного решения. Для аналитиков — продолжительность подготовки признаков или повторного обучения модели. Эти показатели дают основу для оценки эффекта от инфраструктуры.
|
Сценарий
|
Роль локального узла
|
Что измерить
|
|
Помощник по внутренним документам
|
Подготовка векторного индекса и генерация ответов по найденным материалам
|
Качество ссылок, время ответа, работа с длинным контекстом
|
|
Помощник разработчика
|
Локальная модель для объяснения и изменения кода
|
Полезность правок, задержки, одновременная работа нескольких задач
|
|
Адаптация модели
|
Дообучение на подготовленных примерах компании
|
Качество после обучения, память и время выполнения
|
|
Аналитика данных
|
Ускорение поддерживаемых преобразований и алгоритмов
|
Срок подготовки данных и получения конечного результата
|
|
Изображения и видео
|
Отдельный вычислитель для генеративной последовательности
|
Время всей последовательности, качество и итоговое разрешение
|
|
Лаборатория робототехники
|
Выполнение моделей восприятия, общения и планирования
|
Задержки, устойчивость, совместимость с физическим устройством
|
Работа с внутренними документами и исходным кодом
Локальное выполнение модели помогает организовать обработку документов, технических материалов и программного кода в выбранном компанией контуре. На одной системе можно проверять помощника с поиском по внутренней базе знаний, создавать векторные представления документов и выполнять генерацию ответов. При этом объем поискового индекса, исходных файлов и промежуточных данных учитывают вместе с ресурсами самой языковой модели.
Для действительно локального процесса необходимо проверить весь маршрут данных: используемые модели, расширения среды разработки, внешние службы распознавания и поиска, журналы запросов и подключенные инструменты. Размещение модели на собственном устройстве дает контроль над вычислительной частью, а правила доступа и передачи информации задаются архитектурой приложения. Это особенно важно для помощников, способных самостоятельно обращаться к другим системам.
Вычислительный узел рядом с привычным рабочим местом
Разработчик или дизайнер может продолжать работать на своем компьютере, а ресурсоемкие операции выполнять на Spark. Такой вариант позволяет сохранить привычные инструменты и одновременно выделить отдельную систему для генерации, подготовки данных или экспериментов. Команда получает постоянное локальное окружение, которое можно подключать к существующим рабочим процессам через сеть.
Для небольшого отдела полезна и стандартизация: одинаковые версии контейнеров, воспроизводимые настройки и единый порядок обновлений. Это упрощает передачу проекта между сотрудниками. Однако при совместной работе потребуется организовать очереди заданий и распределение ресурсов: несколько независимо запущенных моделей используют один общий объем памяти и один графический ускоритель.
Архитектура и характеристики DGX Spark
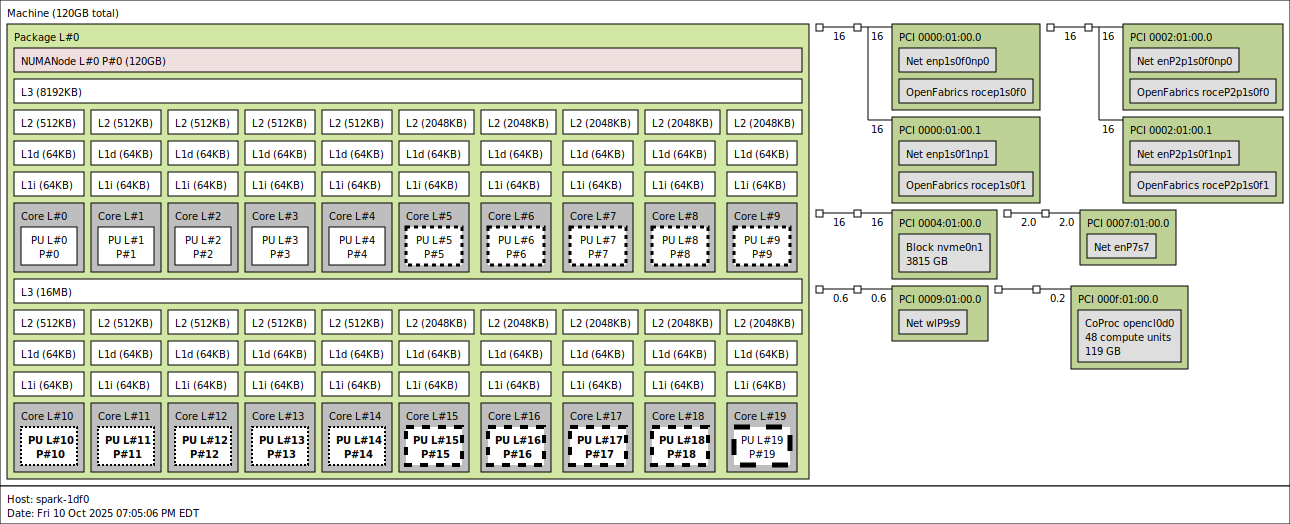
Основу системы составляет NVIDIA GB10 Grace Blackwell Superchip. Он объединяет 20-ядерный процессор Arm и графическую часть Blackwell, связанные NVLink-C2C. Процессорная часть включает десять Cortex-X925 и десять Cortex-A725. Для нейросетевых вычислений используются тензорные ядра пятого поколения; также предусмотрены ядра трассировки лучей четвертого поколения и аппаратные блоки кодирования и декодирования видео.
|
Подсистема
|
Параметр
|
Характеристика
|
|
Архитектура
|
Вычислительная платформа
|
NVIDIA GB10 Grace Blackwell Superchip
|
|
Архитектура
|
Графическая часть
|
NVIDIA Blackwell
|
|
Архитектура
|
Центральный процессор
|
20 ядер Arm: 10 Cortex-X925 и 10 Cortex-A725
|
|
Архитектура
|
Тензорные ядра
|
Пятое поколение
|
|
Архитектура
|
Ядра трассировки лучей
|
Четвертое поколение
|
|
Архитектура
|
NVENC / NVDEC
|
Один блок кодирования / один блок декодирования
|
|
Память
|
Объем и тип
|
128 Гбайт LPDDR5X, общий ресурс процессора и графической части
|
|
Память
|
Интерфейс
|
256 бит
|
|
Память
|
Пропускная способность
|
273 Гбайт/с
|
|
Вычисления
|
Пиковый показатель FP4
|
До 1 петафлопса при использовании разреженности
|
|
Хранение
|
Накопитель
|
NVMe M.2, варианты 1 или 4 Тбайт с самошифрованием; в испытанном образце — 4 Тбайт
|
|
Подключения
|
USB-C
|
4 разъема, один используется для питания; порты данных USB 3.2 Gen 2×2 — до 20 Гбит/с
|
|
Подключения
|
Обычная проводная сеть
|
1 × RJ-45, 10 Гбит/с
|
|
Подключения
|
Высокоскоростная сеть
|
NVIDIA ConnectX-7, класс подключения 200 Гбит/с, два внешних QSFP-разъема
|
|
Подключения
|
Беспроводные интерфейсы
|
Wi-Fi 7; Bluetooth 5.4 по актуальной спецификации NVIDIA
|
|
Подключения
|
Звук
|
Многоканальное аудио через HDMI
|
|
Подключения
|
Видеовыходы
|
HDMI 2.1a; поддерживаемые USB-C также могут использовать DisplayPort Alt Mode
|
|
Корпус
|
Размеры
|
150 × 150 × 50,5 мм
|
|
Корпус
|
Масса
|
Около 1,2 кг
|
|
Питание
|
Комплектный блок питания
|
Внешний, 240 Вт
|
|
Питание
|
Тепловой пакет GB10
|
140 Вт
|
|
Программная платформа
|
Операционная система
|
NVIDIA DGX OS на основе Ubuntu
|
В таблице 240 Вт обозначают номинальную мощность комплектного блока питания, а 140 Вт — тепловой пакет GB10. Фактическую потребляемую мощность всей системы определяют по измерениям под выбранной нагрузкой. Указание «до 1 петафлопса» — это пиковый показатель для специальных вычислений FP4 и не характеризует скорость реальных приложений.
Как понимать заявленную вычислительную производительность
Формат чисел определяет, сколько памяти занимают веса и какие вычислительные блоки могут использоваться. BF16 представляет каждое число 16 битами, FP8 — восемью, а четырехбитные форматы дополнительно сокращают объем данных. При этом реальное хранение включает коэффициенты масштабирования и другие служебные данные, а отдельные части модели могут сохранять более высокую точность.
Заявленная производительность FP4 — специальный пиковый показатель. Для его достижения нужны соответствующие операции, формат данных и структура вычислений. Скорость ответа языковой модели зависит также от пропускной способности памяти, длины входа и выхода, реализации вычислительных ядер и числа одновременно обслуживаемых запросов. Поэтому этот показатель полезен для описания класса платформы, а прикладную скорость оценивают отдельными тестами.
Общая память: вместимость и пропускная способность
128 Гбайт LPDDR5X используются процессором и графической частью как общий физический ресурс. Для разработчика это возможность работать с моделями и данными, которые занимают большой объем памяти. Вместе с тем операционная система, приложения, временные буферы и кэш контекста также расходуют этот ресурс. Полный номинальный объем нельзя заранее считать свободным местом исключительно для весов модели.
Здесь важно различать вместимость и скорость перемещения данных. Пропускная способность памяти DGX Spark составляет 273 Гбайт/с. Большая модель может помещаться в памяти, но это еще не определяет комфортную скорость последовательной генерации. Для многократного чтения весов и работы с растущим контекстом доступная полоса памяти становится существенным ограничением.
Первую оценку объема весов можно получить умножением числа параметров на число байтов в выбранном представлении. Ниже приведен только такой расчет для условных моделей с равномерным форматом хранения всех весов. Он не учитывает кэш, промежуточные активации, память среды выполнения и особенности конкретной квантизации.
|
Число параметров
|
BF16, 2 байта
|
FP8, 1 байт
|
FP4, 0,5 байта
|
|
8 млрд
|
16 Гбайт
|
8 Гбайт
|
4 Гбайт
|
|
30 млрд
|
60 Гбайт
|
30 Гбайт
|
15 Гбайт
|
|
70 млрд
|
140 Гбайт
|
70 Гбайт
|
35 Гбайт
|
|
120 млрд
|
240 Гбайт
|
120 Гбайт
|
60 Гбайт
|
|
200 млрд
|
400 Гбайт
|
200 Гбайт
|
100 Гбайт
|
Например, 200 млрд параметров в идеальном четырехбитном представлении соответствуют примерно 100 Гбайт только весов. Именно поэтому заявления о запуске моделей такого размера требуют уточнения формата и режима работы. Длинный контекст, несколько параллельных запросов или дополнительные компоненты приложения увеличивают потребность в памяти. Приемку конфигурации следует проводить на полном рабочем процессе. Приведённые значения не подтверждают возможность запуска любой модели соответствующего размера на DGX Spark. Для практического применения требуется проверить конкретную модель, формат весов, реализацию инференса и доступный объём памяти.
Корпус, охлаждение и внутреннее устройство
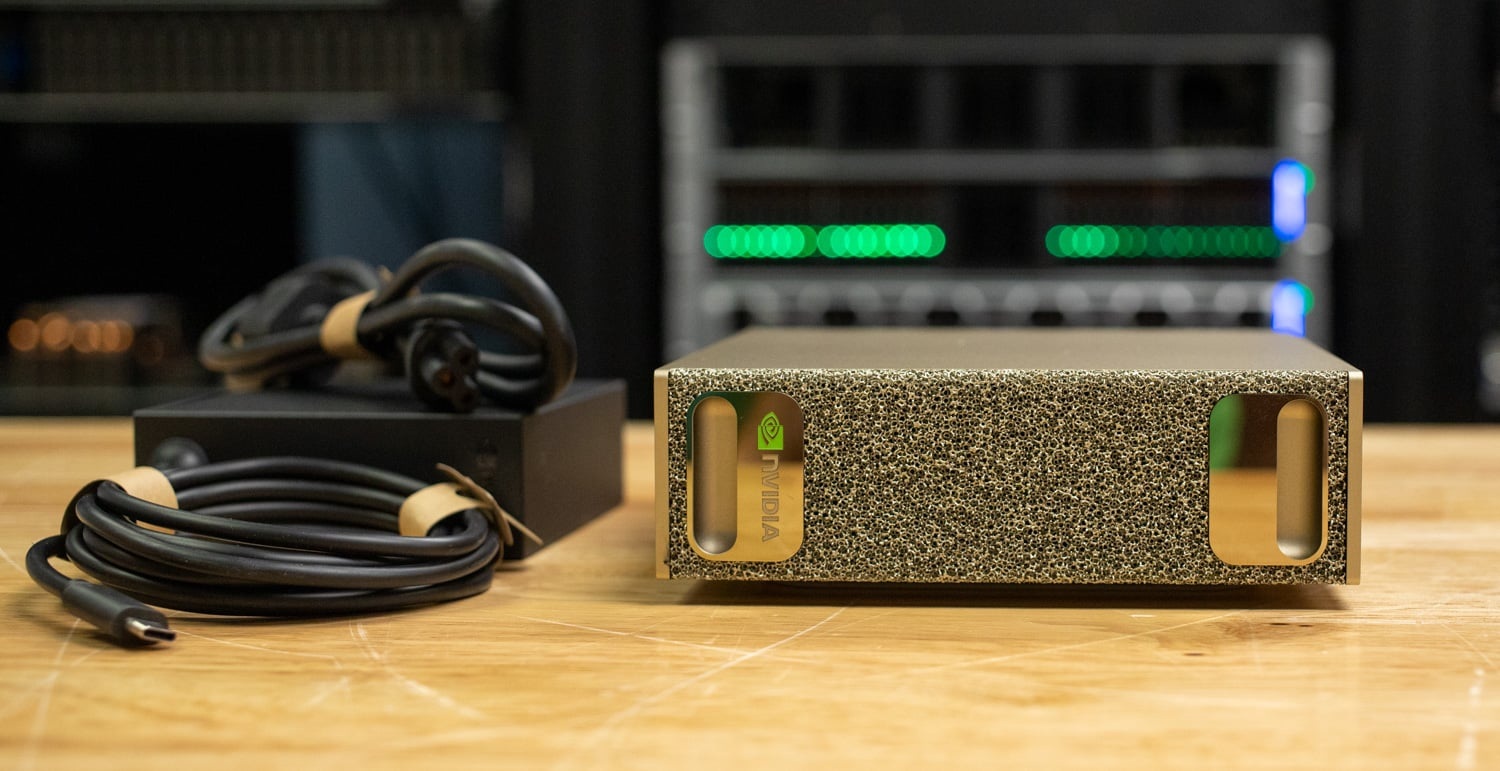
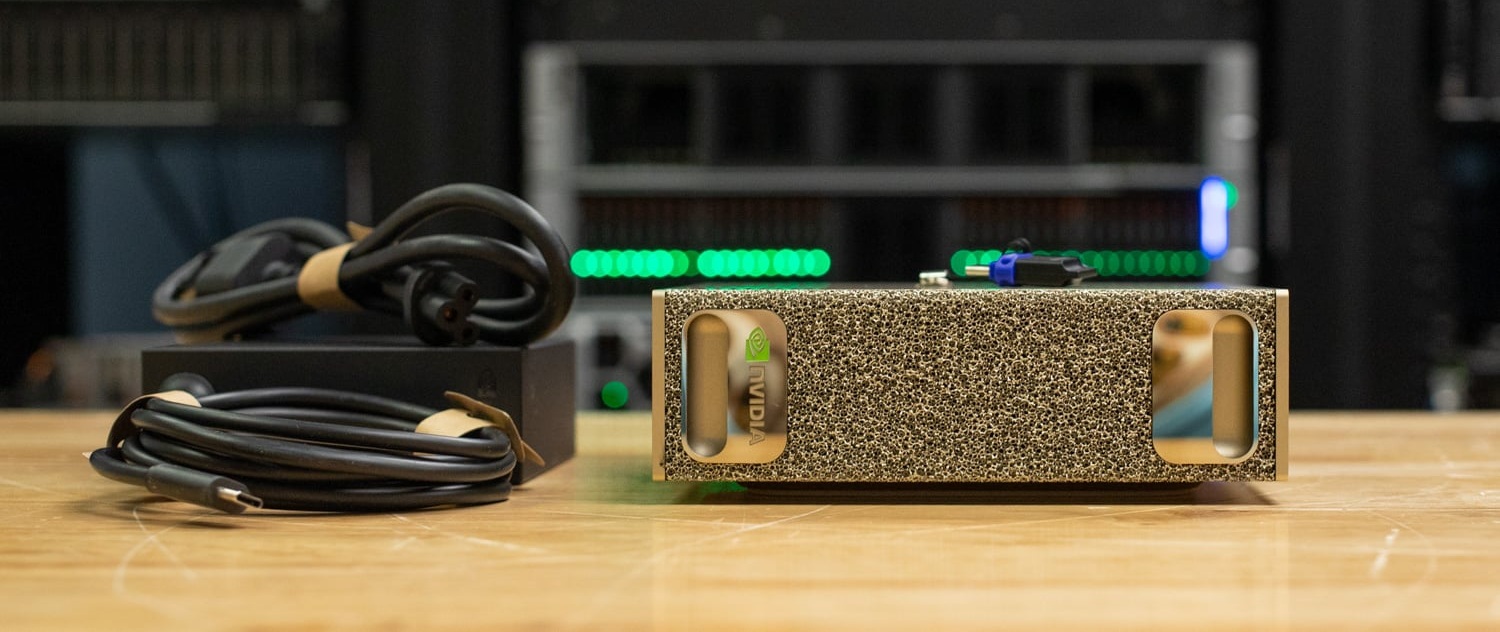
DGX Spark имеет размеры 150 × 150 × 50,5 мм и массу около 1,2 кг. Корпус выполнен в характерном для семейства DGX оформлении с металлической поверхностью золотистого оттенка. По занимаемому месту устройство сопоставимо с компактным настольным компьютером. Внешний блок питания освобождает внутреннее пространство корпуса, но его размещение тоже нужно учитывать при организации рабочего места.
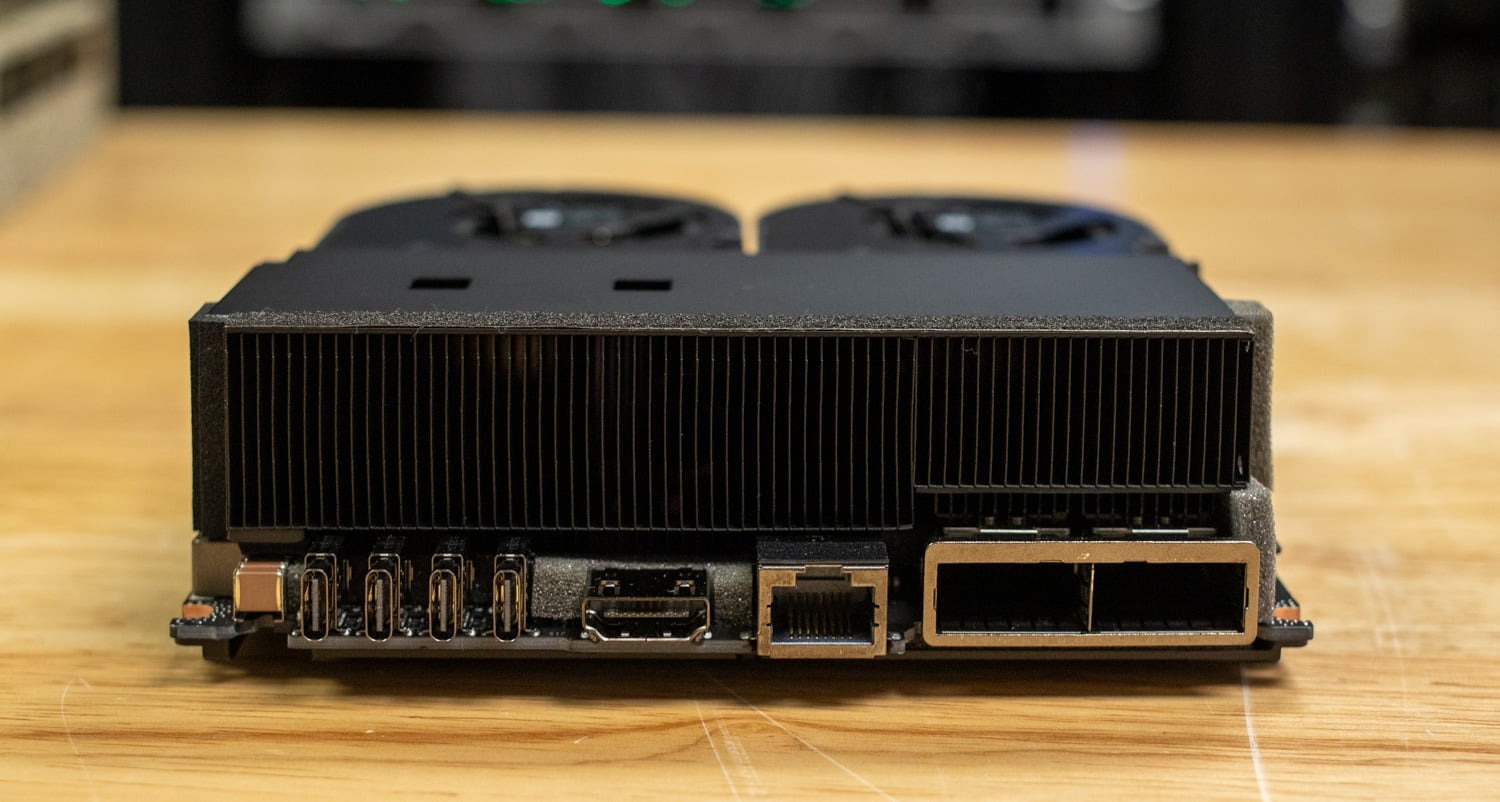
Внутри используется активное охлаждение с радиатором и вентиляторами. Компактность системы делает особенно важными свободный доступ воздуха и устойчивый температурный режим. Для размещения в кабинете или лаборатории стоит заранее оценить шум под длительной нагрузкой и убедиться, что воздухозаборники не перекрываются соседними устройствами.
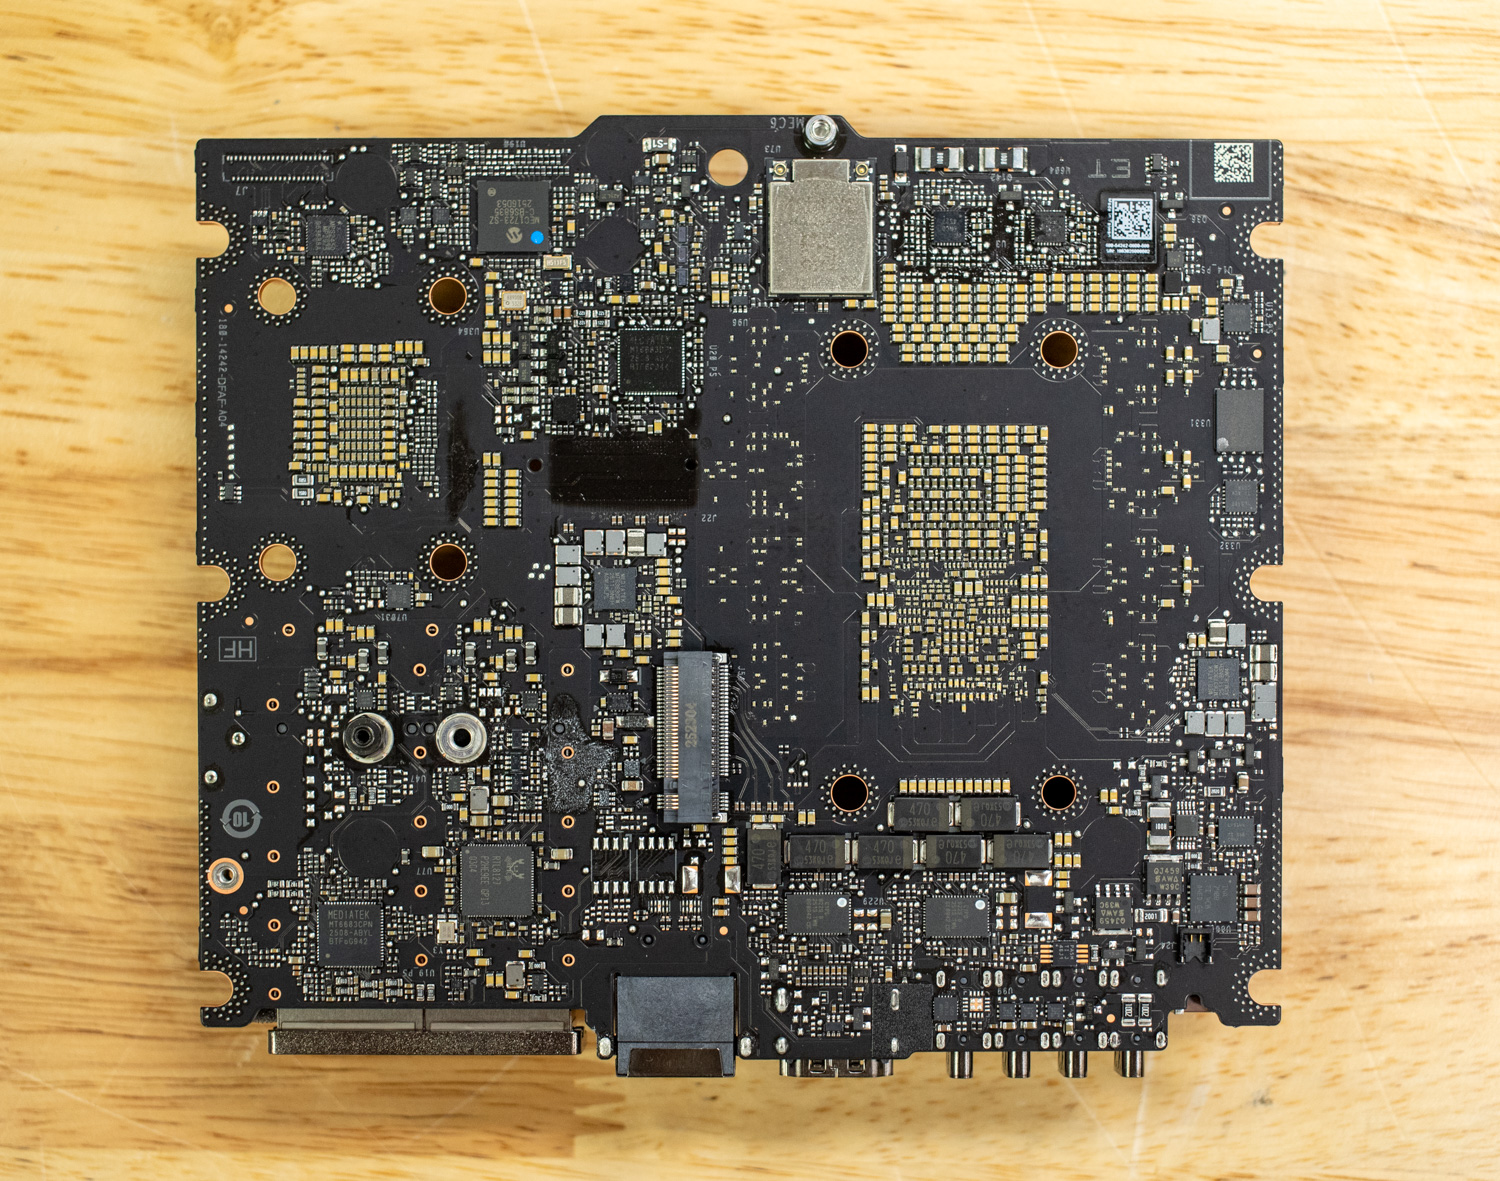
Фотографии разборки показывают плотную компоновку: GB10, распаянные микросхемы памяти, сетевой контроллер и компактный твердотельный накопитель. Память LPDDR5X не выполнена в виде сменных модулей. Поэтому ее объем выбирают вместе с аппаратной конфигурацией, а возможность дальнейшего расширения за счет обычной замены оперативной памяти в проект не закладывают.
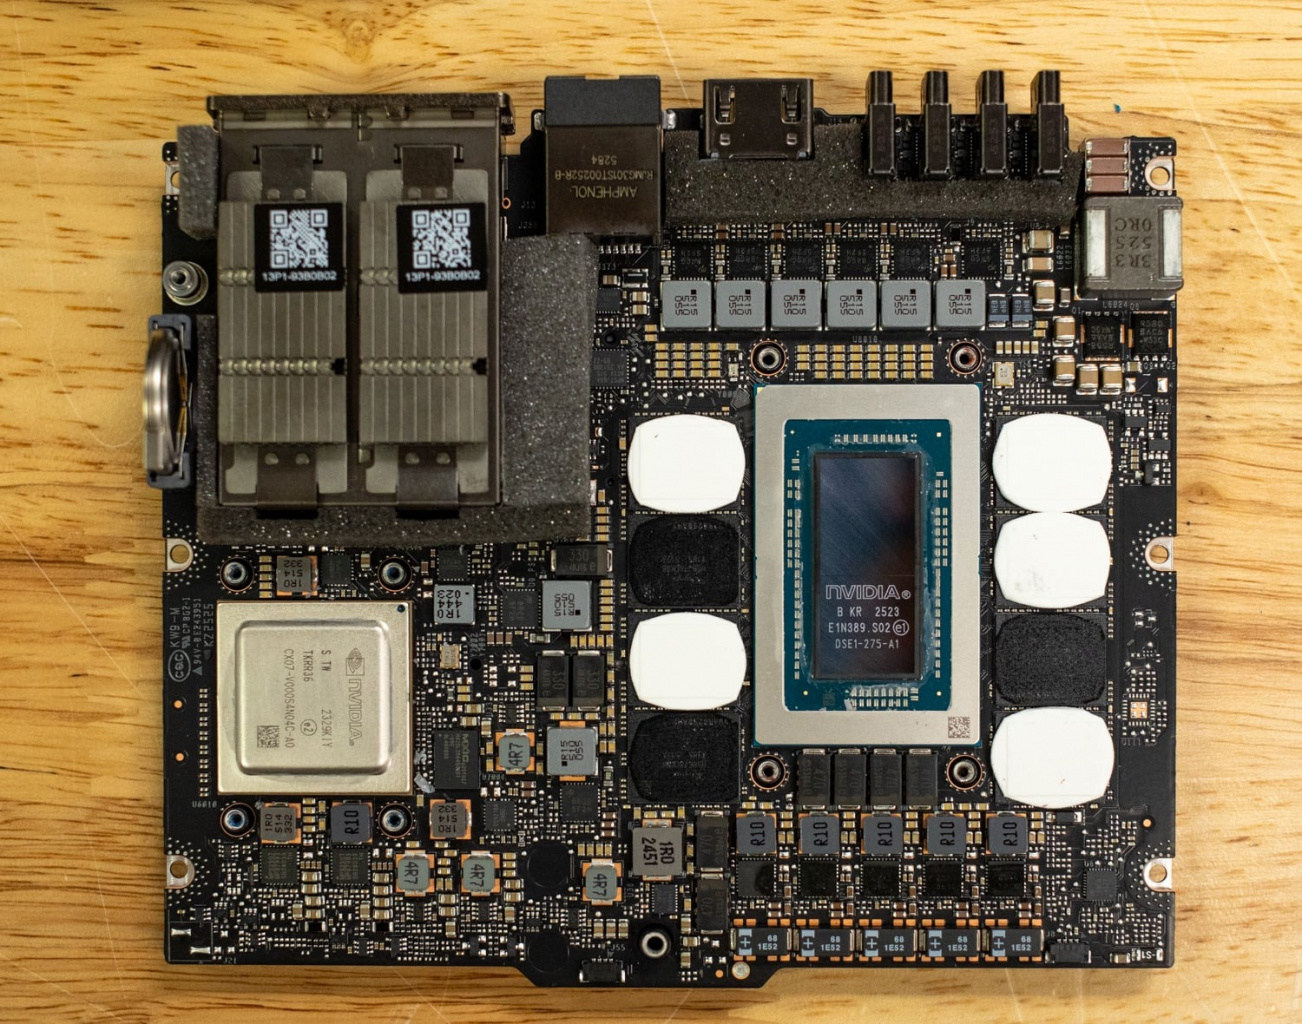
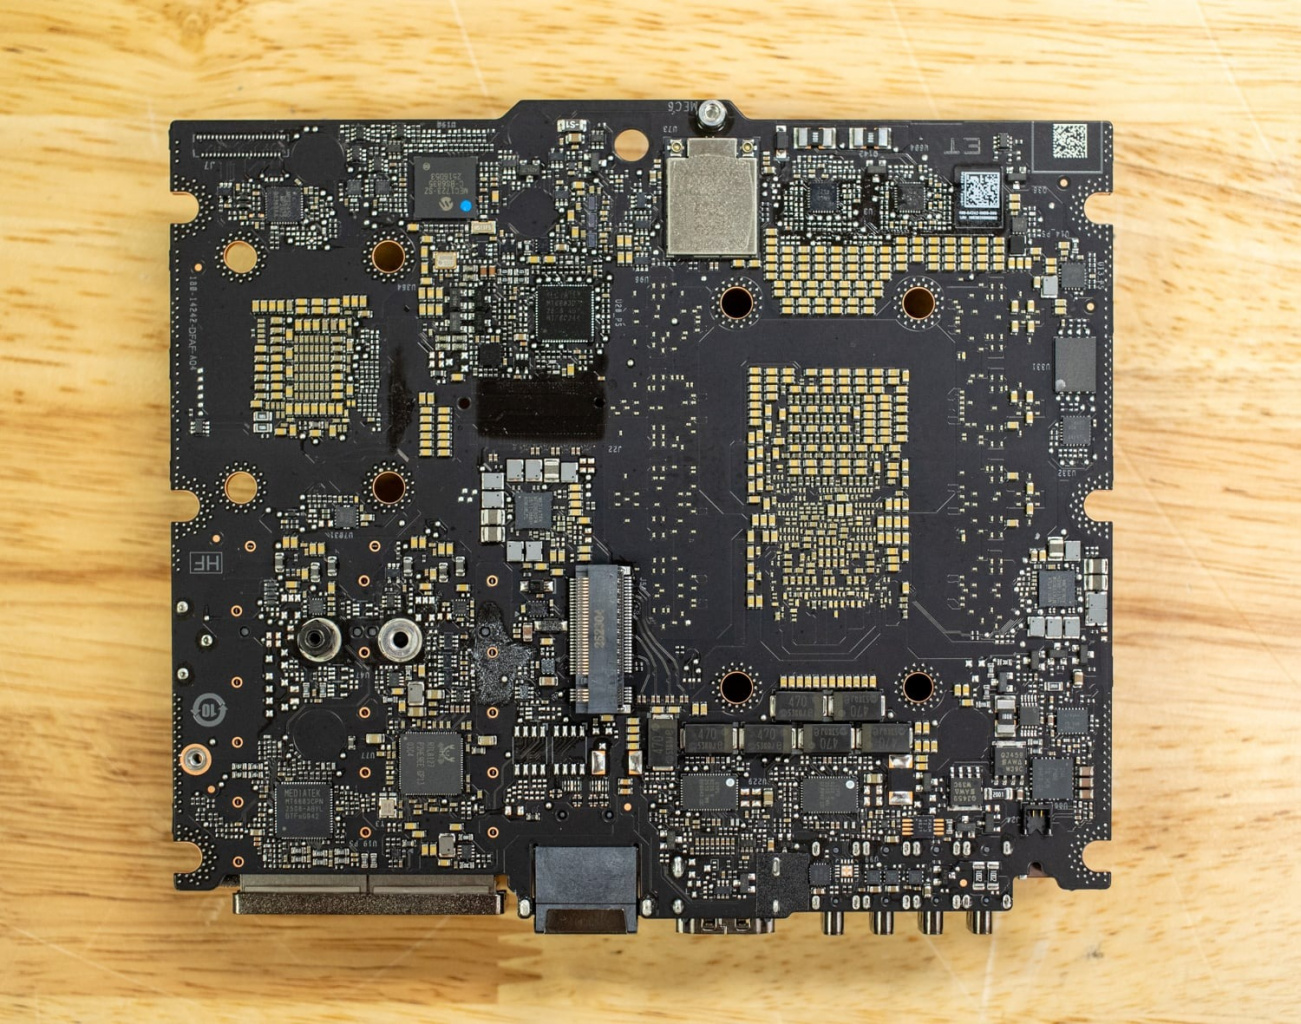
В исследованном устройстве установлен накопитель Samsung емкостью 4 Тбайт в формате M.2 2242 с подключением PCIe 5.0 x4. Обозначение 2242 соответствует ширине платы 22 мм и длине 42 мм. Такой накопитель удобен для компактного корпуса, а его реальную пригодность для длительных операций записи следует оценивать по результатам испытаний конкретной модели и по поведению при заполнении.
Подключения на задней панели
На задней панели находятся USB-C, HDMI, обычный сетевой порт 10 Гбит/с и два разъема QSFP, связанные с ConnectX-7. Один из четырех USB-C используется для питания. Порт Ethernet 10 Гбит/с удобен для включения устройства в существующую сеть, а высокоскоростное подключение ConnectX-7 предназначено для более требовательного обмена между системами и внешними ресурсами.
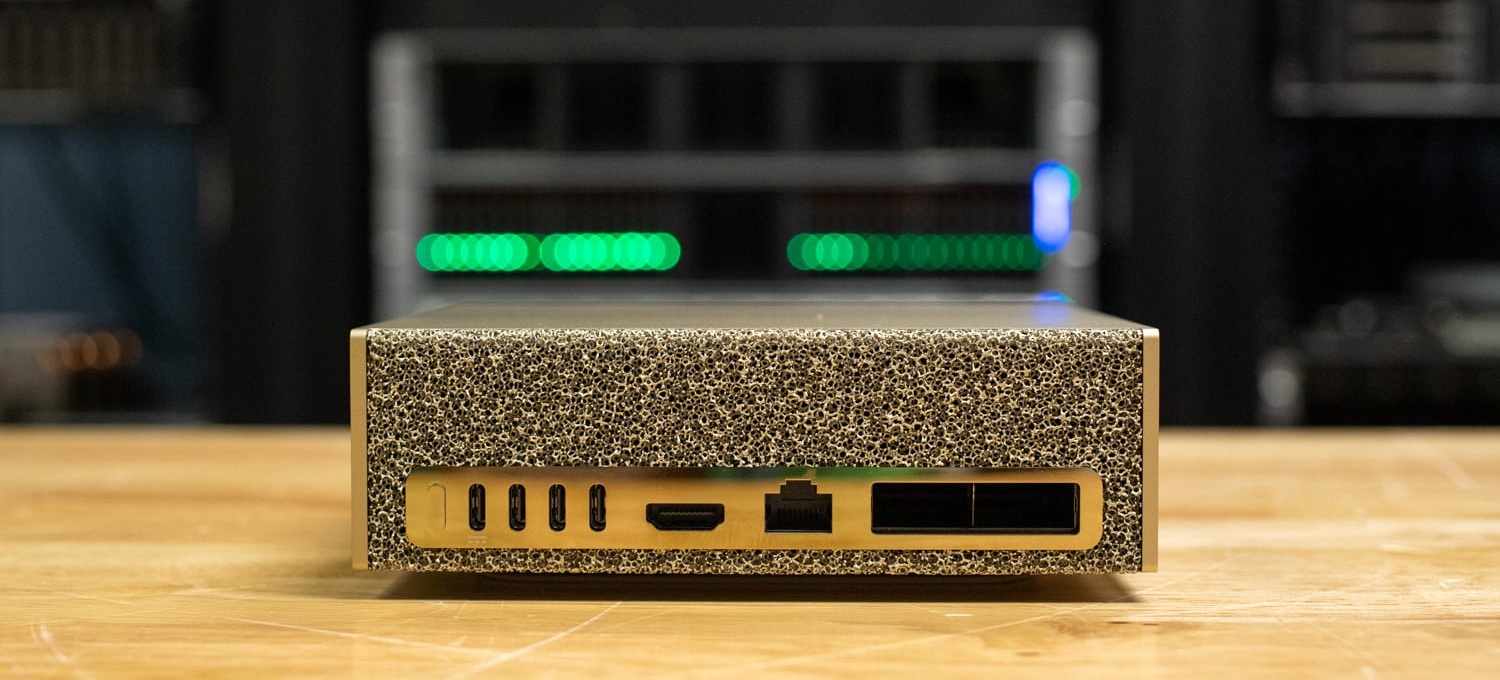
Наличие двух QSFP-разъемов не означает гарантированные 400 Гбит/с полезной пропускной способности приложения. Контроллер связан с GB10 двумя соединениями PCIe 5.0 x4, а один физический сетевой разъем представлен в Linux несколькими интерфейсами. При настройке необходимо учитывать соответствие портов, сетевых имен и устройств RoCE, совместимость кабеля и фактическую скорость обмена в выбранной программе.
Для пилота достаточно заранее определить роль каждого подключения. Управление и доступ сотрудников можно организовать через существующую сеть. Канал между двумя Spark или внешним быстрым хранилищем проектируют отдельно, с учетом требуемой полосы, задержек и поддержки нужных режимов программным стеком. Это упрощает диагностику и позволяет понимать, какой ресурс ограничивает результат.
Программная среда и эксплуатация
DGX OS и контейнеры
На устройстве используется DGX OS — дистрибутив Linux на основе Ubuntu с драйверами, диагностическими средствами и настройками для аппаратной платформы NVIDIA. Экосистема включает CUDA, библиотеки нейросетевых вычислений и контейнерные среды для PyTorch, TensorRT-LLM и других инструментов. Для команды это проверенная отправная точка, к которой добавляются выбранные модели, приложения и корпоративные интеграции.
Развертывание конкретного проекта все равно требует согласовать версии компонентов. Существенны версия драйвера и CUDA, контейнер, формат контрольной точки модели, поддерживаемые операции и объем свободной памяти. Для воспроизводимости полезно сохранять версии образов и настройки вместе с кодом проекта. Обновление среды сначала проверяют на контрольном наборе задач, а затем распространяют на рабочие запуски.
DGX Spark не следует рассматривать как прямую замену GPU-серверу виртуализации. NVIDIA не поддерживает GPU passthrough для этой платформы. Если проект предусматривает несколько виртуальных машин с выделенными GPU-ресурсами, совместимость архитектуры необходимо проверить до выбора оборудования.
Работа с ноутбука через NVIDIA Sync
NVIDIA Sync упрощает подключение к Spark с Windows, macOS и Ubuntu: управляет SSH-соединениями, туннелями и перенаправлением портов. Через такую схему можно использовать удаленные среды разработки и приложения, сохраняя вычисления на локальном узле. Для сотрудника Spark выступает дополнительным ресурсом рядом с привычным компьютером.
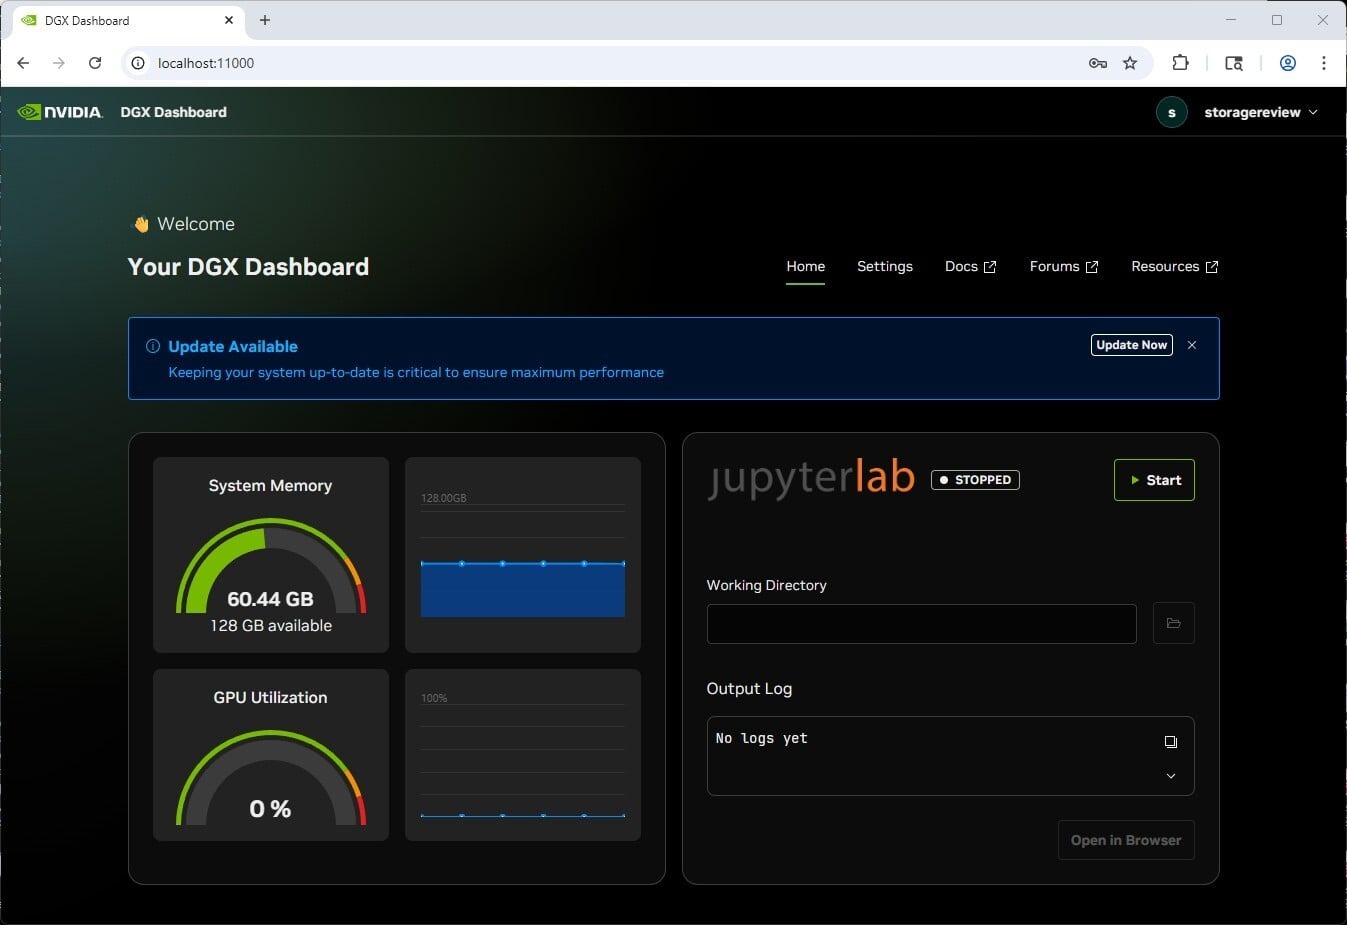
Панель DGX Dashboard дает доступ к состоянию системы и связанным инструментам. В эксплуатации полезно контролировать не только загрузку ускорителя, но и занятую общую память, свободное место, длительность заданий и температуру. На платформе с общей памятью привычный счетчик выделенной видеопамяти может отображаться иначе, чем на дискретной видеокарте; это нужно учитывать при настройке мониторинга.
Готовые руководства для типовых задач
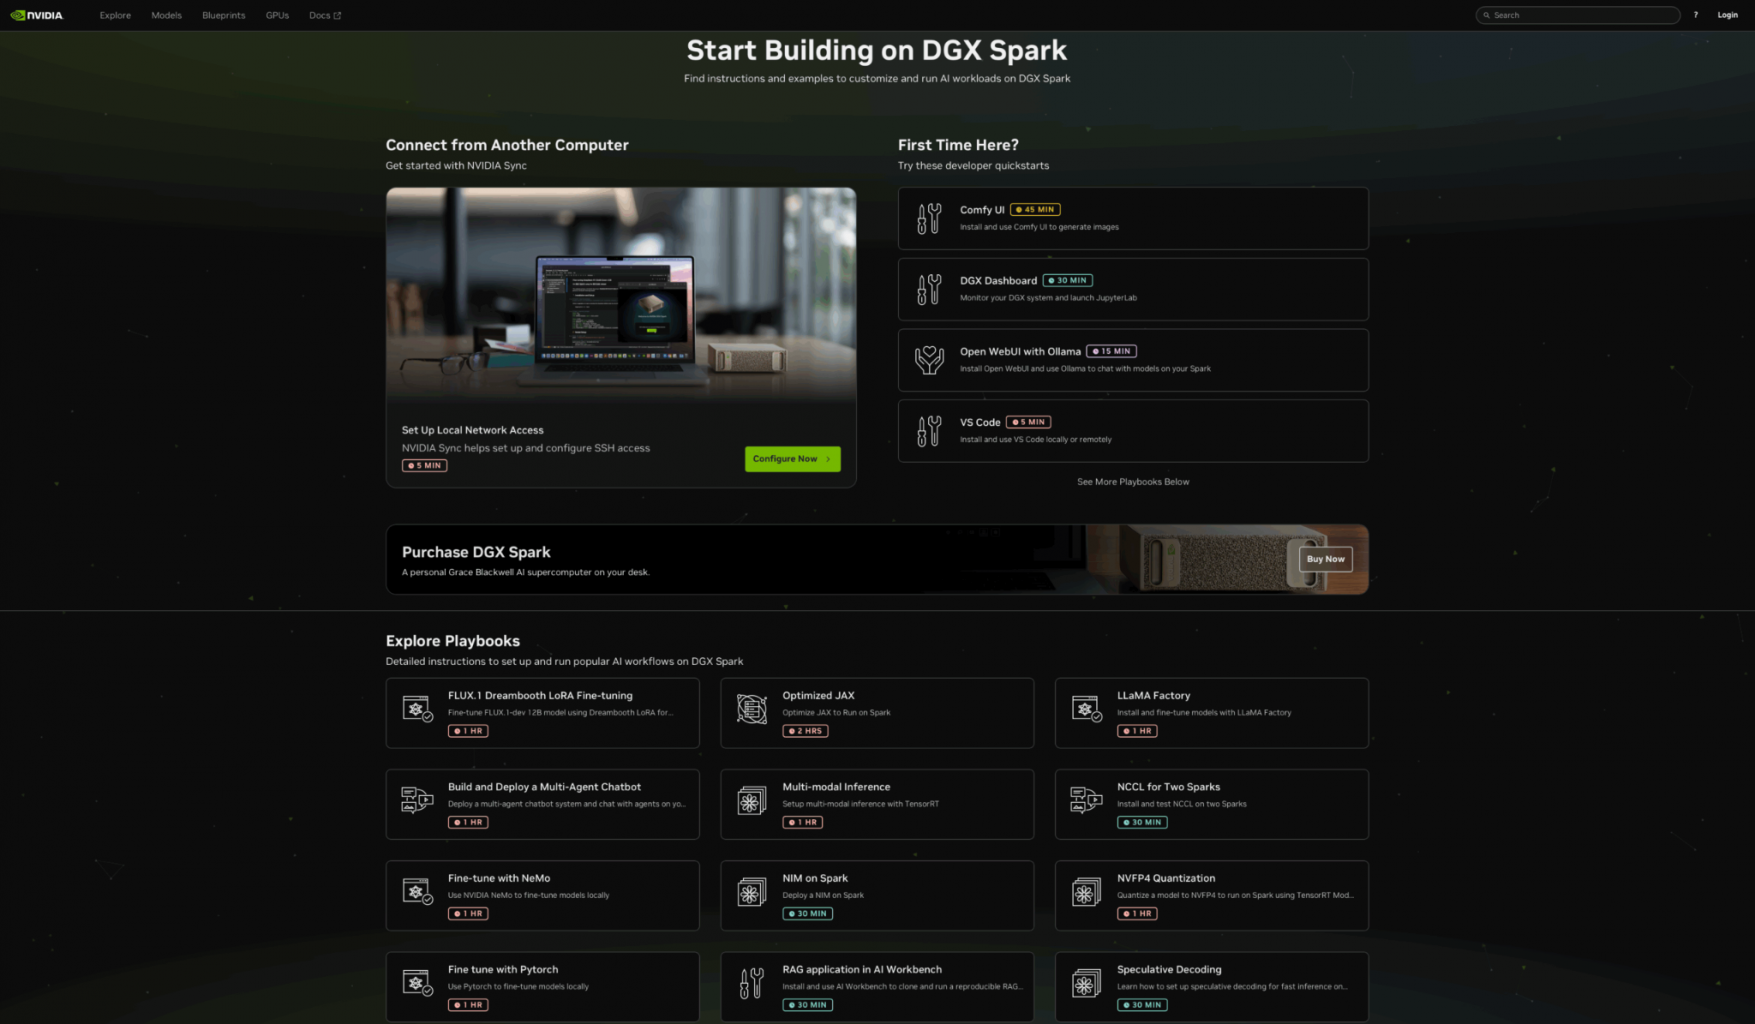
В каталоге DGX Spark Playbooks собраны пошаговые сценарии для запуска языковых моделей, генерации изображений, дообучения и обработки данных. Они помогают быстро получить воспроизводимый пример и проверить, соответствует ли платформа потребностям команды. Практическая польза таких материалов — в согласованном наборе версий и понятных начальных условиях.
В проекте руководства удобно использовать как основу испытательного стенда. После запуска примера в него добавляют свои данные, контроль качества и нужные ограничения по времени выполнения. Если результат устраивает, конфигурацию фиксируют. Такой путь позволяет оценивать стоимость дальнейшей интеграции еще до масштабирования решения.
Что учитывать из-за архитектуры Arm
DGX Spark использует Arm, поэтому двоичные пакеты и контейнеры должны быть совместимы с этой архитектурой. Готовую сборку для x86-64 нельзя считать автоматически подходящей. Особенно внимательно проверяют расширения Python с собственным машинным кодом, библиотеки обработки данных, инструменты профилирования и приложения, рассчитанные на определенный набор процессорных инструкций.
Для корпоративной команды проверка совместимости входит в пилот наравне с измерением скорости модели. Если проект уже работает на другой платформе, стоит заранее воспроизвести установку зависимостей и сборку собственных компонентов на Spark. Это помогает отделить вычислительный потенциал устройства от трудоемкости переноса конкретного программного окружения.
Испытания языковых моделей: что показывают результаты
Как читать токены в секунду
В тесте обслуживания запросов измеряется суммарная скорость генерации выходных токенов. Токен — единица представления текста внутри модели; число токенов в слове зависит от языка и используемого словаря. Показатель удобен для сравнения режимов одной модели при одинаковом характере запросов, но его нельзя напрямую считать скоростью ответа каждого пользователя.
При увеличении числа параллельных запросов ускоритель может эффективнее объединять вычисления, и общая производительность растет. Одновременно меняются ожидание начала ответа и скорость отдельного потока. Поэтому для интерактивного помощника вместе с общей скоростью важны время до первого токена, интервалы выдачи следующих токенов и поведение очереди под нагрузкой.
В таблице измеряется суммарная пропускная способность сервера. Например, 924 токена/с при 128 параллельных запросах не означает генерацию 924 токенов/с для каждого пользователя. Для интерактивных приложений дополнительно оцениваются задержка до первого токена, скорость отдельного потока и полное время выполнения запроса.
|
Модель
|
Представление
|
Один запрос, токенов/с
|
Максимум на графике, токенов/с
|
Параллельных запросов в этой точке
|
|
Qwen3-Coder-30B-A3B
|
BF16
|
27,8
|
166,2
|
64
|
|
Qwen3-Coder-30B-A3B
|
FP8
|
46,5
|
482,6
|
64
|
|
Mistral Small 3.1 24B
|
BF16
|
5,3
|
158,9
|
128
|
|
Mistral Small 3.1 24B
|
Динамическая квантизация FP8
|
8,8
|
319,7
|
128
|
|
Llama 3.1 8B
|
BF16
|
13,6
|
408,6
|
128
|
|
Llama 3.1 8B
|
FP8
|
23,2
|
752,8
|
128
|
|
Llama 3.1 8B
|
FP4
|
34,1
|
924,1
|
128
|
|
GPT-OSS-20B
|
Четырехбитное микромасштабирование; см. пояснение о формате
|
39,7
|
611,7
|
128
|
|
GPT-OSS-120B
|
Четырехбитное микромасштабирование; см. пояснение о формате
|
31,4
|
162,7
|
64
|
В таблице приведена суммарная скорость выходных токенов по всем запросам. Для максимального значения указана соответствующая точка на опубликованном графике. Пропуск отсутствующих точек в графике нельзя трактовать как нулевую производительность.
Qwen3-Coder: разница между BF16 и FP8
Модель Qwen3-Coder-30B-A3B использует архитектуру «смесь экспертов»: при генерации каждого токена задействуется часть параметров, хотя для хранения всей модели нужен существенно больший объем памяти. В исследованной конфигурации FP8 дает заметное преимущество по пропускной способности. При этом кривая достигает максимума раньше наибольшего числа параллельных запросов, что важно учитывать при настройке очереди.
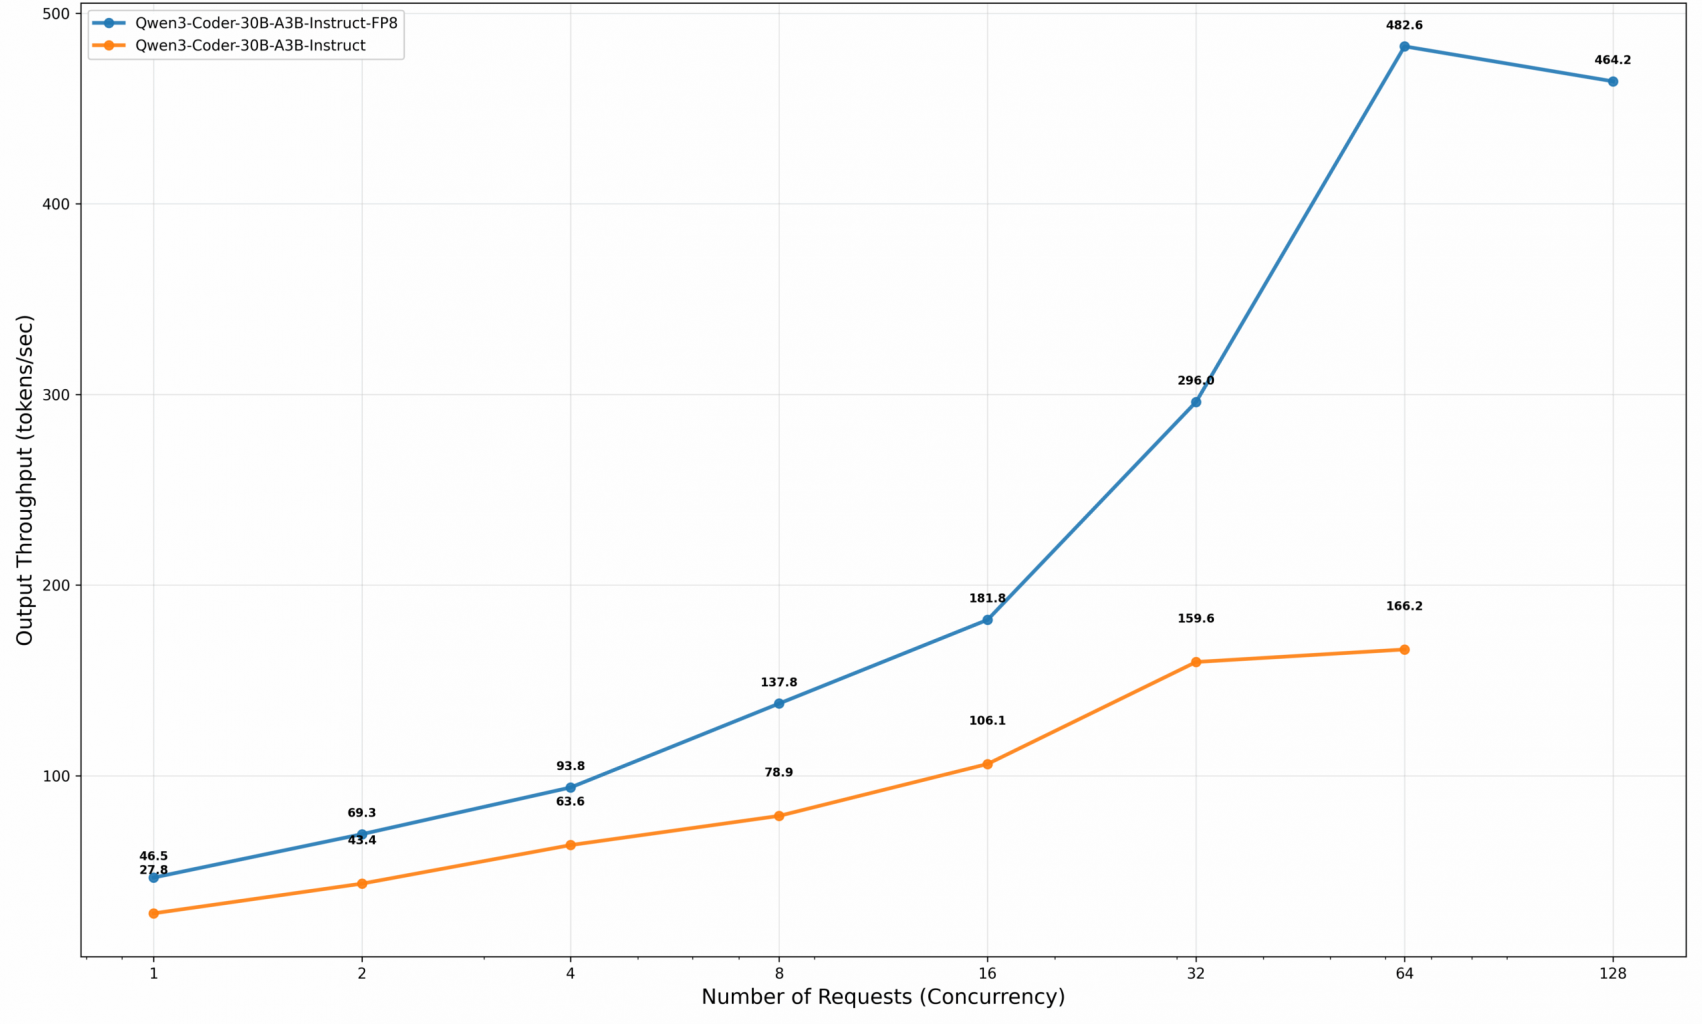
Для команды разработки это повод испытать несколько представлений одной модели и несколько режимов обслуживания. Выбор должен сохранять полезность результата на внутреннем коде, качество работы с инструментами и приемлемое время ответа. Более низкая разрядность представляет интерес, когда позволяет выполнить эти требования с меньшим расходом памяти и более высокой скоростью.
Mistral Small и Llama: плотные модели
В плотной модели каждый шаг генерации использует весь основной набор параметров. В этой группе сравнивались Mistral Small 3.1 24B и Llama 3.1 8B в нескольких форматах. Графики показывают, насколько существенно меняется результат при квантизации и увеличении параллелизма. Они также демонстрируют, почему одной цифры о размере модели недостаточно для выбора режима работы.
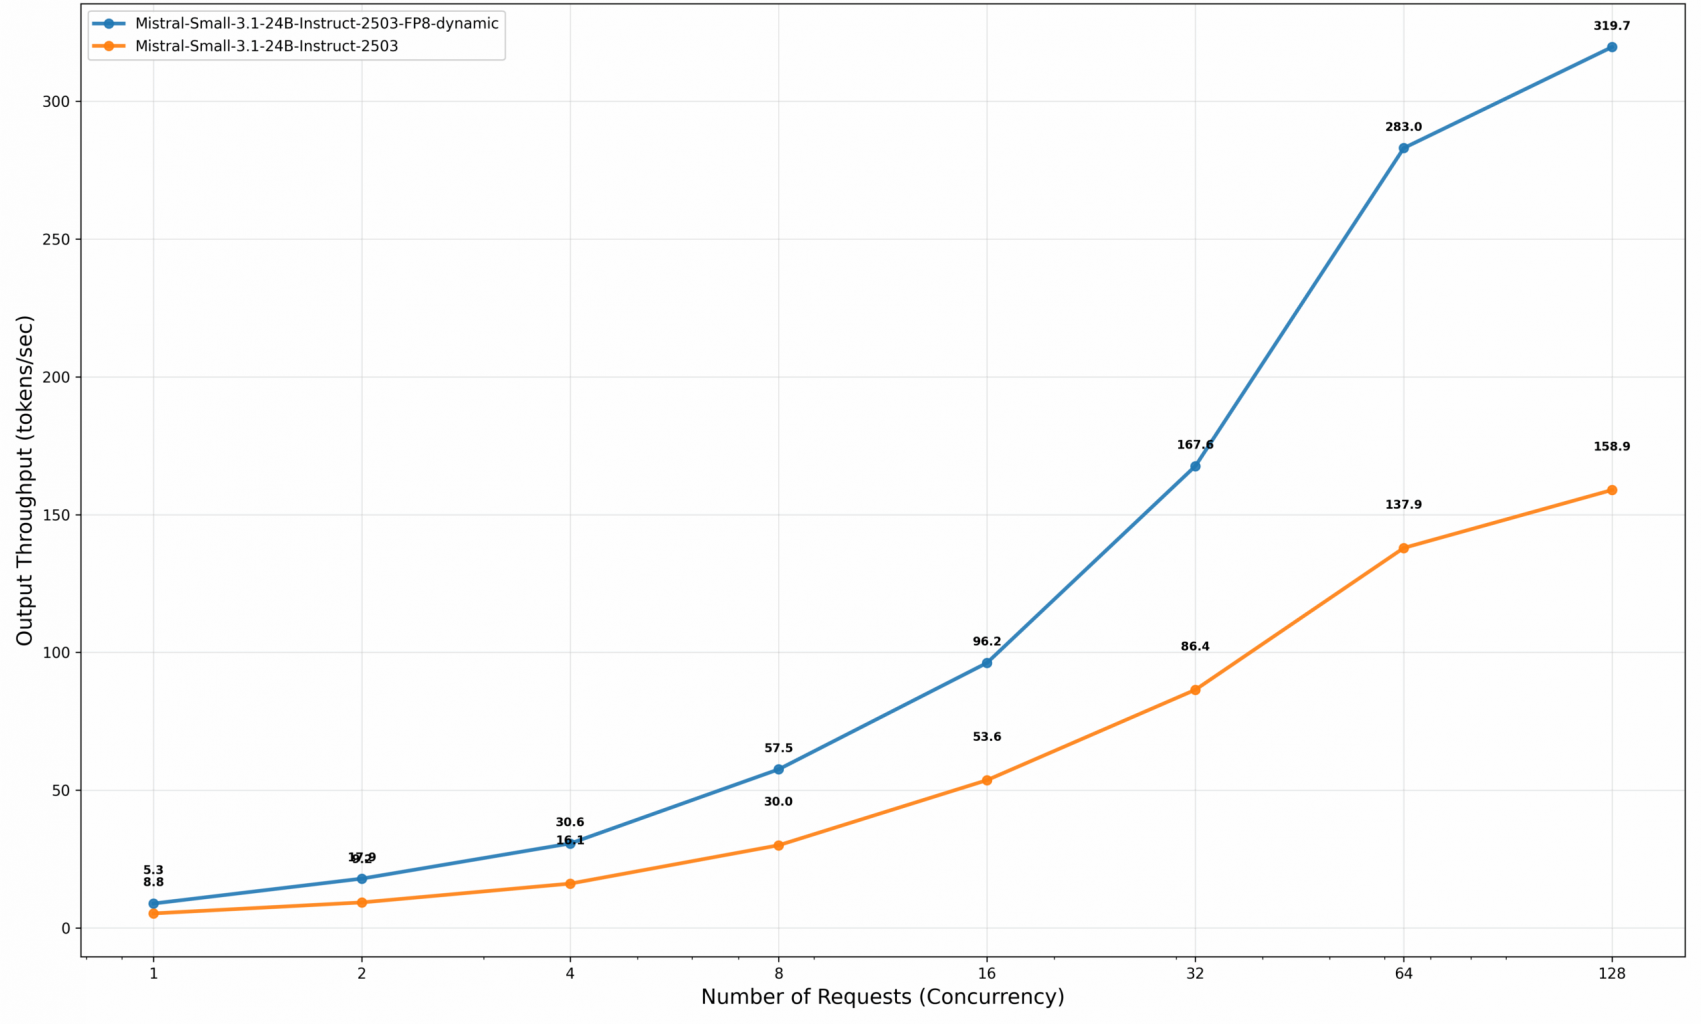
Mistral Small 3.1 24B: суммарная скорость выходной генерации в BF16 и с динамической квантизацией FP8.
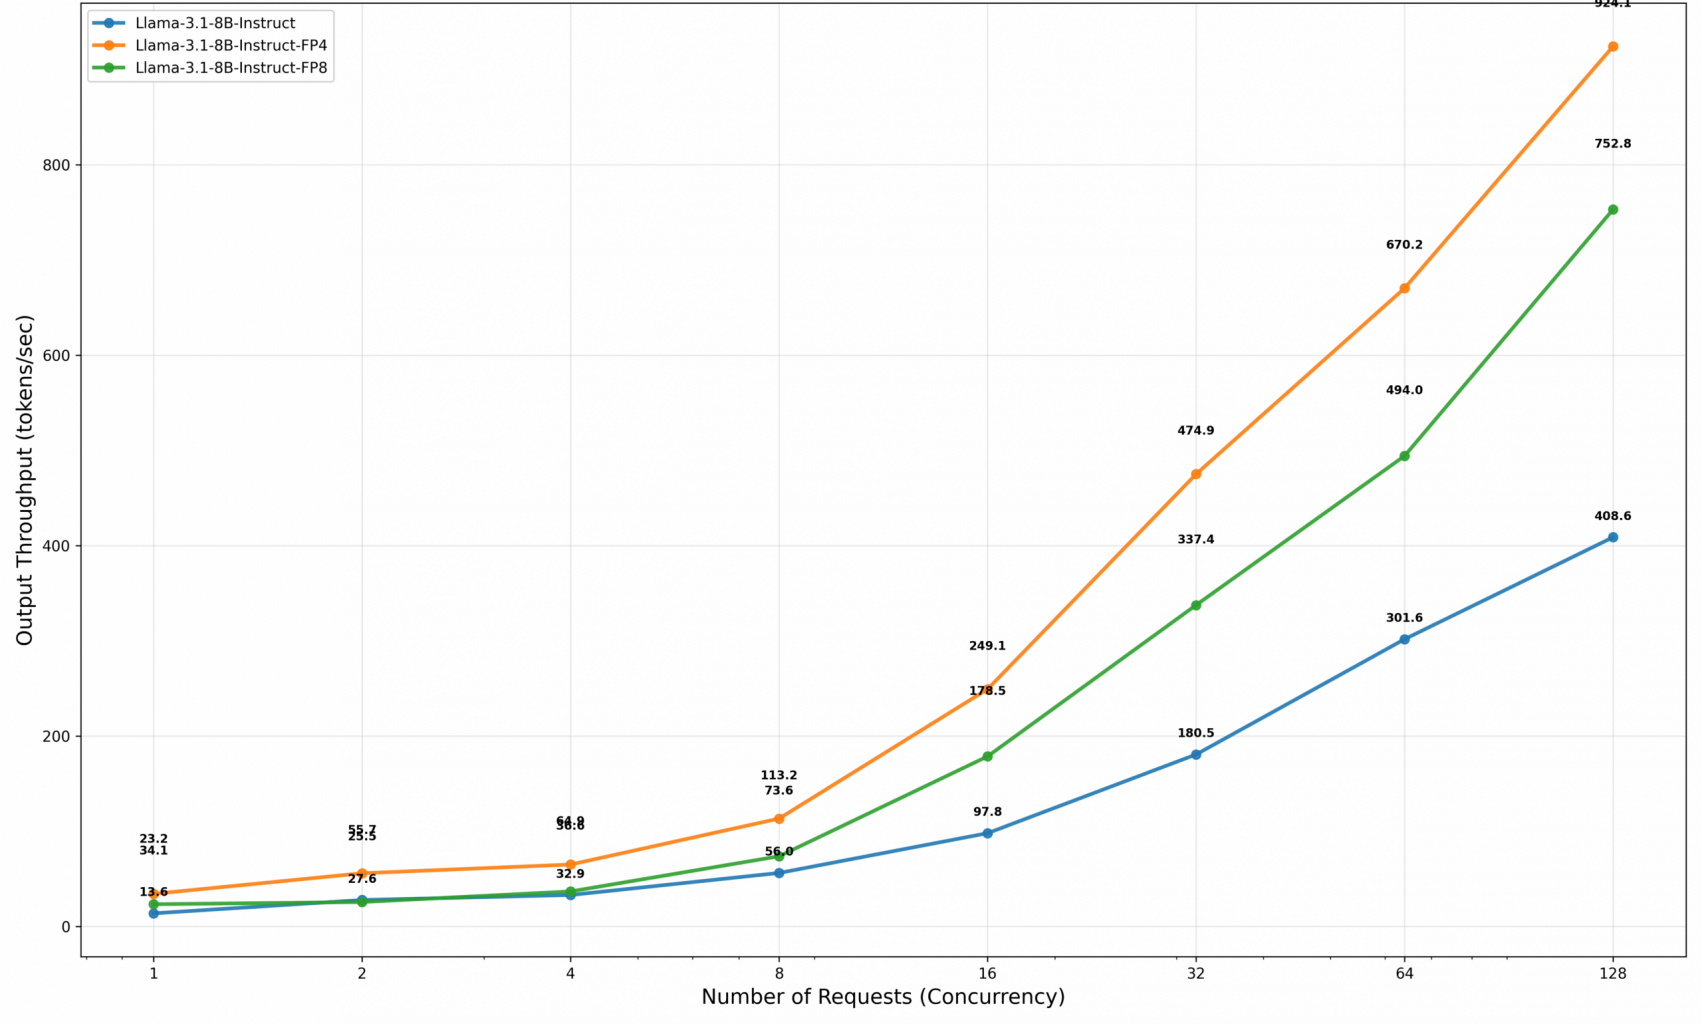
Llama 3.1 8B: суммарная скорость выходной генерации для BF16, FP8 и FP4.
Для прикладной системы высокая суммарная скорость полезна при пакетной обработке: подготовке черновиков, классификации документов или создании наборов данных. Для разговора с сотрудником нужно отдельно проверить качество и скорость конкретной модели на типичной длине запроса. Результаты квантизированной версии не дают основания заранее считать качество идентичным исходной: это проверяют на задачах компании.
GPT-OSS: большой размер и микромасштабирование
Семейство GPT-OSS также относится к моделям со смесью экспертов. В исходных опубликованных контрольных точках веса экспертов используют MXFP4. Этот формат следует отличать от NVIDIA NVFP4: оба относятся к четырехбитным представлениям с масштабированием, но не являются взаимозаменяемыми обозначениями. Для воспроизведения результата важны конкретная контрольная точка и поддержка ее формата в выбранной среде.
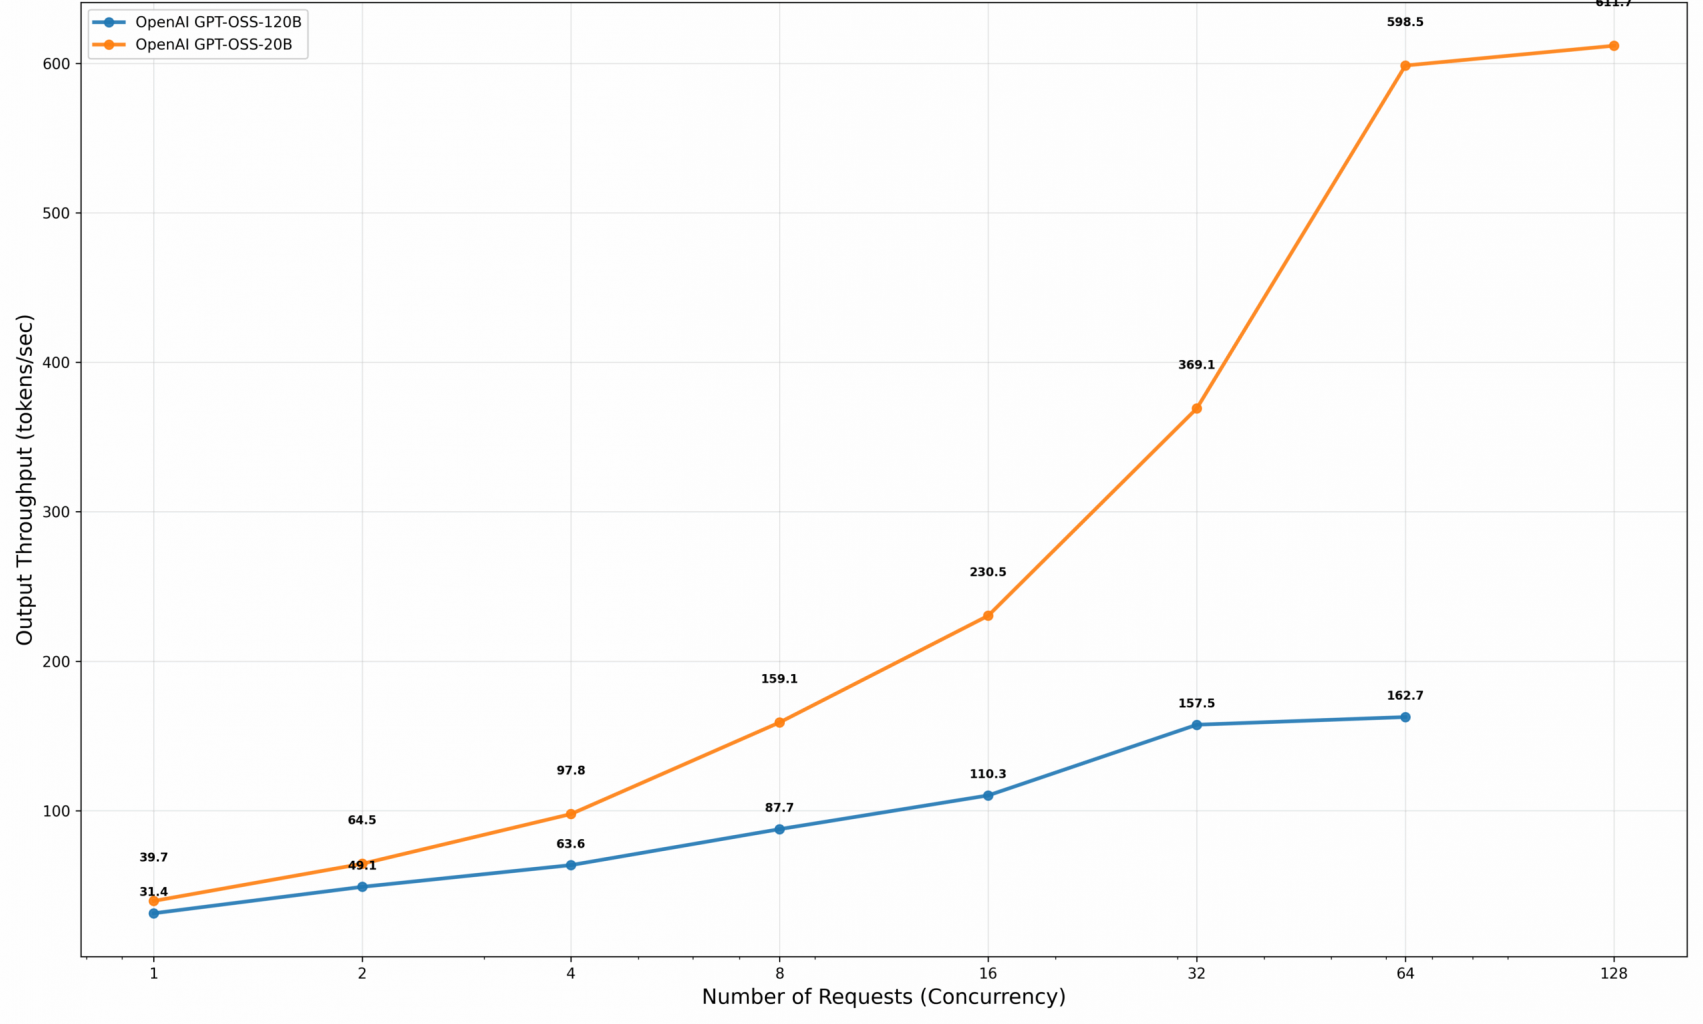
GPT-OSS-20B и GPT-OSS-120B: суммарная скорость выходной генерации. Уточнение формата весов приведено в тексте.
Длинный запрос и длинный ответ нагружают систему по-разному
Обработка запроса состоит из двух разных этапов. Сначала модель обрабатывает входной контекст — этот этап называют prefill. Затем последовательно генерирует ответ, или выполняет decode. На первом этапе существенно используются параллельные матричные вычисления, на втором же важны повторное обращение к весам и работа с кэшем ключей и значений, который хранит данные уже обработанного контекста.
|
Профиль
|
Входных токенов
|
Выходных токенов
|
Прикладной смысл
|
|
Длинный вход, prefill-heavy
|
8 192
|
512
|
Обработка большого контекста перед относительно коротким ответом
|
|
Длинный ответ, decode-heavy
|
512
|
8 192
|
Продолжительная последовательная генерация
|
Для сравнения этих профилей использовалась Qwen3-Coder-30B-A3B FP8. График общей производительности учитывает входные и выходные токены, поэтому его значения отличаются по смыслу от предыдущих графиков скорости только выходной генерации. Сопоставлять такие показатели как одинаковые «токены в секунду» было бы некорректно.
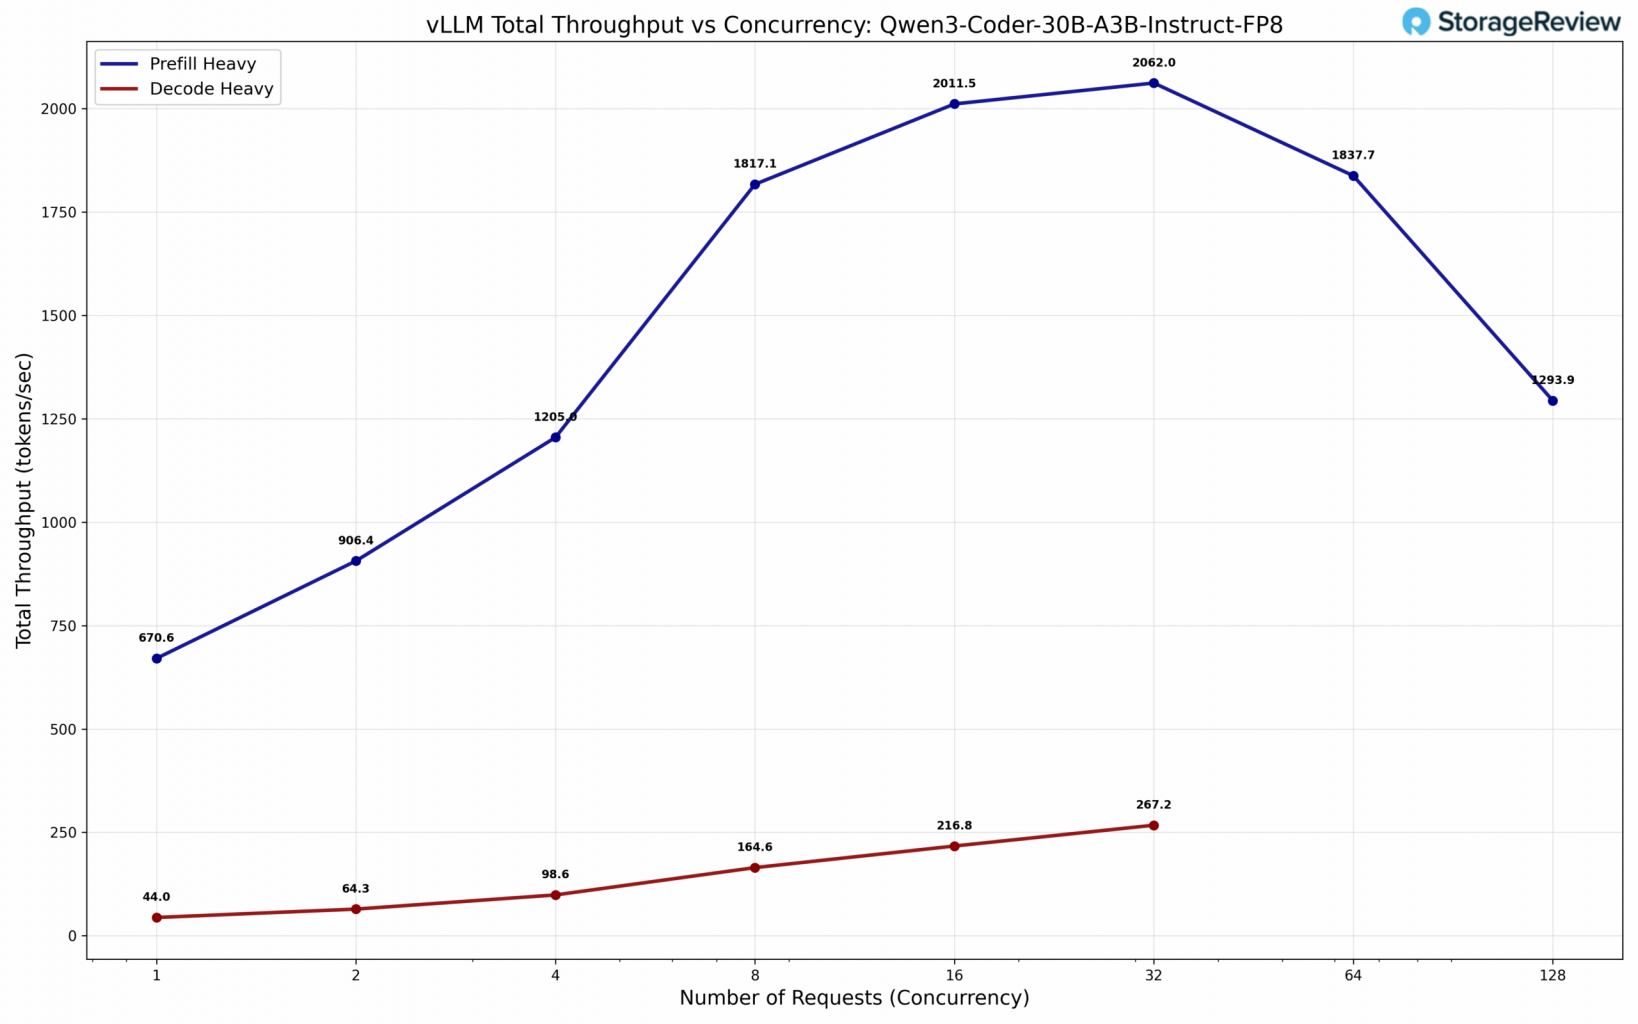
Общая скорость обработки входных и выходных токенов для двух профилей запроса. Ее смысл отличается от скорости только выходной генерации.
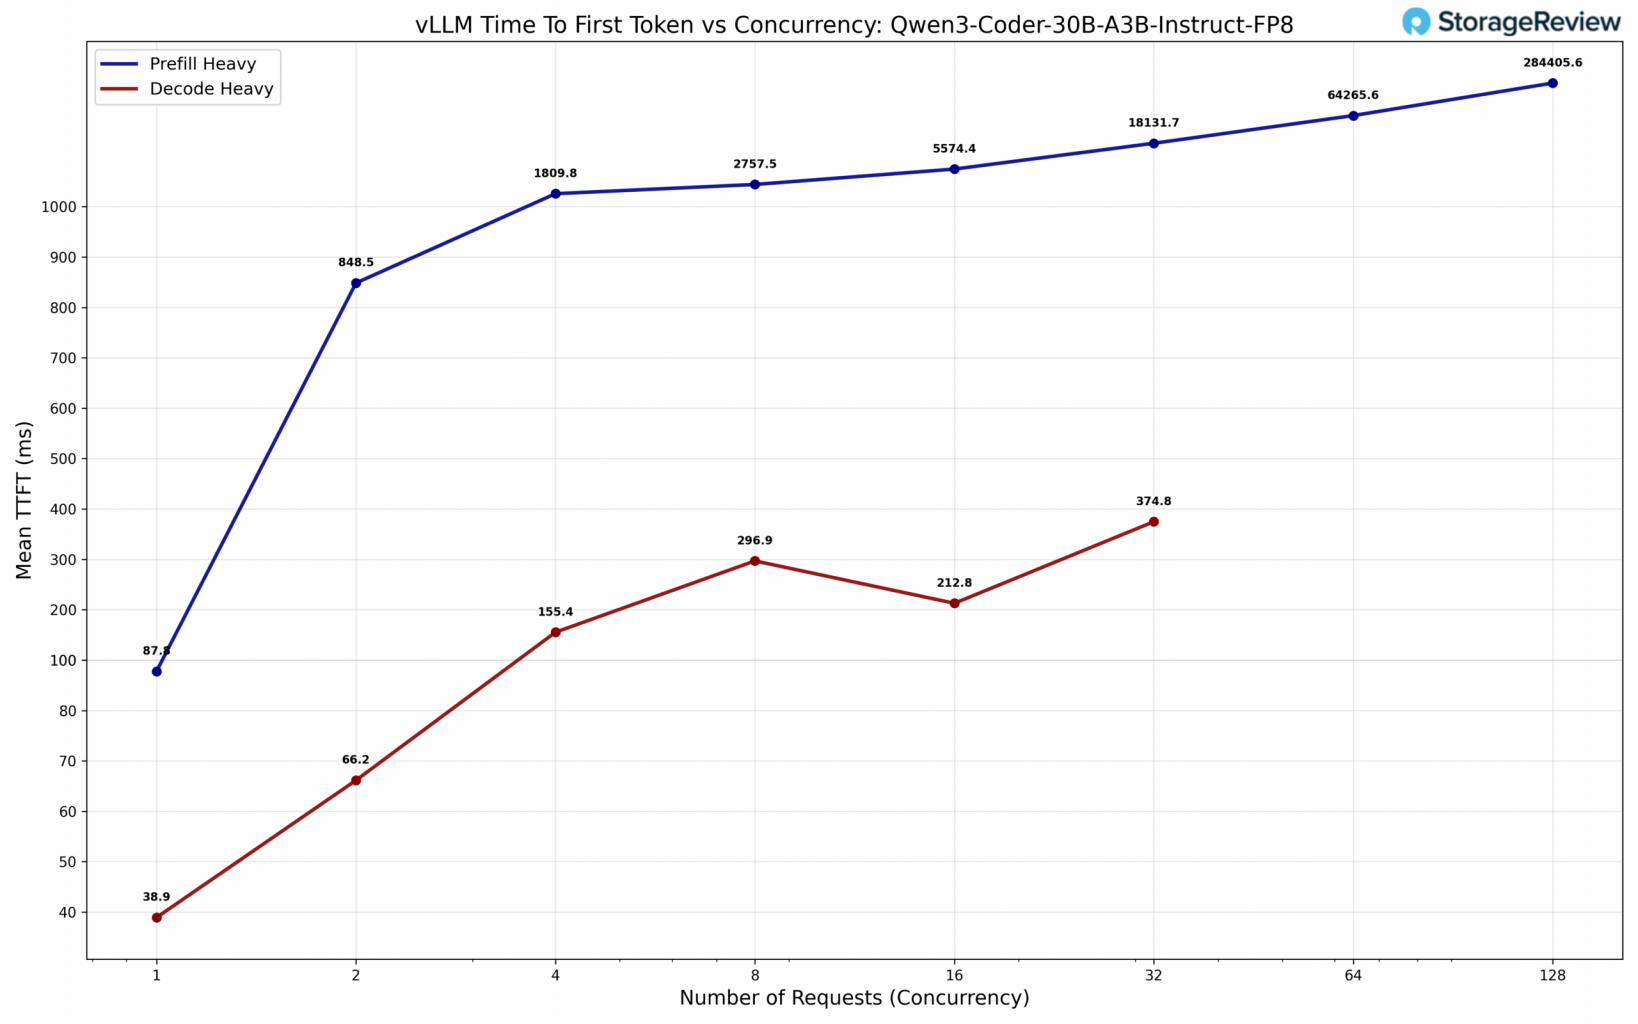
Среднее время до первого токена в миллисекундах. Численные подписи показывают рост ожидания при длинном входе и высоком параллелизме.
У профиля с длинным входом при росте параллелизма увеличивается ожидание первого токена: по подписям на диаграмме — от 87,8 мс для одного запроса до 284 405,6 мс, или примерно 284,4 секунды, при 128 запросах. Этот пример особенно важен для корпоративного поиска с добавлением больших фрагментов документов в контекст. Высокая общая пропускная способность не заменяет ограничение на время, которое сотрудник готов ждать начала ответа.
Проверку приложения следует строить по его фактическому профилю. Помощник по документации, генератор длинных отчетов и обработчик коротких карточек товаров создают разные нагрузки даже на одной модели. Полезно тестировать типичную задачу и наиболее тяжелый допустимый запрос, а число одновременных обращений ограничивать по приемлемому отклику.
При работе с длинным контекстом отдельной задачей становится хранение и повторное использование KV-кэша. Как в серверной инфраструктуре для этого применяют оперативную память и накопители, разбираем в статье о выгрузке KV-кэша на SSD. Рассмотренный там подход требует поддержки со стороны программной среды и отдельной проверки на выбранном оборудовании
Матричная производительность MAMF
Дополнительный тест MAMF измеряет достижимую скорость матричного умножения при разных размерах матриц. В опубликованных испытаниях получены значения около 99,8 терафлопса для BF16 и 207,7 терафлопса для FP8 E4M3. Отдельного завершенного измерения FP4 в этом наборе нет, а расчетные предположения о нем не следует выдавать за измеренный результат.
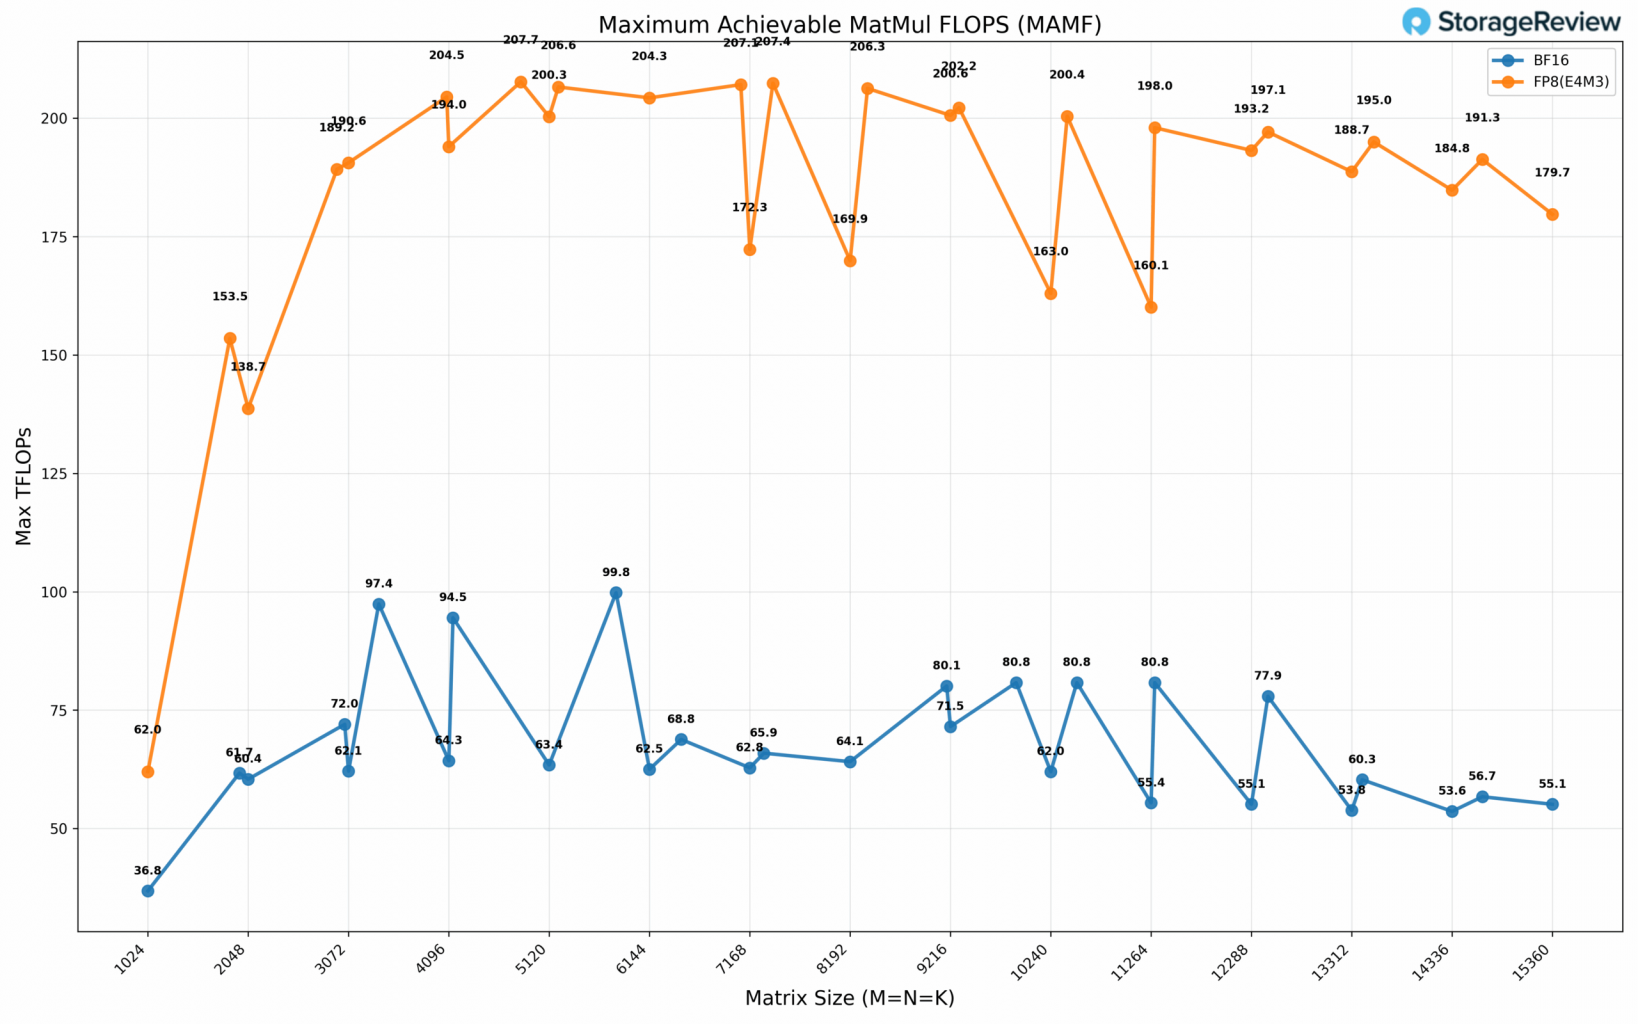
MAMF: производительность матричного умножения BF16 и FP8 в зависимости от размеров матриц. Такой тест помогает оценить вычислительные ядра и влияние формы операции, но не определяет скорость всей языковой модели. В приложении присутствуют обмены данными, обработка внимания, планирование запросов и другие этапы. Для закупочного решения MAMF имеет смысл использовать вместе с прикладными измерениями и оценкой памяти, а не как самостоятельный прогноз производительности.
Дообучение моделей на корпоративных данных
Полное дообучение и адаптеры решают разные задачи
Большой объем общей памяти делает Spark интересным для экспериментов с адаптацией языковых моделей. При полном дообучении обновляются все параметры. При использовании LoRA обучается значительно меньший набор дополнительных параметров, а основная модель сохраняется. QLoRA дополнительно использует квантизированную базовую модель, снижая потребность в памяти.
Выбор метода зависит от задачи и доступного времени. Для настройки стиля ответов, формата выдачи или поведения специализированного помощника разумно начать с адаптеров и сравнить результат с исходной моделью. Полное дообучение рассматривают, когда оно дает подтвержденный выигрыш в нужной задаче. Универсального превосходства одного метода по качеству для любого корпоративного набора данных нет.
Почему размер весов не равен памяти для обучения
Во время обучения дополнительно хранятся градиенты, состояния оптимизатора и промежуточные результаты вычислений. Например, у условной модели на 8 млрд параметров веса BF16 занимают около 16 Гбайт. При одной из распространенных схем смешанной точности к ним могут добавляться 16 Гбайт градиентов, 64 Гбайт двух состояний Adam в FP32 и 32 Гбайт основной копии весов FP32. Это уже около 128 Гбайт до учета активаций и служебной памяти.
Конкретная реализация может хранить эти данные иначе. Восьмибитные оптимизаторы, пересчет активаций, накопление градиентов и уменьшение пакета меняют требования к ресурсам. Поэтому возможность полного дообучения нельзя определять только числом параметров и объемом установленной памяти. Нужен проверенный рецепт с измерением пикового потребления и времени шага.
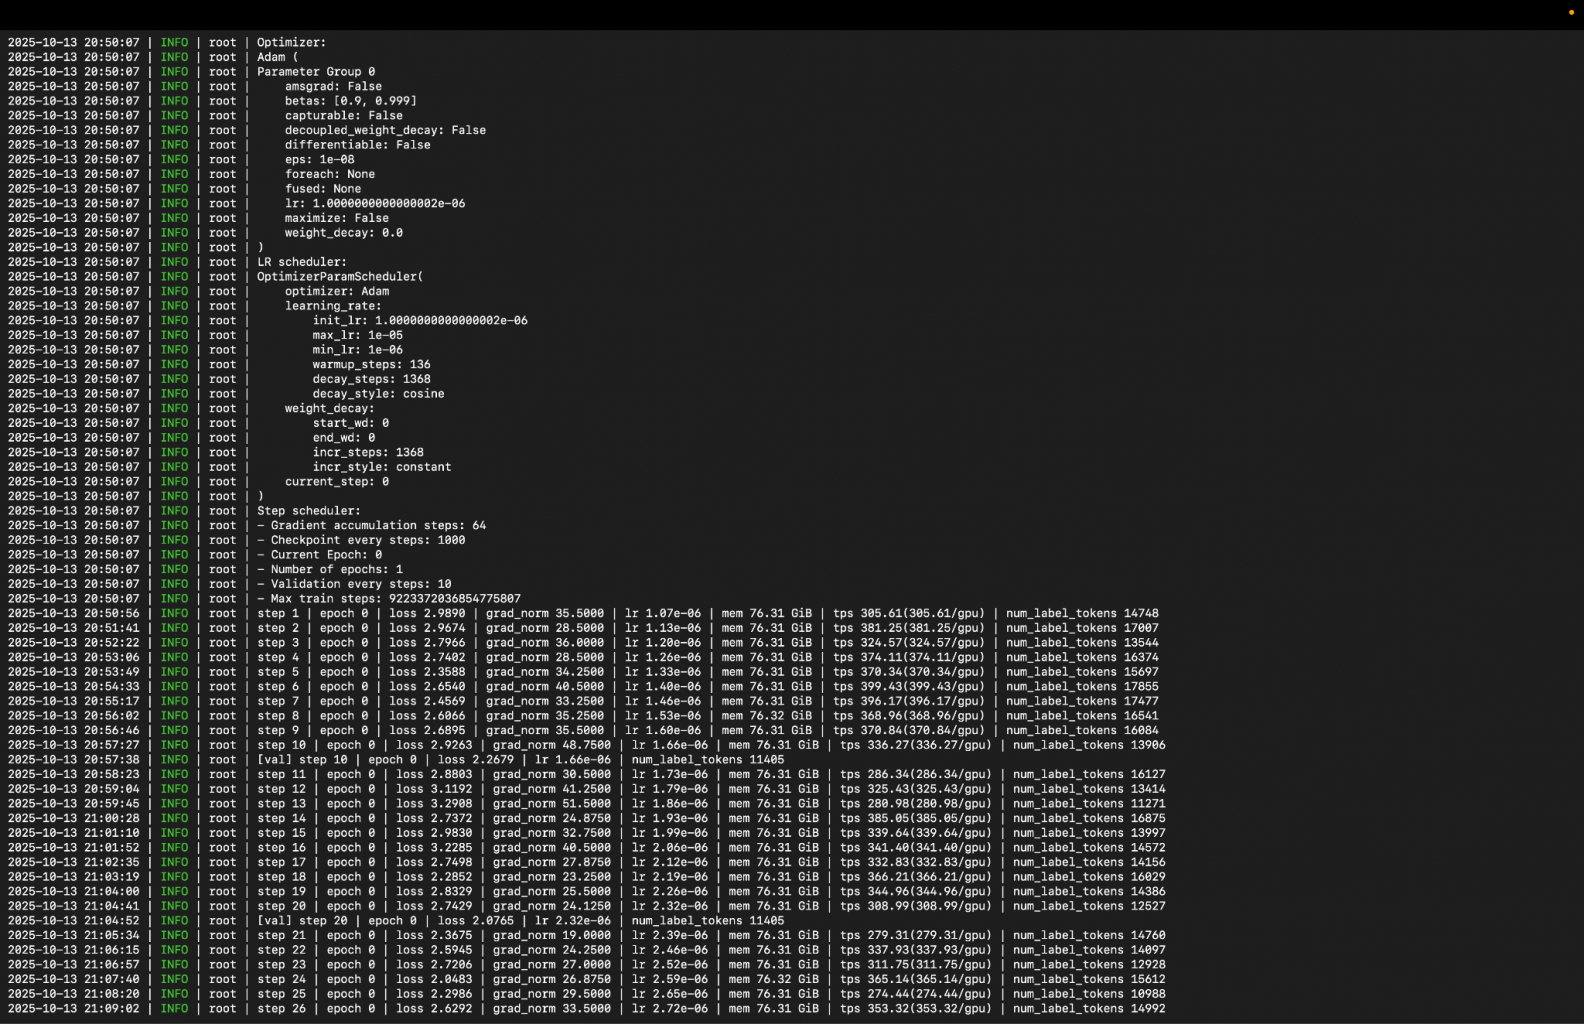
В официальных руководствах NeMo для Spark есть отдельные сценарии LoRA для моделей класса 8B и QLoRA для более крупных моделей. Такие примеры полезны как основа пилота, но их ограничения по длине последовательности, пакету и способу загрузки контрольной точки являются частью конфигурации. Изменение этих параметров требует повторной проверки памяти.
Для бизнеса результат дообучения стоит оценивать на отложенном наборе данных. В него включают типовые запросы, сложные случаи и проверки сохранения общих навыков модели. Вместе с качеством фиксируют время подготовки данных, продолжительность обучения и стоимость сопровождения. Это помогает понять, достаточно ли адаптации небольшой модели или проекту нужен другой класс вычислительной инфраструктуры.
Обработка данных, изображения и робототехника
Подготовка данных через CUDA-X Data Science
Значительная часть работы аналитика приходится на загрузку, очистку, объединение и преобразование таблиц. Библиотеки cuDF и cuML из экосистемы CUDA-X Data Science, ранее известной как RAPIDS, позволяют выполнять поддерживаемые операции на графическом ускорителе. Для Spark это дополнительный сценарий использования общей памяти помимо языковых моделей.
В пилоте следует измерять весь процесс: чтение исходных данных, преобразования, передачу результатов и последующее обучение. Если значительная часть времени уходит на неподдерживаемые операции или ожидание файлов, ускорение отдельного вычислительного шага может мало изменить срок выполнения задачи. Практический показатель — время получения готового набора признаков или проверенной аналитической модели.
ComfyUI и генерация материалов
ComfyUI позволяет строить последовательности генерации из связанных узлов: загрузки модели, обработки запроса, подготовки управляющих изображений, генерации и увеличения разрешения. Такой подход удобен для воспроизводимых творческих и исследовательских процессов. Конфигурацию можно сохранять и передавать вместе с проектом, а несколько вариантов модели — проверять на одних исходных данных.
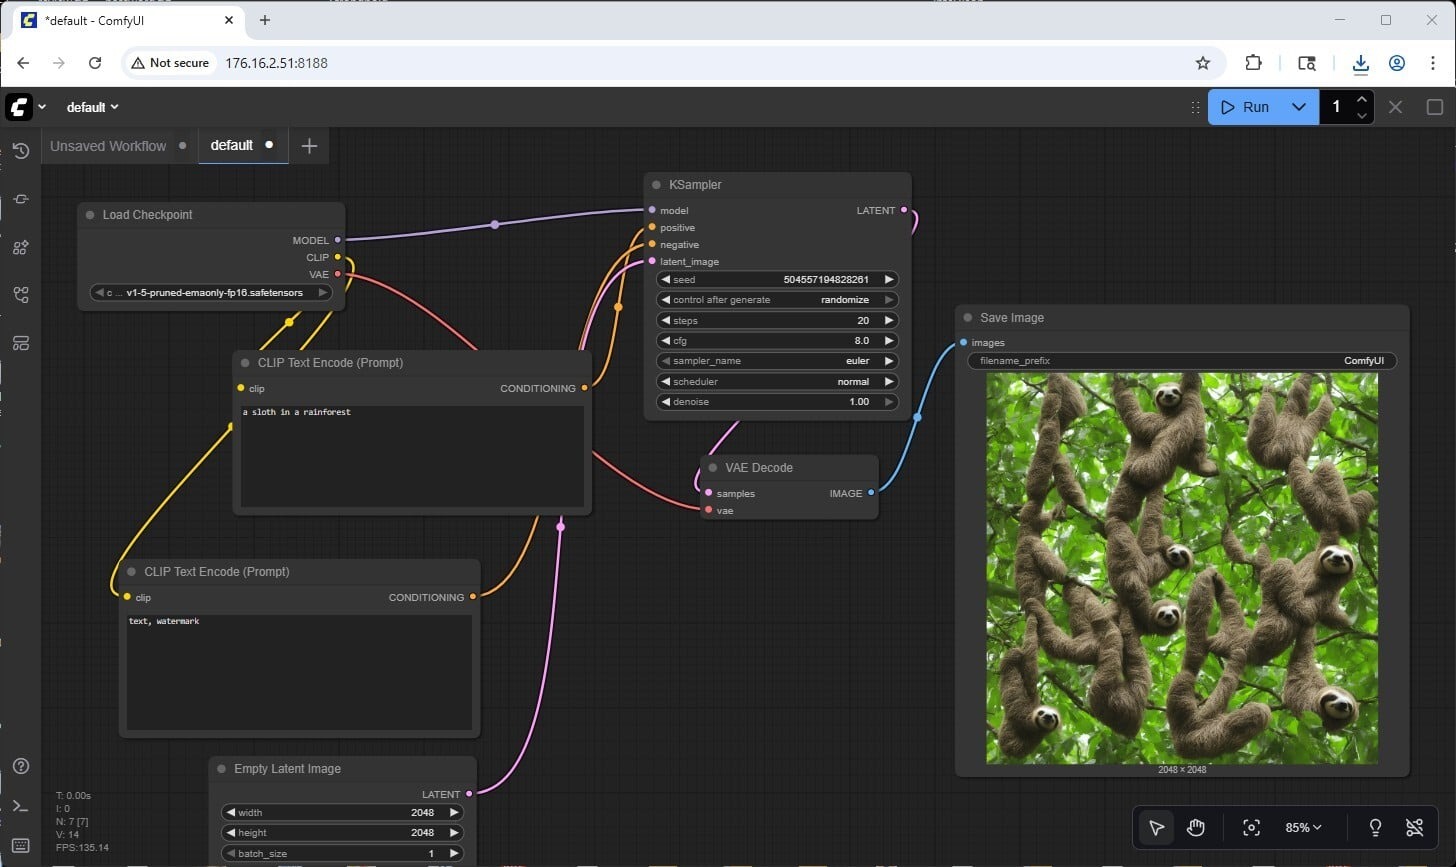
Для маркетинга и проектных подразделений важна возможность выполнять вычисления на отдельном узле, сохраняя рабочую станцию доступной для редактирования и согласования. При оценке скорости необходимо фиксировать модель, ее формат, разрешение, число шагов и дополнительные этапы обработки. Без этих параметров обещание определенного количества секунд на изображение не описывает воспроизводимый результат.
Синтетические данные и физические агенты
Экосистема NVIDIA включает инструменты симуляции, работы с трехмерными сценами и подготовки синтетических данных. На Spark можно исследовать совместную работу языковой модели, визуального анализа и управляющей логики. Поддержку конкретного режима симулятора и необходимые ресурсы проверяют отдельно: наличие ядер трассировки лучей само по себе не определяет скорость сложной сцены.
Показанный на CES 2026 сценарий с роботом Reachy Mini иллюстрирует использование Spark как вычислительной части физического агента: обработка входных данных, выбор действия и взаимодействие с человеком выполняются в связанном программном процессе. Для лаборатории или учебного центра это удобный формат прототипирования. Переход к промышленной эксплуатации требует отдельной оценки задержек, надежности и требований оборудования, которым управляет приложение.
Накопитель и внешнее хранилище: ограничения и результаты
Что именно измеряет gdsio
В октябрьских испытаниях использовалась утилита gdsio для оценки передачи данных при разных размерах блока и числе потоков. Для корректной интерпретации необходимо знать выбранный режим: этот инструмент умеет работать с разными путями ввода-вывода. Сам факт его запуска не доказывает применение прямого пути от накопителя в память ускорителя без промежуточных операций.
NVIDIA отдельно указывает, что DGX Spark не поддерживает GPUDirect RDMA для памяти, выделенной соответствующими устройственными распределителями CUDA. Для некоторых приложений требуются сетевые буферы другого типа и подходящий резервный путь передачи. Сетевой обмен с RDMA через ConnectX-7 и прямой доступ сетевого адаптера к памяти CUDA — разные возможности, которые нельзя объединять в одно обещание «поддержки GPUDirect».
Встроенный накопитель 4 Тбайт
В опубликованном тесте встроенный накопитель показал около 11,4 ГиБ/с при последовательном чтении блоками 1 МиБ с 16 потоками. При записи выделялась точка с блоками 32 КиБ и 128 потоками; для ряда крупных блоков наблюдался уровень около 8,3 ГиБ/с. Полные зависимости приведены на тепловых картах.
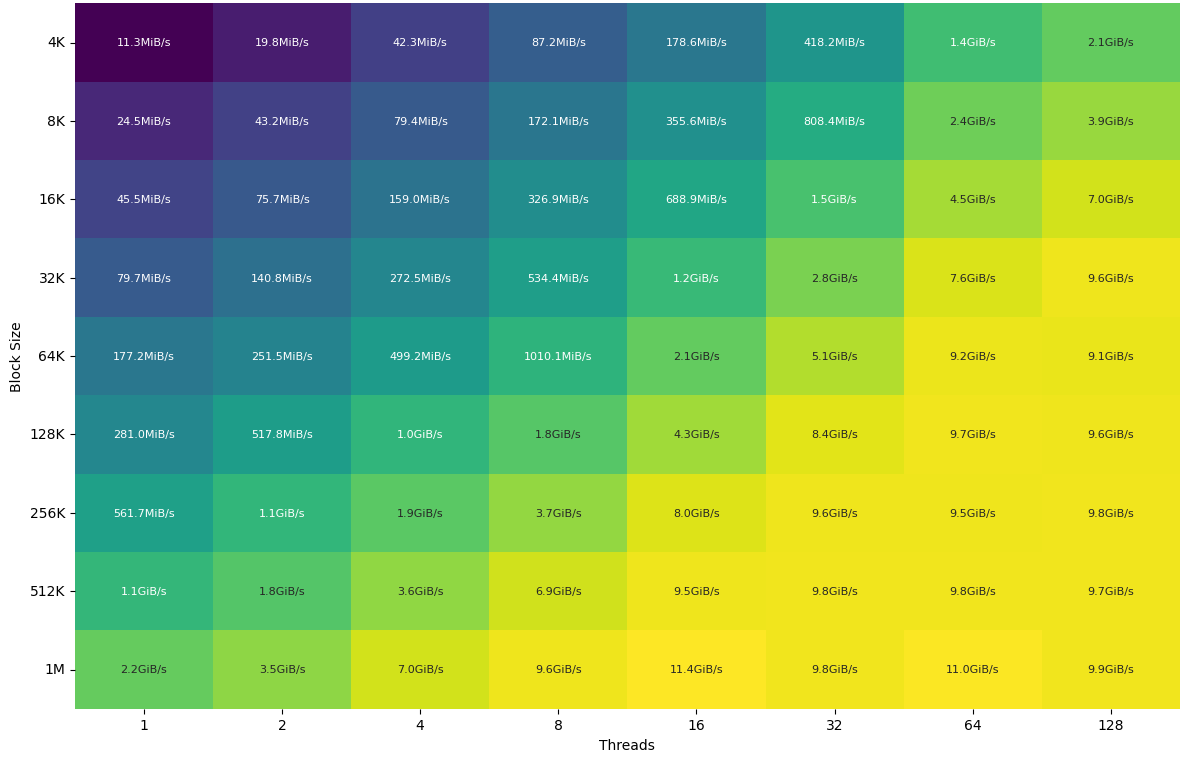
Встроенный SSD 4 Тбайт: последовательное чтение, размер блока по вертикали и число потоков по горизонтали.
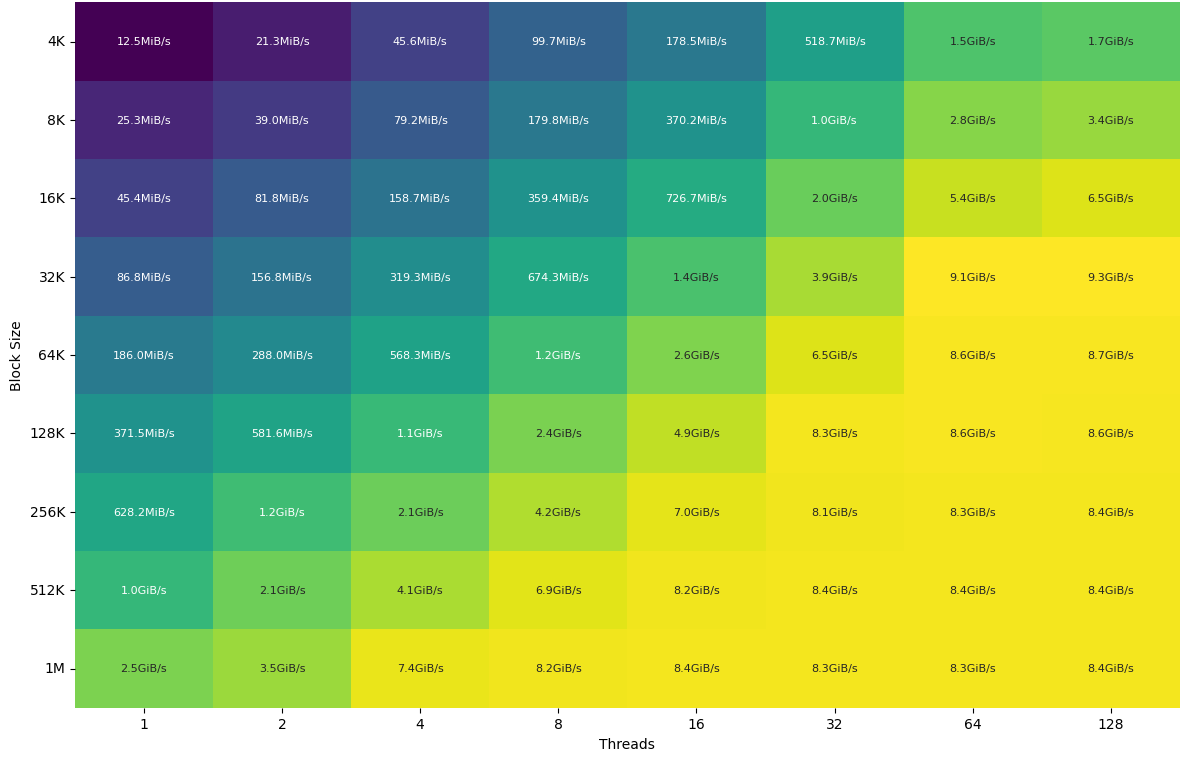
Встроенный SSD 4 Тбайт: последовательная запись. Единицы указаны в подписях ячеек.
В той же ранней конфигурации при увеличении тестового набора до 128 Гбайт или 1 Тбайт наблюдались зависания с необходимостью восстановления системы; уменьшение набора до 64 Гбайт и ограничение числа потоков позволили продолжить измерения. Эти наблюдения относятся к конкретному образцу и программной среде. Для новой поставки важно отдельно проверить устойчивость длительной записи, работу при заполнении накопителя и сохранение контрольных точек обучения.
Внешние накопители через ConnectX-7
Внешний накопительный узел в испытаниях был построен на Dell PowerEdge R770 с шестью Micron 9550 по 3,84 Тбайт и программным обеспечением PEAK:AIO. Доступ организован по NVMe over Fabrics с RDMA. Такой сценарий интересен для централизованного хранения наборов данных и моделей, особенно когда нескольким вычислительным узлам нужен доступ к общему массиву.
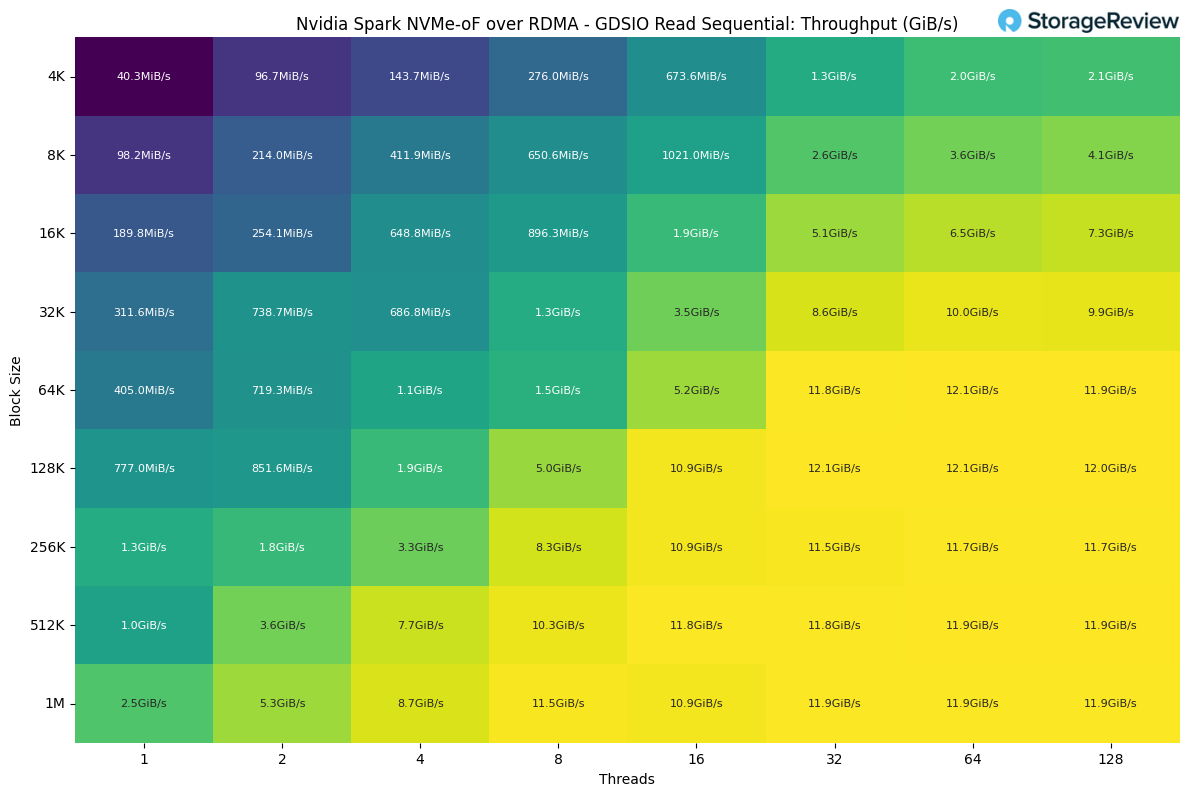
Внешнее хранилище NVMe-oF: опубликованная диаграмма последовательного чтения. Ограничение интерпретации скорости сети пояснено ниже.
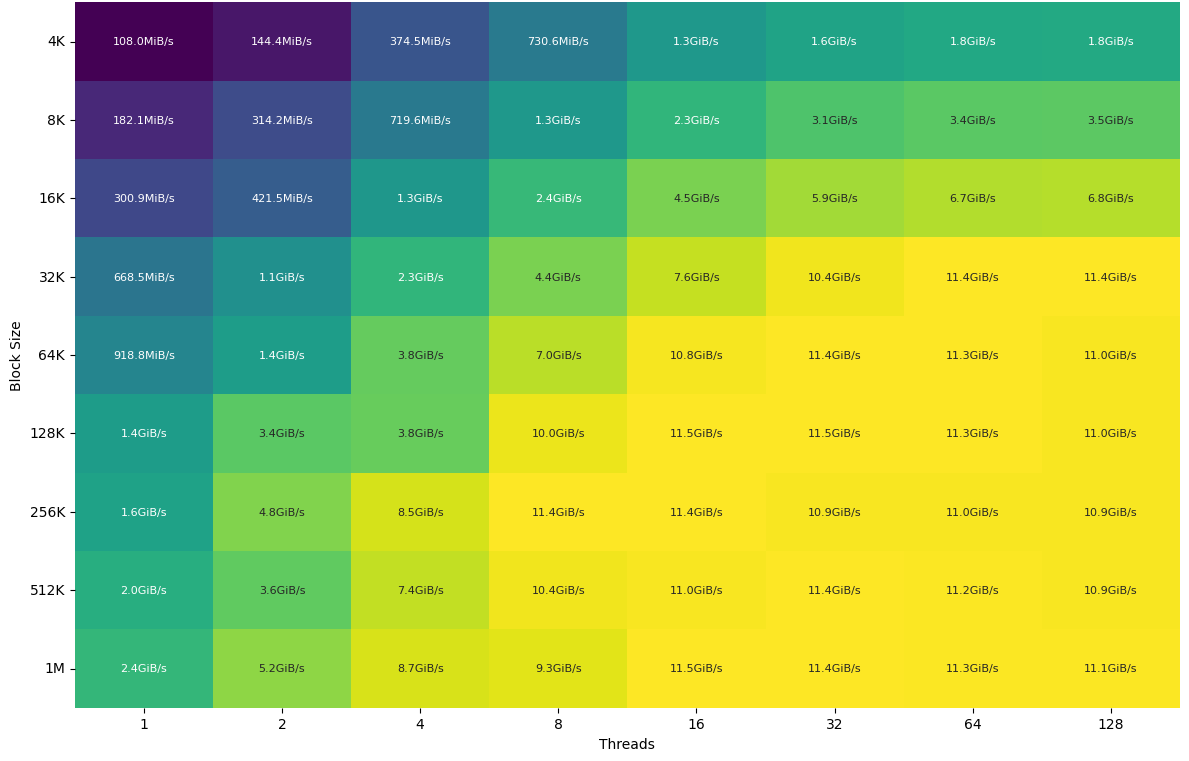
Внешнее хранилище NVMe-oF: опубликованная диаграмма последовательной записи.
|
Сценарий
|
Показатель gdsio
|
Размер блока и потоки
|
Примечание
|
|
Встроенный SSD, чтение
|
11,4 ГиБ/с
|
1 МиБ, 16 потоков
|
Точка на тепловой карте встроенного накопителя
|
|
Встроенный SSD, запись
|
9,3 ГиБ/с
|
32 КиБ, 128 потоков
|
Максимальная подпись на карте; для крупных блоков многие точки лежат около 8,3–8,7 ГиБ/с
|
|
Внешнее хранение, чтение
|
12,1 ГиБ/с
|
128 КиБ, 32 потока
|
Есть расхождение с указанной в описании скоростью сети; см. пояснение
|
|
Внешнее хранение, запись
|
11,5 ГиБ/с
|
128 КиБ, 16 потоков
|
Значение по подписи диаграммы; та же оценка есть и в других точках
|
Для внешнего теста соединение описано как 100 Гбит/с, тогда как на диаграмме чтения указано до 12,1 ГиБ/с. Один канал 100 Гбит/с теоретически передает не более примерно 11,64 ГиБ/с еще до учета протокольных расходов. Поэтому опубликованное число нельзя считать подтвержденной скоростью одного такого канала без уточнения топологии, единиц и исходных журналов. Диаграммы сохранены с исходными обозначениями.
Выбор внешнего хранения должен учитывать не только пиковую скорость. Существенны время загрузки модели, скорость сохранения контрольной точки, параллельный доступ сотрудников и восстановление после сбоя. Сетевое хранилище может решить задачу емкости и совместного доступа, но добавляет собственные требования к сети, администрированию и бюджету проекта.
Что изменилось после обновлений CES 2026
В январе 2026 года развитие DGX Spark было связано прежде всего с программными оптимизациями: новыми версиями средств выполнения моделей, поддержкой форматов пониженной разрядности и готовыми сценариями запуска. Аппаратная основа рассматриваемой системы при этом оставалась прежней. Поэтому эти изменения важны для оценки жизненного цикла платформы, но их нельзя автоматически прибавлять к каждому значению октябрьских графиков.
Что означает ускорение до 2,5 раза
В сводной демонстрации NVIDIA приводила ускорение до 2,5 раза относительно программного стека на момент начала продаж. Наиболее заметный пример связан с Qwen-235B: в нем одновременно меняются представление модели, способ декодирования и версия TensorRT-LLM. Это сравнение рабочих конфигураций, а не изолированный эффект обновления драйвера.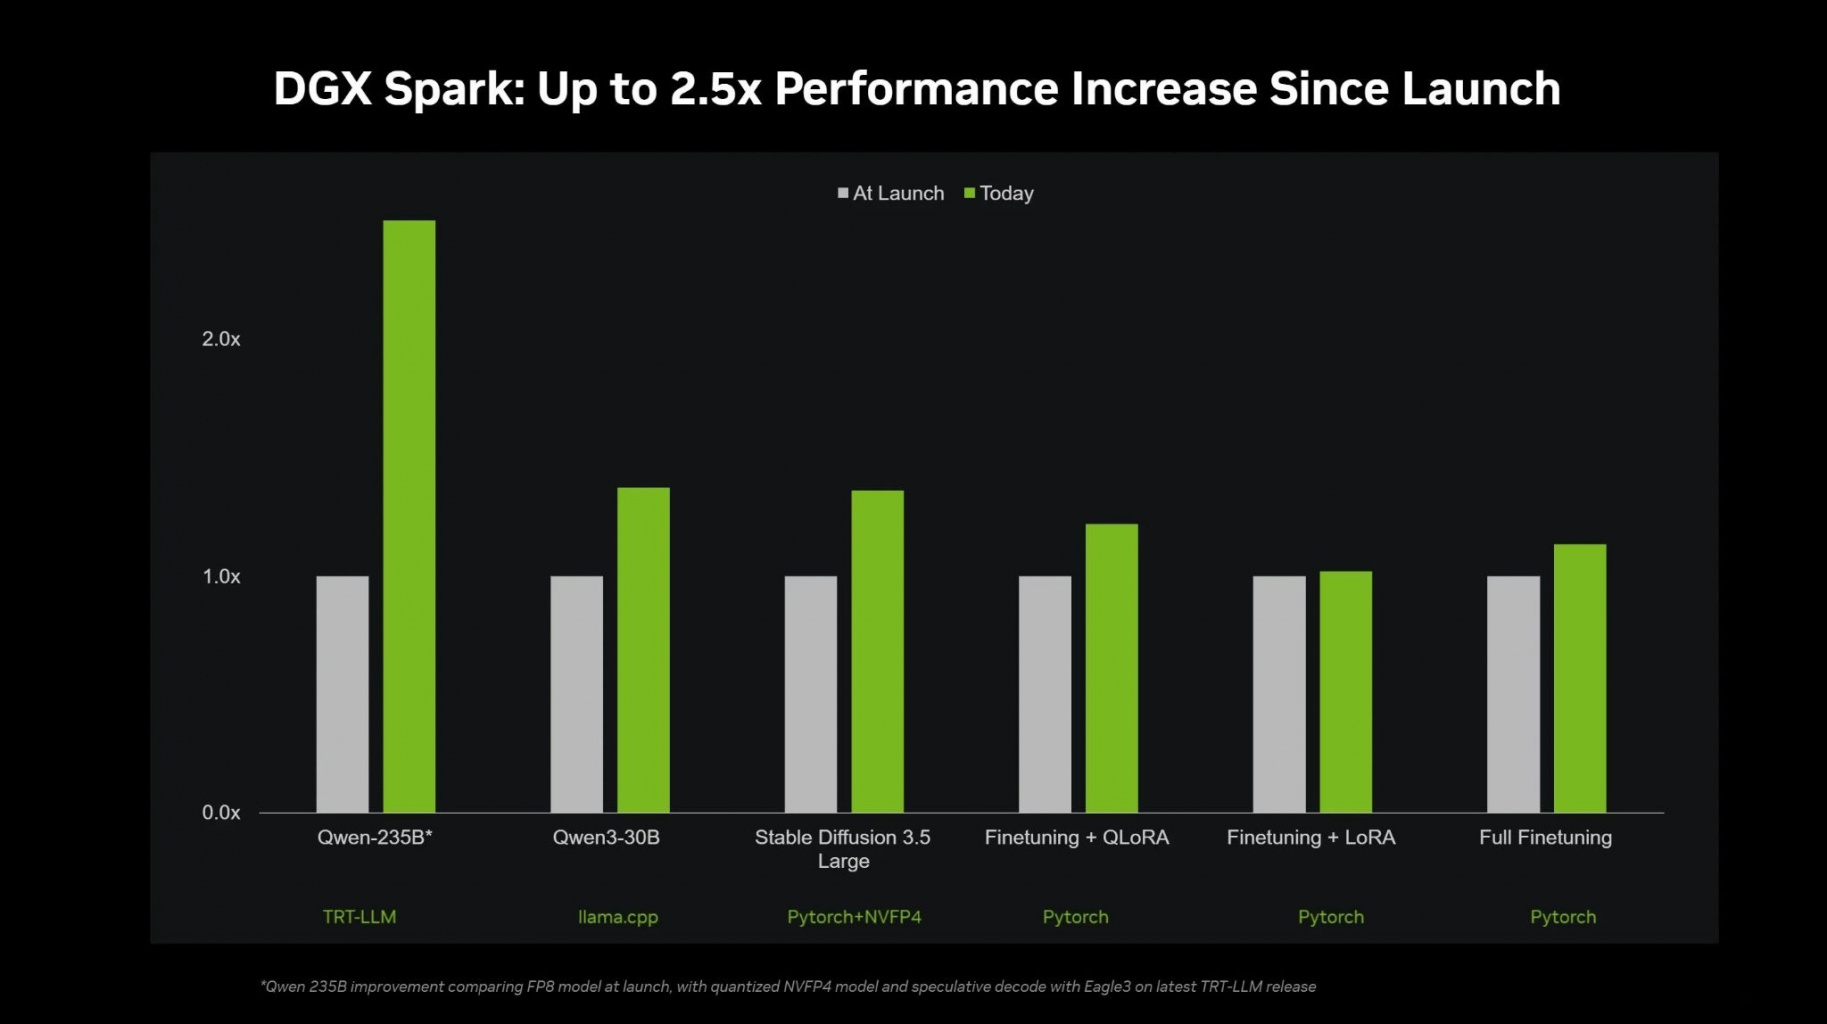
Сводное сравнение NVIDIA на CES 2026. Столбцы отражают разные сценарии; максимальный множитель нельзя переносить на все задачи.
В техническом описании NVIDIA для двух Spark указан отдельный результат до 2,6 раза при переходе с FP8 на NVFP4 со спекулятивным декодированием. Уменьшение памяти примерно на 40% в этом примере освобождало ресурсы и меняло условия выполнения. Такие числа относятся к заданной модели и настройкам; для корпоративного приложения дополнительно проверяют качество ответа и задержки.
Спекулятивное декодирование ускоряет генерацию за счет предварительного предложения нескольких токенов и их последующей проверки основной моделью. Его полезность зависит от доли принятых предложений и накладных расходов. Поэтому наличие поддержки метода в программном стеке еще не определяет величину выигрыша на конкретных запросах компании.
|
Нагрузка
|
Использованный стек
|
Характер изменения
|
Как интерпретировать
|
|
Qwen-235B
|
TensorRT-LLM
|
На сводном графике — до 2,5×
|
Переход с FP8 на NVFP4 и спекулятивное декодирование; в техническом примере двух систем указано до 2,6×
|
|
Qwen3-30B
|
llama.cpp
|
Около 1,4× по сводному графику
|
Программная оптимизация конкретного сценария; отдельные точные значения даны ниже
|
|
Stable Diffusion 3.5 Large
|
PyTorch и NVFP4
|
Около 1,4× по сводному графику
|
Результат относится к выбранному представлению модели и рабочей последовательности
|
|
Дообучение с QLoRA
|
PyTorch
|
Умеренный прирост
|
Величина зависит от рецепта обучения
|
|
Дообучение с LoRA
|
PyTorch
|
Небольшой прирост
|
Не следует приписывать ему максимальное ускорение всей демонстрации
|
|
Полное дообучение
|
PyTorch
|
Умеренный прирост
|
Самостоятельный сценарий со своими требованиями к памяти
|
Обновления llama.cpp
Для llama.cpp NVIDIA опубликовала отдельное сравнение октября 2025 года и января 2026 года. Измерения выполнены инструментом llama-cli с входом 100 токенов и выходом 200 токенов. Условия отличаются от тестов обслуживания запросов через vLLM, поэтому численные значения этих двух наборов не следует сопоставлять как прямое соревнование программ.
|
Модель
|
15 октября 2025 года
|
Январь 2026 года
|
|
GPT-OSS-20B
|
64
|
85
|
|
GPT-OSS-120B
|
33
|
55
|
|
Nemotron Nano V2
|
29
|
33
|
|
Qwen 3 30B
|
66
|
90
|
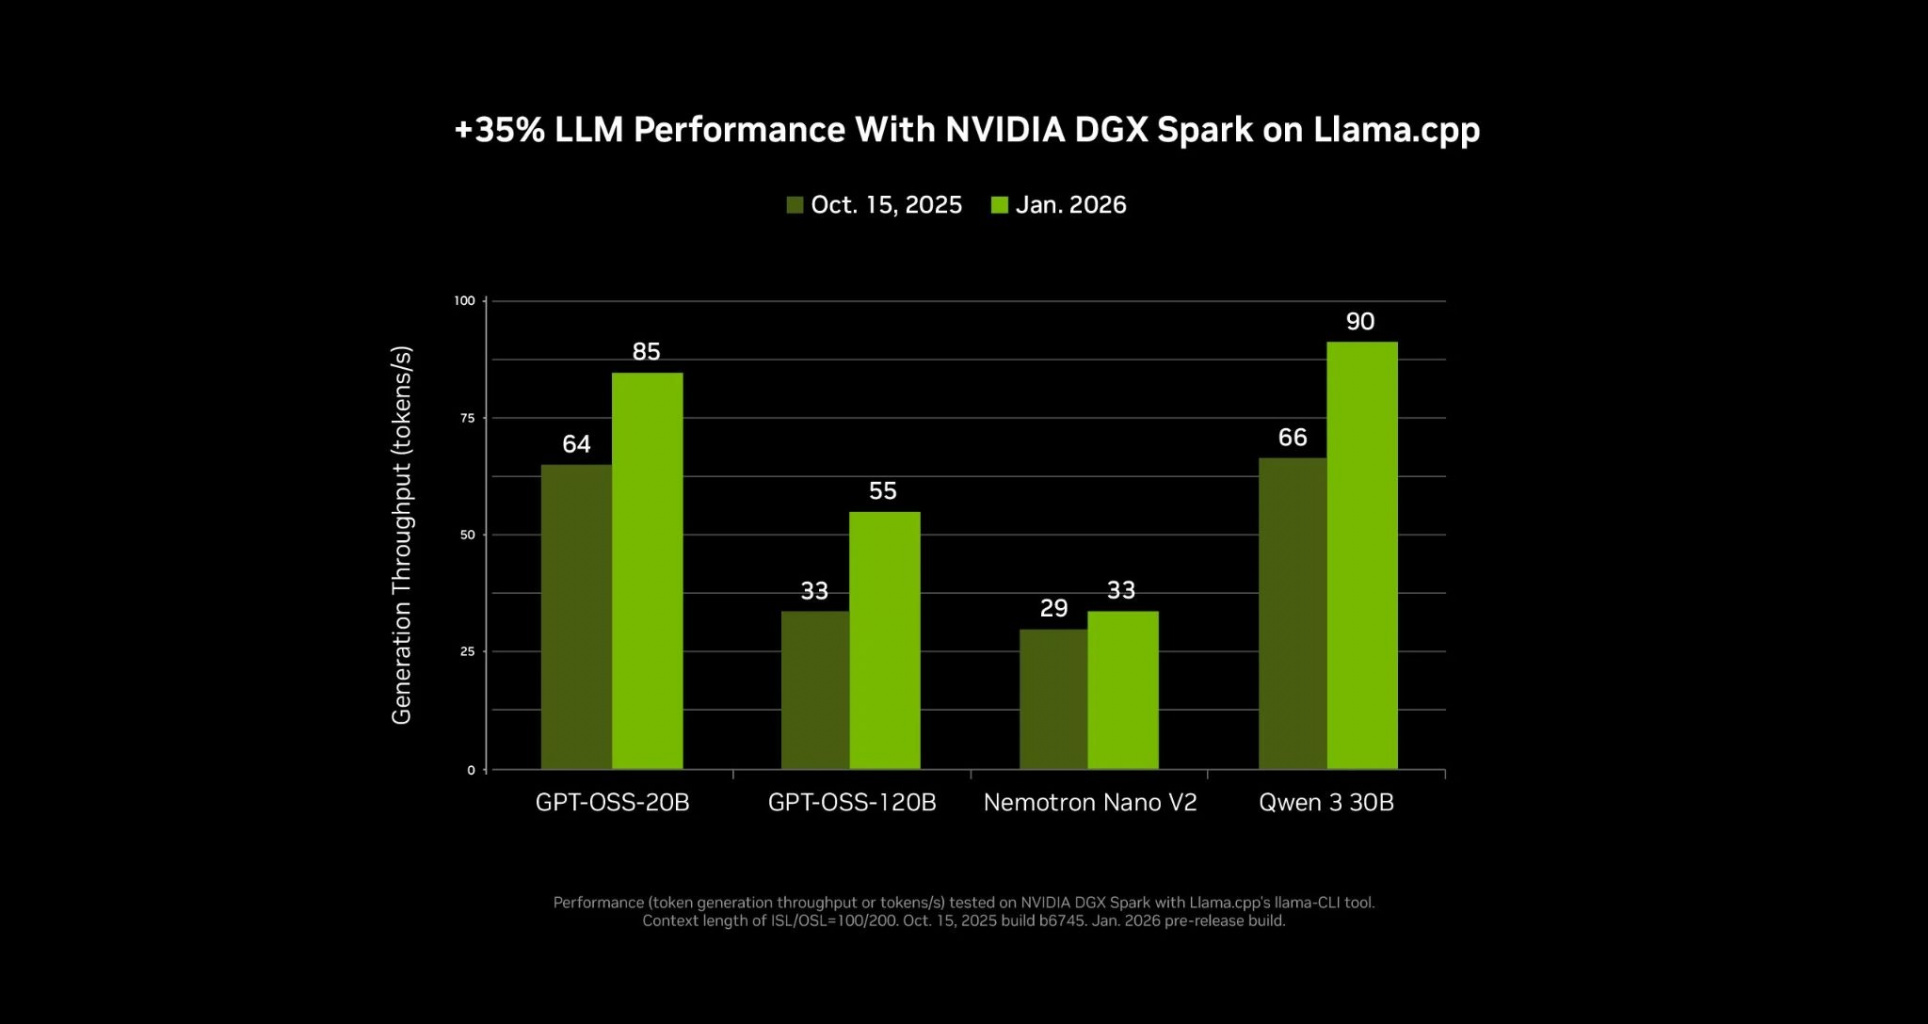
Практический вывод для сопровождения прост: версия среды выполнения является частью производительности устройства. Команде полезно иметь контрольные запросы и повторять их после обновления. Тогда можно отделить реальное сокращение времени работы от изменений формата модели, длины генерации и других настроек.
Откуда взялось восьмикратное ускорение видео
Восьмикратное ускорение относится к другой демонстрации: тяжелые этапы генерации видео переносились с MacBook Pro M4 Max на DGX Spark. В описанном сценарии время уменьшалось примерно с восьми минут до одной. Это сравнение ноутбука с рабочим процессом, дополненным отдельным вычислительным устройством, а не восьмикратное ускорение Spark после обновления.
Для подразделения, создающего визуальные материалы, такой подход интересен разделением работы: интерфейс и редактирование остаются на основном компьютере, генерация выполняется отдельно. Для оценки эффекта нужно воспроизвести всю последовательность с выбранными моделями, разрешением и улучшением видео. Время передачи файлов и промежуточные операции также входят в пользовательское ожидание.
Локальные помощники, трехмерные материалы и новые модели
Обновление экосистемы включало новые сценарии для моделей Nemotron, мультимодального анализа, дообучения и ИИ-агентов. На CES также показывали локального помощника разработчика CUDA на базе NVIDIA Nsight. Для корпоративной команды это возможность экспериментировать с генерацией и оптимизацией кода в собственном контуре, проверяя предлагаемые изменения привычными средствами тестирования и профилирования.
В творческих процессах рассматривалась и фоновая подготовка материалов для RTX Remix: Spark выполняет генеративные операции, пока основная графическая станция продолжает обслуживать интерактивную сцену. Принцип применим шире одной демонстрации — выделенный локальный узел можно включить в очередь задач подготовки изображений, текстур и других производных материалов.
Для дообучения на двух системах в январских сценариях описывалась работа с моделями до 70B через распределенное выполнение и LoRA. При чтении таких заявлений важно сохранять название метода: дообучение адаптеров большой модели и полное обновление всех ее параметров требуют разных объемов памяти и вычислений.
Две системы Spark и варианты партнеров
Что дает объединение двух устройств
Два Spark с 128 Гбайт памяти каждый дают 256 Гбайт суммарной физической памяти узлов. Соединение ConnectX-7 позволяет использовать распределенные реализации, которые делят модель или вычисления между устройствами. Это расширяет диапазон доступных экспериментов с крупными моделями.
Память двух устройств при этом не становится единым локальным пулом одного ускорителя. Распределенная программа должна учитывать обмен по сети, а масштабирование зависит от способа разделения модели и конкретных операций. Увеличение суммарной емкости само по себе не гарантирует удвоение скорости. Для пилота нужно измерять время задачи и устойчивость выбранной реализации на двух узлах.
Отдельно стоит оценить влияние сети на бюджет. Помимо второго устройства могут потребоваться подходящие кабели, коммутатор или отдельные сетевые настройки, дополнительное хранение и сопровождение. Если задача регулярно выходит за пределы компактного двухузлового стенда, варианты дальнейшего развития сравнивают с серверной платформой и облачными ресурсами по одинаковым требованиям к работе приложения.
При переходе к серверной инфраструктуре производительность зависит и от согласованной настройки процессоров, памяти, ускорителей и операционной системы. Влияние топологии оборудования, параметров BIOS и размещения нагрузки рассматриваем в статье об оптимизации ИИ-серверов Dell PowerEdge с AMD EPYC.
NVIDIA также описывает четырёхузловую конфигурацию DGX Spark с суммарными 512 Гбайт памяти. Для неё требуется совместимая сетевая инфраструктура. Это не единый пул локальной GPU-памяти: эффективность масштабирования определяется распределённой реализацией модели и затратами на межузловой обмен.
Системы на GB10 у производителей рабочих станций
Аппаратная платформа GB10 используется и в партнерских устройствах, включая Dell Pro Max с GB10, Lenovo ThinkStation PGX, ASUS Ascent GX10 и Acer Veriton GN100. Они относятся к тому же классу компактных систем для локального ИИ, но условия поставки, накопители, охлаждение и сопровождение сравнивают по конкретной модели.
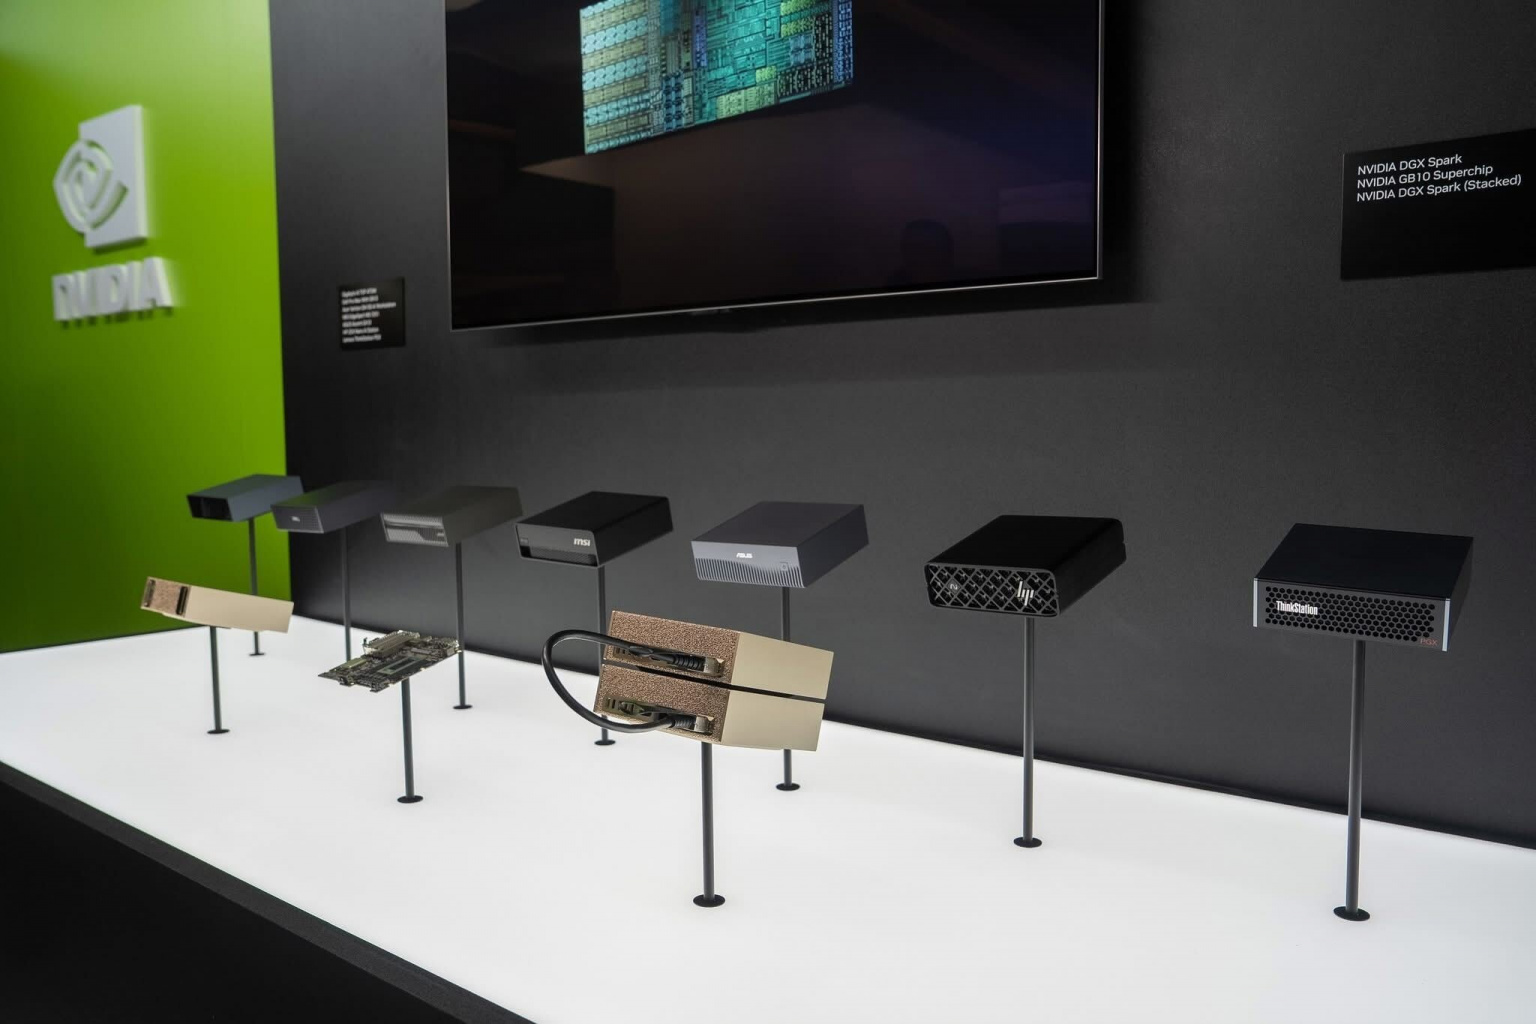
При корпоративной закупке полезно заранее выбрать, что важнее для эксплуатации: единый производитель рабочих мест, принятый сервисный контракт, стандартный образ системы или определенная аппаратная комплектация. Результаты одной протестированной системы не следует автоматически переносить на все устройства с тем же процессором без проверки их настроек и ограничений.
Как оценить экономику и выбрать конфигурацию
Сравнивать завершенную задачу и занятость команды
Экономический эффект локального узла складывается из стоимости оборудования и того, как меняется работа сотрудников. Для постоянно повторяющихся экспериментов могут быть важны доступность среды, отсутствие очереди на общие ускорители и возможность быстро повторить запуск. Для редких тяжелых расчетов большее значение может иметь время выполнения на более мощном ресурсе.
Сравнение удобно строить по одному проекту и выбранному периоду эксплуатации. В локальном варианте учитывают устройство, поддержку, программные права, хранение, сеть, электроэнергию и труд администратора. В облачном — вычисления, хранение, передачу данных и время подготовки окружения. При этом стоимость рабочего часа разработчика и задержка получения результата могут оказаться существеннее разницы в расходе электроэнергии.
Историческую стартовую цену из обзора 2025 года не стоит подставлять в текущий расчет окупаемости. Для проекта нужны действующая стоимость конкретной комплектации, условия сопровождения и реальная доступность нужного программного стека. Этот подход позволяет сравнивать варианты в одинаковых коммерческих условиях.
Что проверить в пилоте
До закупки нескольких устройств стоит провести прикладной пилот на одной системе или на планируемой паре узлов. Мы рекомендуем зафиксировать модель и ее контрольную точку, рабочую последовательность действий и измеримые критерии приемки. Тогда результаты испытаний будут связаны с задачей компании, а не только с удачно выбранным общим показателем.
|
Проверка
|
Что фиксировать
|
Зачем это нужно
|
|
Качество
|
Результаты на собственном контрольном наборе, ошибки, корректность ссылок и форматов
|
Подтвердить пригодность модели, в том числе после квантизации
|
|
Задержки
|
Время первого ответа, скорость продолжения, полное время задачи
|
Оценить опыт сотрудника и выполнение требований приложения
|
|
Параллельная работа
|
Число активных запросов и фоновых заданий при приемлемом отклике
|
Настроить очереди и определить допустимое число пользователей
|
|
Память
|
Занятость при загрузке, длинном контексте, обучении и нескольких компонентах
|
Сохранить запас и избежать остановок из-за нехватки ресурсов
|
|
Хранение и сеть
|
Загрузка моделей, чтение наборов данных, сохранение и восстановление результатов
|
Проверить весь путь данных
|
|
Длительный прогон
|
Стабильность, температура, фактическая мощность и ошибки
|
Оценить устойчивость рабочего режима
|
|
Совместимость
|
Arm-сборки, версии контейнеров, зависимости и интеграции
|
Рассчитать трудоемкость внедрения и поддержки
|
|
Восстановление
|
Резервные копии, восстановление окружения и настройки приложения
|
Определить поведение при отказе или неудачном обновлении
|
Для помощника разработчика пилот должен включать работу с реальными размерами репозитория и несколькими параллельными задачами. Для поиска по документам — полную цепочку от загрузки файла до ответа с нужным источником. Для генерации визуальных материалов — итоговое разрешение и все дополнительные модели. Так становится понятен объем памяти, который нужно оставить свободным, и допустимое число одновременно выполняемых заданий.
По результатам пилота можно выбрать роль системы: персональный исследовательский узел, общий ресурс небольшой команды, дополнительный вычислитель для рабочих станций или часть распределенного стенда. У каждого варианта свой режим загрузки и сопровождения. Единая исходная платформа при этом не отменяет необходимости настроить приложение под выбранную роль.
Вывод: когда DGX Spark оправдан для компании
NVIDIA DGX Spark представляет интерес там, где команде нужен постоянно доступный локальный ресурс для работы с моделями и данными, а полный серверный контур пока не соответствует масштабу проекта. Большой общий объем памяти, компактное исполнение и программная экосистема позволяют проводить эксперименты с языковыми моделями, дообучением, аналитикой и генеративными рабочими процессами на выделенном устройстве.
При этом сильные стороны платформы нужно рассматривать вместе с ее ограничениями. Общая память имеет собственную пропускную способность и используется всей системой. Скорость зависит от квантизации, характера запросов и среды выполнения. Arm требует проверки совместимости программ, а внешнее хранение и объединение узлов — понимания сетевой топологии и поддерживаемых путей передачи данных. Эти факторы определяют, насколько хорошо устройство подойдет конкретному приложению.
Результаты октябрьских испытаний дают исходный ориентир, а обновления CES 2026 показывают значимость программного стека для одной и той же аппаратной платформы. Заявления об ускорении до 2,5 раза и восьмикратном выигрыше видео относятся к разным сравнениям. Для закупочного решения важнее воспроизвести нужную задачу и убедиться, что система обеспечивает приемлемое качество, время ответа и устойчивую работу при ожидаемой загрузке.
Для бизнеса разумная последовательность — определить полезный результат, выбрать модель и рабочий процесс, провести измерения и только затем рассчитывать масштабирование. Если Spark сокращает время эксперимента, освобождает рабочие станции и дает команде контролируемую среду, его ценность выходит за пределы характеристик одного ускорителя. Если же основной приоритет — длительная работа с высокой общей нагрузкой и строгими требованиями к доступности, проект стоит сразу оценивать в составе более широкой вычислительной инфраструктуры.
При выборе ИИ-платформы мы рекомендуем связывать оборудование, программную среду и эксплуатацию в одном проекте. Такой подход помогает заранее понять стоимость завершенной работы, пределы роста и условия поддержки. DGX Spark в этом случае становится инструментом решения определенной задачи компании — с понятной ролью, измеримыми результатами и обоснованным бюджетом.
Когда пилот переходит в постоянно работающий корпоративный сервис, следующим шагом может стать выбор сервера с ускорителями NVIDIA. Конфигурацию подбирают по используемым моделям, числу одновременных запросов и требованиям к доступности, учитывая результаты пилота и ожидаемый рост нагрузки.
Автор:
Команда пресейла ITELON
Источник:
StorageReview, Nvidia, ITELON
Скопировать ссылку
Ссылка
Добавить в закладки
В закладки
Оцените статью и добавьте комментарий
— будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет
опубликован в ближайшее время!








Оцените статью и добавьте комментарий — будьте первым
Спасибо!
Комментарий успешно отправлен на модерацию! После модерации комментарий будет опубликован в ближайшее время!